Chapter 29: Transformers aur Attention Mechanism
MODULE 8 | WEEK 29
Chapter 29: Transformers aur Attention Mechanism
Ab hum us technology ki bunyad dekhte hain jis par ChatGPT, Gemini, Claude, Llama jaise sab bade AI models bane hain: yani Transformer . Module 5 me tumne RNN aur LSTM dekhe jo text ko ek ek lafz karke parhte hain. Transformer ne ye tareeqa badal diya: wo poore jumle ko ek sath dekhta hai aur har lafz khud faisla karta hai ke jumle ke kis kis lafz par dhyan (attention) dena hai . Is chapter me hum Self-Attention, Multi-Head Attention aur Positional Encoding ko pehle NumPy se hath se banayenge taake jadoo samajh aaye, phir Keras me chhota Transformer banayenge.
29.1 RNN se Transformer tak
Chapter 25 me dekha tha ke RNN/LSTM text ko ek ek token karke parhte hain aur apni yaaddasht (hidden state) aage barhate jate hain. Is tareeqe ke teen bade masail hain:
-
Sust training: pehle token ka hisaab hone tak doosra token shuru nahi ho sakta, isliye GPU ki poori taqat istemal nahi hoti.
-
Door ke lafz bhool jana: jumla lamba ho to shuru ki baat aakhir tak pohanchte pohanchte kamzor ho jati hai.
-
Ek hi yaaddasht me sab kuch: poore jumle ka matlab ek chhote se vector me thoosna parta hai.
29.2 Text ko numbers me: Tokens aur Embeddings
Neural network sirf numbers samajhta hai, isliye text ko do qadam me numbers banate hain:
-
Tokenization: text ko tukron ( tokens ) me torna aur har token ko ek id (integer) dena.
-
Embedding: har id ko ek vector (numbers ki list) se badalna jo token ka "matlab" pakarta hai. Vector ki lambai ko d_model kehte hain.
Abhi hum sirf lafzon ko tokens maan lete hain (asli tokenization Chapter 30 me). Embedding matrix ek bara table hai jis ki har row ek token ka vector hai, aur training me ye vectors seekhe jate hain:
import numpy as np
sentence = "ali ne sara ko kitab di".split()
vocab = {w: i for i, w in enumerate(sorted(set(sentence)))}
ids = [vocab[w] for w in sentence]
d_model = 8 np.random.seed(1)
E = np.random.randn(len(vocab), d_model)      # embedding table:
(vocab, d_model)
X = E[ids]                                    # har token ka vector
print("Vocab:", vocab)
print("Token ids:", ids)
print("Embedding table shape:", E.shape)
print("X shape (tokens, d_model):", X.shape)
OUTPUT Vocab: {'ali': 0, 'di': 1, 'kitab': 2, 'ko': 3, 'ne': 4, 'sara': 5} Token ids: [0, 4, 5, 3, 2, 1] Embedding table shape: (6, 8) X shape (tokens, d_model): (6, 8)
29.3 Attention ka idea: Query, Key aur Value
Attention ko samajhne ka sab se aasan tareeqa ek soft dictionary hai. Normal Python dictionary me tum ek exact key se ek value nikalti ho. Attention me tum Query deti ho, wo har Key se milti hai, aur nateeja sab Values ka milawat hota hai: jis Key se zyada milan, uski Value ka zyada hissa.
29.4 Scaled Dot-Product Attention
Ab ye idea poore jumle par ek sath lagate hain. Agar jumle me n tokens hain to Q, K, V teeno (n, d_k) shape ke matrix hain, aur formula ye hai:
Attention(Q, K, V) = softmax( Q @ K.T / sqrt(d_k) ) @ V
-
Q @ K.T : shape (n, n) . Har token ka har doosre token se score.
-
/ sqrt(d_k) : scores ko chhota karna (neeche wajah dekho).
-
softmax : har row ke weights banata hai (har row ka jama 1).
-
@ V : weights se Values ka milawat, output shape (n, d_k) .
sqrt(d_k) se kyun bhaag dete hain?
Jab d_k bara ho to dot products ka spread (std) sqrt(d_k) ke barabar barh jata hai, yani numbers bohat bare ho jate hain, softmax ek hi token par 1.0 de deta hai aur baaki sab ko 0 (aur learning ruk jati hai). sqrt(d_k) se bhaag kar scores ko theek range me rakhte hain. Khud dekho:
import numpy as np
np.random.seed(0)
def softmax(z):
    e = np.exp(z - z.max(axis=-1, keepdims=True))
    return e / e.sum(axis=-1, keepdims=True)
for d_k in [4, 64, 512]:
    q = np.random.randn(2000, d_k)
    k = np.random.randn(2000, d_k)
    dots = (q * k).sum(axis=1)                  # 2000 dot products ka spread
    keys = np.random.randn(6, d_k)
    query = np.random.randn(d_k)
    raw = keys @ query                          # 6 keys ke scores
    big_raw = softmax(raw).max()                # sab se bara weight (bina scaling)
    big_scaled = softmax(raw / np.sqrt(d_k)).max()
    print(f"d_k={d_k:3d} | dot std={dots.std():5.1f} (sqrt(d_k)={np.sqrt(d_k):4.1f})" f" | bara weight: raw={big_raw:.3f}, scaled={big_scaled:.3f}")
OUTPUT
d_k=  4 | dot
std=  2.0
(sqrt(d_k)= 2.0) | bara weight:
raw=0.364, scaled=0.269
d_k= 64 | dot
std=  8.0
(sqrt(d_k)= 8.0) | bara weight:
raw=0.527, scaled=0.310
d_k=512 | dot
std= 22.8
(sqrt(d_k)=22.6) | bara weight:
raw=0.995, scaled=0.373
29.5 Self-Attention: jumla khud se baat karta hai
Self-Attention me Q, K, V ek hi input X se bante hain. Yani jumle ka har token usi jumle ke baaqi tokens (aur khud) ko dekhta hai. Teen seekhne wale weight matrices ( Wq, Wk, Wv ) X ko Q, K, V me badalte hain:
Q = X @ Wq
K = X @ Wk
V = X @ Wv      (Wq, Wk, Wv: (d_model, d_k))
np.random.seed(3)
tokens = ["ali", "ne", "sara", "ko", "kitab", "di"]
n, d_model, d_k = len(tokens), 8, 4
X  = np.random.randn(n, d_model)               # embeddings
Wq = np.random.randn(d_model, d_k)
Wk = np.random.randn(d_model, d_k)
Wv = np.random.randn(d_model, d_k)
Q, K, V = X @ Wq, X @ Wk, X @ Wv
out, weights = attention(Q, K, V)
print("X:", X.shape, "| Q, K, V:", Q.shape, "| output:", out.shape)
print()
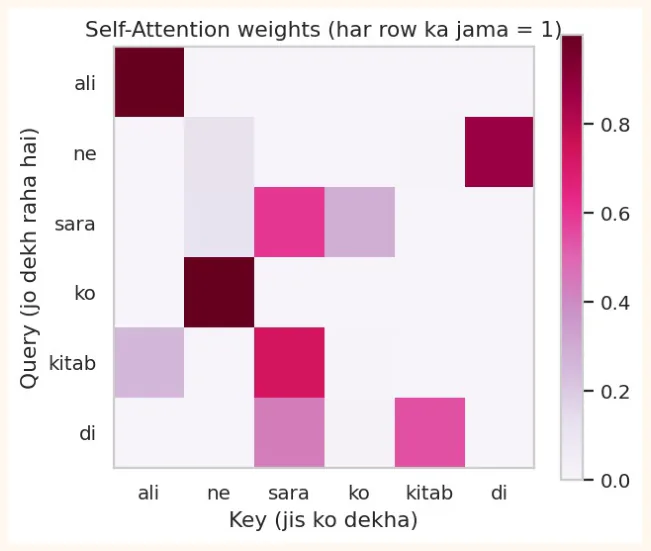
print("'sara' ka dhyan (attention weights):")
for tok, w in zip(tokens, weights[2]):
    print(f"  {tok:6s} {w:.3f}")
OUTPUT X: (6, 8) | Q, K, V: (6, 4) | output: (6, 4) 'sara' ka dhyan (attention weights): ali 0.000 ne 0.111 sara 0.597 ko 0.291 kitab 0.001 di 0.001
OUTPUT (chart)
29.6 Multi-Head Attention
Ek attention "head" jumle ke tokens ka ek hi qism ka rishta pakarta hai. Lekin jumle me kai rishte hote hain: grammar, matlab, kaun kis ko refer kar raha hai. Multi-Head Attention me kai heads parallel chalte hain, har head ko X ka alag nazariya milta hai, aur aakhir me sab ke nateeje jor (concatenate) diye jate hain.
29.7 Positional Encoding: tartib ka ilm
Attention ka ek aham masla hai: wo tokens ki tartib (order) nahi jaanta. "Ali ne Sara ko dekha" aur "Sara ne Ali ko dekha" ke tokens wohi hain, magar matlab ulta. RNN me tartib khud ba khud thi (ek ek karke parhna). Transformer me ye khud saabit karte hain:
np.random.seed(5)
n, d_model, d_k = 5, 8, 4
X = np.random.randn(n, d_model)
Wq, Wk, Wv = [np.random.randn(d_model, d_k) for _ in range(3)]
def self_attn(X):
    return attention(X @ Wq, X @ Wk, X @ Wv)[0]
perm = [3, 0, 4, 1, 2]                     # tokens ki tartib badal do
out_original = self_attn(X)
out_shuffled = self_attn(X[perm])
print("Shuffled output = original output ki wohi rows (shuffled)?", np.allclose(out_shuffled, out_original[perm]))
OUTPUT
Shuffled output = original output ki wohi rows (shuffled)? True
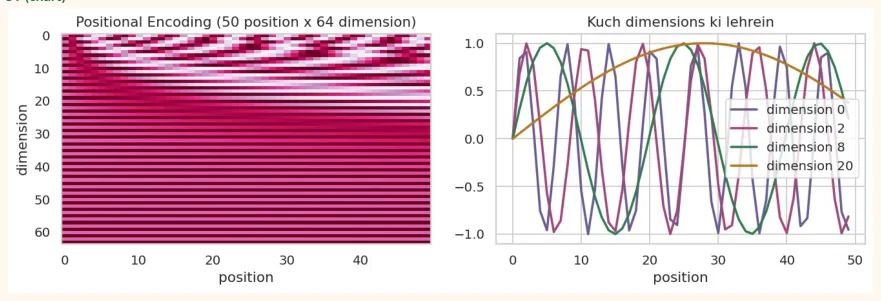
True ka matlab: tartib badalne se har token ka output wohi raha, sirf jagah badli. Yani attention ko pata hi nahi ke kaun sa token pehle aaya. Hal: har token ke embedding me position ki maloomat jama kar do. Original Transformer me ye sin aur cos ki lehron se hoti hai:
PE(pos, 2i)   = sin( pos / 10000^(2i / d_model) )
PE(pos, 2i+1) = cos( pos / 10000^(2i / d_model) )
def positional_encoding(n_positions, d_model):
pos = np.arange(n_positions)[:, None]               # (n, 1)
i = np.arange(d_model // 2)[None, :]                # (1, d_model/2)
angle = pos / (10000 ** (2 * i / d_model))
PE = np.zeros((n_positions, d_model)) PE[:, 0::2] = np.sin(angle)                         # even dimensions PE[:, 1::2] = np.cos(angle)                         # odd dimensions return PE
PE = positional_encoding(50, 64)
print("PE shape:", PE.shape)
print("Position 0 ke pehle 6 numbers:", PE[0, :6].round(2))
print("Position 1 ke pehle 6 numbers:", PE[1, :6].round(2)) # ab X me position jodo aur dobara shuffle test karo
PE_n = positional_encoding(n, d_model)
out_a = self_attn(X + PE_n)              # asli tartib
out_b = self_attn(X[perm] + PE_n)        # tokens shuffle, position 0..n-1 wohi
print("Ab bhi sirf shuffle? ", np.allclose(out_b, out_a[perm]))
OUTPUT PE shape: (50, 64) Position 0 ke pehle 6 numbers: [0. 1. 0. 1. 0. 1.] Position 1 ke pehle 6 numbers: [0.84 0.54 0.68 0.73 0.53 0.85] Ab bhi sirf shuffle? False
Jab position jod di to ab shuffle karne se wohi output nahi aata (False): model ab tartib mehsoos karta hai. Heatmap me har position ka alag "fingerprint" nazar aata hai:
fig, axes = plt.subplots(1, 2, figsize=(10.5, 3.6))
axes[0].imshow(PE.T, cmap="PuRd", aspect="auto")
axes[0].set_title("Positional Encoding (50 position x 64 dimension)")
axes[0].set_xlabel("position")
axes[0].set_ylabel("dimension")
axes[0].grid(False)
for d, c in zip([0, 2, 8, 20], ["#6B5B95", "#A4457A", "#2F7D4F", "#B7791F"]):
    axes[1].plot(PE[:, d], color=c, lw=2, label=f"dimension {d}") axes[1].set_title("Kuch dimensions ki lehrein") axes[1].set_xlabel("position")
    axes[1].legend()
    plt.tight_layout()
    plt.show()
OUTPUT (chart)
NOTE
<!-- End of picture text -->
- Sinusoidal ke ilawa learned positional embeddings bhi hote hain (GPT-2, BERT: position ka apna embedding table seekha jata hai). Aaj ke bohat se naye LLM RoPE (rotary) jaisi tarkeebein istemal karte hain jo attention ke andar hi position ko ghumaa kar daalti hain. Maqsad sab ka ek hi hai: model ko tokens ki tartib batana.
29.8 Transformer Block: sab ko ek sath jodna
Ek Transformer block me do hisse hote hain, aur har hissay ke ird gird do chhoti si cheezein:
-
Multi-Head Attention: tokens aapas me maloomat baantte hain.
-
Feed-Forward Network (FFN): har token ko alag alag do Dense layers se guzarna (aam taur par pehli layer 4 guna chaudi, activation ReLU/GELU).
-
Residual connection (Add): hissay ka output uske input me jod dena:
x + sublayer(x). Gehre network me gradient aasani se behta hai (Chapter 24 ka ResNet yaad karo). -
LayerNorm: har token ke vector ko mean 0, std 1 par laana taake training mustahkam rahe.
DIAGRAM
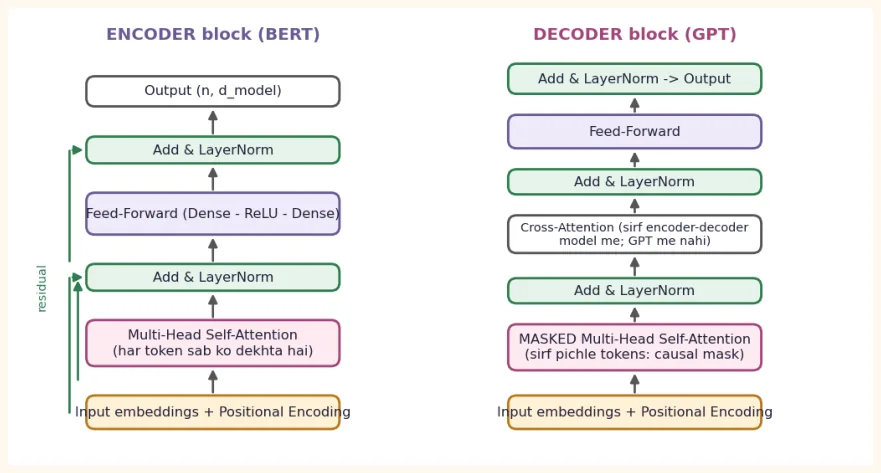
Ye block N baar upar neeche (stack) lagaya jata hai (original me 6, aaj ke bade LLM me 30 se 100 se bhi zyada). LayerNorm ko NumPy me dekho:
def layer_norm(X, eps=1e-5):
    mean = X.mean(axis=-1, keepdims=True)           # har token ka apna mean
    std = X.std(axis=-1, keepdims=True)
    return (X - mean) / (std + eps)
np.random.seed(6)
X = np.random.randn(4, 8) * 5 + 10                  # bare aur bikhre hue numbers
Z = layer_norm(X)
print("Pehle   mean (har row):", X.mean(axis=1).round(1))
print("Baad me mean (0 ke qareeb):", np.abs(Z.mean(axis=1)).round(2))
print("Baad me std  (har row):", Z.std(axis=1).round(2))
OUTPUT Pehle mean (har row): [ 8.6 13.5 11.1 10.1] Baad me mean (0 ke qareeb): [0. 0. 0. 0.] Baad me std (har row): [1. 1. 1. 1.]
Ab poora Transformer block ek function me (Self-Attention + FFN + Residual + LayerNorm):
def transformer_block(X, params, h, mask=None):
    Wq, Wk, Wv, Wo, W1, b1, W2, b2 = params
    n, d_model = X.shape
    d_k = d_model // h # 1) Multi-Head Self-Attention
    Q, K, V = X @ Wq, X @ Wk, X @ Wv
    heads = []
    for i in range(h):
        sl = slice(i * d_k, (i + 1) * d_k)
        heads.append(attention(Q[:, sl], K[:, sl], V[:, sl], mask)[0])
        attn_out = np.concatenate(heads, axis=-1) @ Wo
        X = layer_norm(X + attn_out)                       # Add & Norm # 2) Feed-Forward (har token par alag)
        ff = np.maximum(0, X @ W1 + b1) @ W2 + b2
    return layer_norm(X + ff)                          # Add & Norm
def make_params(d_model, d_ff, seed):
    r = np.random.RandomState(seed)
    s = 0.2
    return [r.randn(d_model, d_model) * s for _ in range(4)] + [ r.randn(d_model, d_ff) * s, np.zeros(d_ff), r.randn(d_ff, d_model) * s, np.zeros(d_model)]
d_model, h, d_ff, n = 16, 4, 64, 6
X = np.random.RandomState(7).randn(n, d_model)
out = X
for layer in range(3):
    # 3 blocks stack
    out = transformer_block(out, make_params(d_model, d_ff, layer), h)
    print("Input :", X.shape)
    print("Output:", out.shape, "(3 blocks ke baad bhi wohi shape)")
    attn_params = 4 * d_model * d_model
    ffn_params = d_model * d_ff + d_ff + d_ff * d_model + d_model
    print("Ek block: attention", attn_params, "+ FFN", ffn_params, "=", attn_params + ffn_params)
OUTPUT
Input :
(6, 16) Output:
(6, 16) (3 blocks ke baad bhi wohi shape) Ek block:
attention 1024 + FFN 2128 = 3152
Encoder, Decoder aur Causal Mask
Transformer ke do bunyadi roop hain:
| Hissa | Attention kaisa? | Kahan istemal? | Misaal |
|---|---|---|---|
| Encoder | Har tokensabtokens ko dekhta hai (aage peeche, bidirectional) | Text kosamajhna: classification, search, embeddings | BERT |
| Decoder | Har token sirfapne se pehleke tokens ko dekhta hai (causal) | Textbanana(generation) | GPT, Llama |
| Encoder + | Encoder input samajhta hai, decoder ti | Translation, summarization | Original Transformer, T5 |
| Decoder | cross-attention se uski madad leta hai |
Text banate waqt model ko mustaqbil ke tokens dekhne nahi chahiyen (warna wo sirf agla lafz copy kar leta). Is liye decoder me causal mask lagta hai: score table ke upar wale hisse (mustaqbil) ko -infinity kar dete hain taake softmax unhein 0 weight de:
n = 5
mask = np.tril(np.ones((n, n), dtype=bool))      # neeche ka tikon True, upar False
print(mask.astype(int))
np.random.seed(8)
Q = np.random.randn(n, 4)
K = np.random.randn(n, 4)
V = np.random.randn(n, 4)
_, w = attention(Q, K, V, mask=mask)
print()
print("Causal attention weights:")
print(w.round(2))
OUTPUT [[1 0 0 0 0] [1 1 0 0 0] [1 1 1 0 0] [1 1 1 1 0] [1 1 1 1 1]] Causal attention weights: [[1. 0. 0. 0. 0. ] [0.01 0.99 0. 0. 0. ] [0.64 0.28 0.08 0. 0. ] [0.12 0.39 0.22 0.27 0. ] [0.31 0.08 0.19 0.18 0.25]]
Dekho: pehla token sirf khud ko dekhta hai (weight 1.0), doosra pehle aur doosre ko, aur isi tarah aage. Upar ka tikon 0 hai. Isi tarah GPT jaise models agla token andaza lagate hain. Cross-attention me Query decoder se aati hai jabke Key aur Value encoder ke output se , yani decoder encoder ke jumle ko "dekh" kar translate karta hai.
29.9 Keras me MultiHeadAttention aur chhota Transformer
Hath se likhne se samajh aya, ab asli kaam me Keras ki MultiHeadAttention layer istemal hoti hai (Colab me chalao):
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers
mha = layers.MultiHeadAttention(num_heads=2, key_dim=8)
x = tf.random.normal((1, 5, 16))          # 1 jumla, 5
tokens, d_model = 16
out, scores = mha(query=x, value=x, key=x, return_attention_scores=True)
print("output :", out.shape)
print("scores :", scores.shape)           # (batch, heads, tokens, tokens)
print("params :", mha.count_params())
OUTPUT (namoona) output : (1, 5, 16) scores : (1, 2, 5, 5) params : 1088
query=x, key=x, value=x yani self-attention . 1088 parameters ka hisaab: Q, K, V teeno ke liye 16 x (2 x 8) + (2 x 8) = 272 , aur output projection ke liye (2 x 8) x 16 + 16 = 272 . Total 4 x 272 = 1088 . Isay khud verify karo:
d_model, heads, key_dim = 16, 2, 8
qkv = 3 * (d_model * heads * key_dim + heads * key_dim)    # Q, K, V (weights + bias)
out_proj = heads * key_dim * d_model + d_model
print("Q+K+V:", qkv, "| output:", out_proj, "| kul:", qkv + out_proj)
OUTPUT
Q+K+V: 816 | output: 272 | kul: 1088
Ab ek chhota Transformer encoder block jo text ko positive/negative me baant sakta hai:
def transformer_block(x, num_heads=2, key_dim=8, ff_dim=32):
    attn = layers.MultiHeadAttention(num_heads=num_heads, key_dim=key_dim)(x, x)
    x = layers.LayerNormalization()(layers.Add()([x, attn]))        # Add & Norm
    ff = layers.Dense(ff_dim, activation="relu")(x)                 # Feed-Forward
    ff = layers.Dense(x.shape[-1])(ff)
    return layers.LayerNormalization()(layers.Add()([x, ff]))       # Add & Norm
inputs = keras.Input(shape=(20,), dtype="int32")                    # 20 token ids
x = layers.Embedding(input_dim=1000, output_dim=16)(inputs)         # vocab 1000
x = transformer_block(x)
x = layers.GlobalAveragePooling1D()(x)                              # tokens ka average
outputs = layers.Dense(1, activation="sigmoid")(x)
model = keras.Model(inputs, outputs)
model.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
model.summary()
OUTPUT (namoona) ... Total params: 18,241 (71.25 KB) Trainable params: 18,241 (71.25 KB) Non-trainable params: 0 (0.00 B)
Is model me positional encoding nahi lagayi (isay Embedding ke saath ek aur position-embedding layer se jod sakte ho). 18,241 ka hisaab khud nikalo:
embedding = 1000 * 16
mha = 1088
layernorm = 2 * 16                       # gamma aur beta
ffn = (16 * 32 + 32) + (32 * 16 + 16)
head = 16 * 1 + 1
total = embedding + mha + layernorm + ffn + layernorm + head
print("Embedding:", embedding, "| MHA:", mha, "| FFN:", ffn)
print("Kul parameters:", total)
OUTPUT Embedding: 16000 | MHA: 1088 | FFN: 1072 Kul parameters: 18241
29.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Attention ko "samajh" samajhna. Weights ye batate hain ke model kahan dekh raha hai, ye nahi ke wo "samajhta" hai.
-
sqrt(d_k) bhool jana (softmax saturate ho jata hai aur learning ruk jati hai).
-
Softmax ghalat axis par lagana. Attention me har row (Query) ka jama 1 hona chahiye (
axis=-1). -
Positional encoding na lagana. Phir model ko tartib ka pata hi nahi chalta.
-
Causal mask bhool jana decoder me (model mustaqbil ko dekh kar "cheating" karta hai).
-
d_model ko heads se divide na hone dena (d_model = 16 aur heads = 5 nahi chalta).
Hands-on
-
Weights padhna: 29.5 ke code me Wq ko badal kar
seed3 se 10 karo; "sara" ka attention kitna badla? -
Scaling:
attentionfunction se/ np.sqrt(d_k)hata kar 29.4 ka test dobara chalao. -
Heads:
multi_head_attentionme h = 1, 2, 8 karo. Output shape aur parameters kya rahe? -
Positional Encoding:
positional_encoding(100, 32)ki heatmap banao aur dekho ke dimensions barhne par lehrein slow kyun hoti hain. -
Causal Mask: mask ko
np.triuse ulta karo (mustaqbil dikhao); weights ki tasveer dekh kar batao kya fark pada. -
Keras:
MultiHeadAttentionmenum_heads=4, key_dim=4karo aur params ginti khud nikal karcount_params()se milao.
KEY TAKEAWAYS
-
Transformer text ko ek sath (parallel) processes karta hai; RNN ki tarah ek ek karke nahi.
-
Input: tokens -> ids -> embeddings , shape (tokens, d_model).
-
Q, K, V : Query "kya dhoond raha hoon", Key "mere paas kya hai", Value "asal maal".
-
Attention(Q,K,V) = softmax(Q K^T / sqrt(d_k)) V ; har row ke weights ka jama 1.
-
Self-Attention: Q, K, V ek hi X se (Wq, Wk, Wv ke zariye); Multi-Head: kai heads, har ek alag pehlu, parameters 4 x d_model^2.
-
Attention ko tartib ka pata nahi, is liye Positional Encoding (sin/cos ya learned) X me jodte hain.
-
Block = Multi-Head Attention + FFN , har ek ke saath Residual (Add) aur LayerNorm ; blocks ko stack karte hain.
-
Encoder (bidirectional, BERT), Decoder (causal mask, GPT), Encoder-Decoder (T5, translation).