Chapter 30: Large Language Models (GPT, BERT) aur LLM Applications
MODULE 8 | WEEK 30
Chapter 30: Large Language Models (GPT, BERT) aur LLM Applications
Pichle chapter me tumne Transformer ke andar ka nizam dekha. Ab dekhte hain ke jab isay arbon lafzon par train kar ke bohat bara kar diya jaye to Large Language Model (LLM) banta hai. Hum seekhenge ke LLM asal me agla token andaza lagane wali machine kaise hai, tokenization (BPE) kaise hoti hai, GPT aur BERT me kya farq hai, LLM ko kaise train kiya jata hai, uski hadood kya hain, aur phir embeddings, semantic search aur RAG se asli applications kaise banti hain.
30.1 Language Model kya hai?
Language Model ek aisa model hai jo is sawal ka jawab deta hai: "in lafzon ke baad agla lafz kya hoga?" Matlab har mumkin agle token ki probability :
P( agla token | pichle tokens )
Perplexity: model kitna "hairan" hai?
Language model ko parakhne ka aam paimana perplexity hai: jitni kam, utna behtar . Ye model ki average hairani hai: perplexity k ka matlab hai ke model har qadam par taqreeban k barabar mumkin lafzon me uljha hua hai.
def perplexity(sentence):
    words = ["<start>"] + sentence.split() + ["<end>"]
    log_p = 0
    for a, b in zip(words[:-1], words[1:]):
        c = counts[a]
        p = c[b] / sum(c.values())
        if sum(c.values())
        else 0
        if p == 0:
        return float("inf")           # model ne ye kabhi dekha hi nahi
log_p += np.log(p)
return np.exp(-log_p / (len(words) - 1))
print("ali kitab parhta hai    :", round(perplexity("ali kitab parhta hai"), 2))
print("sara cricket khelti hai :", round(perplexity("sara cricket khelti hai"), 2))
print("hai ali kitab           :", perplexity("hai ali kitab"))
OUTPUT
ali kitab parhta hai    : 1.64
sara cricket khelti hai : 1.64
hai ali kitab           : inf
30.2 Tokenization aur BPE
Pichle chapter me humne lafzon ko tokens maan liya tha. Asli LLM me ye theek nahi: lafz bohat zyada hain, naye lafz roz bante hain, aur ghalat spelling alag token ban jati hai. Dusri taraf sirf haroof (characters) lein to jumle bohat lambe ho jate hain. Darmiyani hal: subword tokens . Aam lafz poora ek token, aur nadir/lamba lafz chhote tukron me.
| Tareeqa | Fayda | Nuqsan |
|---|---|---|
| Poora lafz | Chhoti sequence | Vocabulary bohat bari; naye lafz "unknown" |
| Sirf character | Koi lafz unknown nahi | Sequence bohat lambi, seekhna mushkil |
| Subword (BPE) | Dono ka behtareen milap | Tokens insani lafz se alag nazar aate hain |
BPE (Byte Pair Encoding) ka idea bohat saada hai: characters se shuru karo, sab se aam jori (pair) ko ek naya token bana do, aur ye baar baar dohrao. Khud banate hain:
from collections import Counter
verbs = ["parh", "likh", "khel"]
endings = ["na", "ta", "ti"]
words = [v + e for v in verbs for e in endings] * 3
corpus = [list(w) + ["_"] for w in words]     # characters me, "_" = lafz ka khatma
def most_common_pair(corpus):
    pairs = Counter()
    for w in corpus:
        for a, b in zip(w[:-1], w[1:]):
            pairs[(a, b)] += 1
        return pairs.most_common(1)[0]
def merge(corpus, pair):
    new = []
    for w in corpus:
        out, i = [], 0
        while i < len(w):
            if i < len(w) - 1 and (w[i], w[i + 1]) == pair:
                out.append(w[i] + w[i + 1])
                i += 2
            else:
                out.append(w[i])
                i += 1
                new.append(out)
            return new
merges = []
for step in range(8):
    pair, freq = most_common_pair(corpus)
    corpus = merge(corpus, pair)
    merges.append(pair)
    print(f"merge {step + 1}: {pair[0]!r} + {pair[1]!r}  ({freq} baar)")
    print()
    print("'parhna' ke tokens:", corpus[0])
    print("'likhti' ke tokens:", corpus[5])
OUTPUT merge 1: 'a' + '_' (18 baar) merge 2: 'k' + 'h' (18 baar) merge 3: 'p' + 'a' (9 baar) merge 4: 'pa' + 'r' (9 baar) merge 5: 'par' + 'h' (9 baar) merge 6: 'n' + 'a_' (9 baar) merge 7: 't' + 'a_' (9 baar) merge 8: 't' + 'i' (9 baar) 'parhna' ke tokens: ['parh', 'na_'] 'likhti' ke tokens: ['l', 'i', 'kh', 'ti', '_']
Dekho kaise "parh" (jo teeno lafzon me hai) aur "na_", "ta_", "ti" jaise aakhri hisse ("_" matlab lafz khatam) khud ba khud token ban gaye. Naye lafz ko bhi issi tarah todte hain: seekhi hui merges ko wohi tarteeb se lagao:
def tokenize(word, merges):
    tokens = list(word) + ["_"]
    for pair in merges:
        tokens = merge([tokens], pair)[0]
    return tokens
print("'parhti' :", tokenize("parhti", merges))
print("'khelta' :", tokenize("khelta", merges))
print("'sochna' :", tokenize("sochna", merges))   # naya lafz, phir bhi tokens me tuta
OUTPUT 'parhti' : ['parh', 'ti', '_'] 'khelta' : ['kh', 'e', 'l', 'ta_'] 'sochna' : ['s', 'o', 'c', 'h', 'na_']
30.3 GPT: Decoder-only Transformer
GPT = Generative Pre-trained Transformer. Ye Chapter 29 ke decoder hissay ko (causal mask ke saath) bohat bara bana kar sirf agla token andaza lagane par train karta hai. Generation ka loop wohi hai jo bigram me dekha, bas andaza Transformer se aata hai:
-
Prompt ko tokens me todo.
-
Model har mumkin agle token ka score (logit) deta hai.
-
Softmax se probabilities bana kar ek token chuno (kaise chunein: neeche).
-
Chuna hua token prompt me jor do aur dobara qadam 2 se shuru karo, jab tak end token ya had na aa jaye.
DIAGRAM
Sampling: agla token kaise chunein?
Model ka output ek probability distribution hai. Us se token chunne ke tareeqay generation ka andaz tay karte hain:
| Tareeqa | Kaise kaam karta hai | Nateeja |
|---|---|---|
| Greedy | Hamesha sab se zyada probability wala token | Pakka, magar dohrane wala aur "boring" |
| Temperature | Logits ko T se bhaag kar softmax: T chhota = tez/pakka, T bara = random | T=0.2 serious, T=1.0 aam, T=1.5 creative/ghalat |
| Top-k | Sirf topktokens me se chuno | Bekaar/ajeeb tokens kat jate hain |
| Top-p (nucleus) | Sab se bare tokens jab tak unki probability ka jamapna ho | Distribution ke hisaab se khud badalti hui hadd |
tokens = ["paani", "chai", "doodh", "juice", "kitab", "bijli"]
logits = np.array([3.0, 2.5, 1.5, 1.0, -1.0, -2.0])     # model ke raw scores
def softmax_t(logits, T=1.0):
    z = logits / T
    e = np.exp(z - z.max())
    return e / e.sum()
for T in [0.5, 1.0, 2.0]:
    probs = softmax_t(logits, T)
    print(f"T={T}:", {t: float(p) for t, p in zip(tokens, probs.round(2))})
OUTPUT T=0.5: {'paani': 0.7, 'chai': 0.26, 'doodh': 0.03, 'juice': 0.01, 'kitab': 0.0, 'bijli': 0.0} T=1.0: {'paani': 0.5, 'chai': 0.3, 'doodh': 0.11, 'juice': 0.07, 'kitab': 0.01, 'bijli': 0.0} T=2.0: {'paani': 0.35, 'chai': 0.27, 'doodh': 0.17, 'juice': 0.13, 'kitab': 0.05, 'bijli': 0.03}
import matplotlib.pyplot as plt
fig, axes = plt.subplots(1, 3, figsize=(10.5, 3.0), sharey=True)
for ax, T, c in zip(axes, [0.5, 1.0, 2.0], ["#6B5B95", "#A4457A", "#2F7D4F"]):
    ax.bar(tokens, softmax_t(logits, T), color=c)
    ax.set_title(f"Temperature = {T}")
    ax.tick_params(axis="x", rotation=45)
    axes[0].set_ylabel("probability")
    plt.tight_layout()
    plt.show()
OUTPUT (chart)
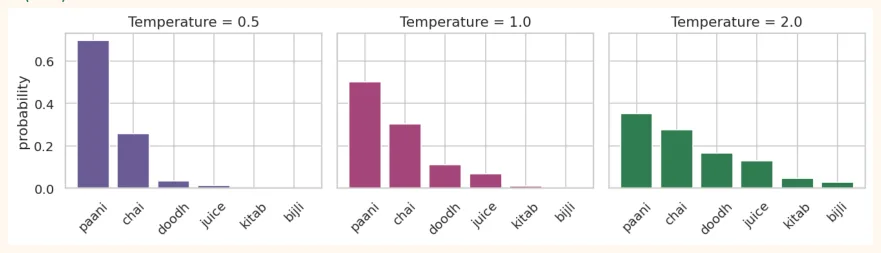
T chhota to ek token (paani) bohat zyada gaalib; T bara to probabilities barabar ho kar random pan barhta hai. Ab top-k aur top-p ko asal sampling me dekho (1000 baar chuna):
def top_k_filter(probs, k):
    keep = np.argsort(probs)[-k:]
    out = np.zeros_like(probs)
    out[keep] = probs[keep]
    return out / out.sum()
def top_p_filter(probs, p):
    order = np.argsort(probs)[::-1]
    cum = np.cumsum(probs[order])
    cutoff = np.searchsorted(cum, p) + 1             # jama p tak pohanchne wale tokens
    out = np.zeros_like(probs)
    out[order[:cutoff]] = probs[order[:cutoff]]
    return out / out.sum()
base = softmax_t(logits, 1.0)
rng = np.random.RandomState(0)
for name, probs in [("greedy-jaisa (T=0.1)", softmax_t(logits, 0.1)), ("normal (T=1)", base), ("top-k (k=2)", top_k_filter(base, 2)), ("top-p (p=0.9)", top_p_filter(base, 0.9))]:
    picks = rng.choice(tokens, size=1000, p=probs)
    counts_ = Counter(str(t) for t in picks)
    print(f"{name:20s}", dict(counts_.most_common()))
OUTPUT greedy-jaisa (T=0.1) {'paani': 995, 'chai': 5} normal (T=1) {'paani': 486, 'chai': 300, 'doodh': 113, 'juice': 87, 'kitab': 9, 'bijli': 5} top-k (k=2) {'paani': 630, 'chai': 370} top-p (p=0.9) {'paani': 573, 'chai': 319, 'doodh': 108}
30.4 BERT: Encoder-only Transformer
BERT (Bidirectional Encoder Representations from Transformers) Google ne 2018 me banaya. GPT ke ulta, ye Transformer ka encoder hissa istemal karta hai jahan har token agay aur peeche dono taraf dekhta hai. Is liye wo text ko samajhne me bohat acha hai, magar text banane ke liye nahi bana.
Training ka tareeqa: jumle ke kuch tokens (taqreeban 15% ) chhupa do ( [MASK] ) aur model se chhupe hue lafz batwao. Isay Masked Language Modeling kehte hain:
Input : "Karachi Pakistan ka sab se bara [MASK] hai."
Target: "shehar"
30.5 LLM kaise train hota hai?
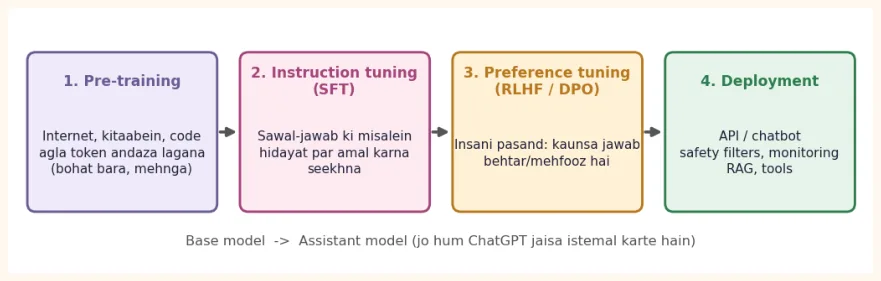
ChatGPT jaisa assistant sirf "agla token" seekhne se nahi banta. Aam taur par teen marhale hote hain (upar ki tasveer dekho):
| Marhala | Kya hota hai? | Nateeja |
|---|---|---|
| 1. Pre-training | Arbon tokens (kitabein, websites, code) paragla token andaza lagana. Hazaron GPUs aur mahine/hafte | **Base model:**text aage barhata hai, magar hidayat nahi manta |
| 2. Instruction tuning (SFT) | Hazaron/lakhon**(hidayat, achha jawab)**ki misalein par supervised training | Modelsawal ka jawab denaseekhta hai |
| 3. Preference tuning (RLHF / DPO) | Insaan ek sawal ke do jawabon me sebehtar chunte hain; model usi pasand ke mutabiq dhal jata hai | Jawabmadadgar, mehfooz aur saleeqe walehote hain |
-
Scaling: aam taur par model ka size (parameters), data aur computation barhane se kaarkardagi barhti hai, lekin data ki quality bhi utni hi ahem hai.
-
Open-weight models (jaise Llama, Mistral, Gemma, Qwen ) ke weights download ho sakte hain aur apne computer/server par chalaye ja sakte hain; closed models (jaise OpenAI ke GPT) sirf API se milte hain.
-
Parameters ka matlab: "7B" model ke 7 arab weights hote hain. Zyada parameters ko chalane ke liye zyada GPU memory chahiye.
30.6 LLM ki hadood
LLM bohat taqatwar hai, magar jadoo nahi . In hadood ko jaanna ek achhe AI engineer ki pehchan hai:
| Masla | Matlab | Ilaaj / ehtiyat |
|---|---|---|
| Hallucination | Modelitminan se ghalat baatlikh deta hai (jhoothe hawale, ghalat tareekhein) | RAG se sources dena, jawab ki tasdeeq, "pata nahi" kehne ki ijazat |
| Knowledge cutoff | Model ko training ke baad ki khabrein maloom nahi | Web search tool, RAG, taaza data prompt me dena |
| Context limit | Ek sath sirf mehdood tokens | Chunking, summarize, RAG |
| Bias | Training data ke taassub jawab me aa sakte hain | Testing, guardrails, insani nigrani |
| Hisaab kitab me ghalti | Bare numbers ka exact hisaab aksar ghalat | Calculator/code tool istemal karo |
| Prompt injection | Kisi document me chhupi hidayat model ko behka sakti hai | Untrusted text par bharosa na karo, tools ki ijazat mehdood rakho |
| Kharcha aur raftar | Bare model mehnge aur sust | Chhota model chuno, caching, prompt chhota |
| Non-determinism | Wohi sawal, alag jawab | Temperature kam, structured output, tests |
30.7 Embeddings aur Semantic Search
Embedding kisi text (lafz, jumla, paragraph) ko ek vector me badalti hai jahan milte julte matlab ke text aapas me qareeb hote hain. Qurb napne ka aam tareeqa cosine similarity hai (do vectors ke darmiyani zaviye ka cosine, 1 = ek hi rukh, 0 = alag).
cosine(a, b) = (a . b) / ( |a| x |b| )
def cosine(a, b):
return (a @ b) / (np.linalg.norm(a) * np.linalg.norm(b)) # haath se banaye hue chhote "embeddings" (dimension: [khana, safar, technology])
emb = { "biryani":  np.array([0.9, 0.1, 0.0]), "karahi":   np.array([0.8, 0.2, 0.1]), "train":    np.array([0.0, 0.9, 0.2]), "laptop":   np.array([0.1, 0.0, 0.9]), }
print("biryani vs karahi :", round(cosine(emb["biryani"], emb["karahi"]), 2))
print("biryani vs train  :", round(cosine(emb["biryani"], emb["train"]), 2))
print("biryani vs laptop :", round(cosine(emb["biryani"], emb["laptop"]), 2))
OUTPUT biryani vs karahi : 0.98 biryani vs train : 0.11 biryani vs laptop : 0.11
Asli embeddings model se aati hain (OpenAI ka embeddings API , ya sentence-transformers ) aur kai sau se hazaron dimensions ki hoti hain. Embedding model matlab pakarta hai, is liye "gaari" aur "car" qareeb aate hain. Is ke muqable me purana TF-IDF sirf lafzon ke milne par chalta hai. Hum abhi bina internet ke TF-IDF se search ka dhancha banate hain (baad me sirf embedding function badalna hoga):
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
docs = [
"Python programming ka kaam variables aur loops se shuru hota hai.", "NumPy aur Pandas data analysis ke liye istemal hoti hain.", "Neural network layers aur neurons se banta hai aur backpropagation se seekhta hai.", "Transformer attention mechanism par chalta hai aur LLM ki bunyad hai.", "Agent tools istemal kar ke khud kaam mukammal karta hai.", ]
vec = TfidfVectorizer()
D = vec.fit_transform(docs)
def search(query, k=2):
    q = vec.transform([query])
    sims = cosine_similarity(q, D)[0]
    top = sims.argsort()[::-1][:k]
    return [(round(sims[i], 2), docs[i]) for i in top]
for s, d in search("attention aur transformer kya hai"):
    print(s, "|", d)
OUTPUT
0.59 | Transformer attention mechanism par chalta hai aur LLM ki bunyad hai.
0.22 | Neural network layers aur neurons se banta hai aur backpropagation se seekhta hai.
30.8 RAG: Retrieval-Augmented Generation
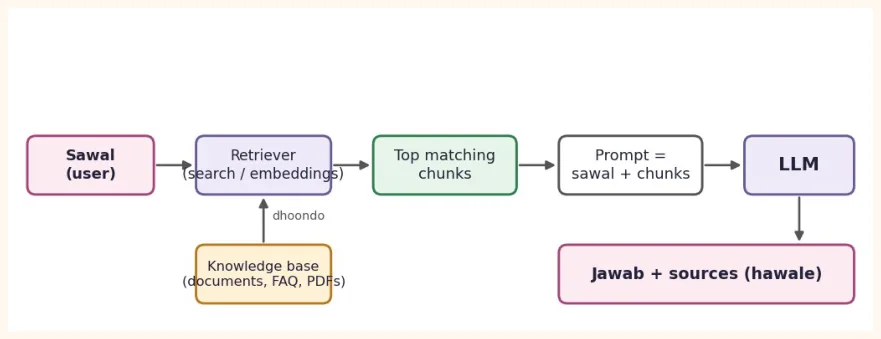
LLM ko tumhari apni files (course notes, company FAQ, PDF) ka pata nahi hota. Sab kuch prompt me daal nahi sakte (context ki hadd), aur dobara train karna mehnga hai. RAG ka hal: pehle search karo, phir sirf kaam ka hissa LLM ko do.
DIAGRAM
-
Documents ko chunks me todo (maslan har 200-500 lafz ka tukra).
-
Har chunk ki embedding nikalo aur vector store me rakho.
-
Sawal aaye to uski embedding se sab se qareeb chunks (top-k) dhoondo.
-
Chunks ko prompt me jod do: "sirf in maloomat se jawab do, na mile to kaho pata nahi."
-
LLM jawab + sources deta hai.
OUTPUT
Sirf neeche diye hue context se jawab do.
Agar jawab context me na ho to kaho: 'mujhe maloom nahi'.
Context:
[1] Transformer attention mechanism par chalta hai aur LLM ki bunyad hai.
[2] Neural network layers aur neurons se banta hai aur backpropagation se seekhta hai.
Sawal: LLM ki bunyad kya hai?
Jawab (source number ke saath):
Ye prompt agle chapter me API se bheja jayega. Source numbers ki wajah se jawab ki tasdeeq ho sakti hai, jo hallucination ka sab se behtareen ilaaj hai.
30.9 LLM Applications ka nakshaa
| Application | LLM kya karta hai? | Misaal |
|---|---|---|
| Chatbot / Assistant | Sawalon ke jawab, guftagu | Customer support, admission FAQ bot |
| Summarization | Lambe text ka khulasa | Meeting notes, report ka summary |
| Translation | Zabanon ke darmiyan tarjuma | English se Urdu/Roman Urdu |
| Code assistant | Code likhna, samjhana, bug dhoondna | Autocomplete, code review |
| Extraction | Text se structured data (JSON) | Invoice se amount aur tareekh nikalna |
| Classification | Text ko category dena | Email: spam/zaroori, feedback: positive/negative |
| RAG / Q&A | Apne documents par sawal jawab | Course notes par study assistant |
| Agents | Tools istemal kar ke kaam mukammal karna | Booking, research, data analysis (Chapter 32-33) |
30.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
LLM ko database ya search engine samajhna. Wo patterns se jawab banata hai, facts nahi dhoondta.
-
Jawab par aankh band kar ke bharosa. Hallucination ke liye tasdeeq zaroori hai.
-
Context window ki hadd bhool jana (lamba document ek sath dena aur shuru ka hissa kat jana).
-
Temperature ko "zehaanat" ka button samajhna. Ye sirf randomness badalta hai.
-
Hassas data (password, shanakhti card, nijee maloomat) prompt me bhej dena.
-
BERT se text generation ki ummeed rakhna ya GPT ko "masked fill" ke liye ghalat tareeqe se istemal karna.
Hands-on
• Bigram: corpus me 6 aur jumle jodo aur generate() ke 10 jumle dekho. Kya ghalat grammar kam hui?
-
BPE:
mergesko 8 se 20 karo aur dekho ke "parhna" ke tokens kitne chhote ho jate hain. -
Temperature:
logitsbadlo (maslan sab barabar) aur T=0.5, 1, 2 ke charts dekho. -
Top-p: p = 0.5, 0.9, 1.0 par sampling count ka farq likho.
-
Search:
docsme 3 aur documents jodo aur 5 alag sawal pooch kar dekho kaun sa document kab upar aata hai. -
RAG:
build_rag_promptmekko 1 aur 4 karo; prompt ki lambai ka asar dekho.
KEY TAKEAWAYS
-
LLM = bohat bara Language Model , jo agla token andaza lagane par train hota hai.
-
Tokenization (BPE): lafz ko subword tokens me todna; tokens ki ginti kharcha aur context ko tay karti hai.
-
GPT: decoder-only, causal; text banata hai. BERT: encoder-only, bidirectional; text samajhta hai (masked language modeling).
-
Sampling: greedy, temperature , top-k , top-p generation ka andaz tay karte hain.
-
Training: Pre-training -> Instruction tuning (SFT) -> Preference tuning (RLHF/DPO) .
-
Hadood: hallucination, knowledge cutoff, context limit, bias, prompt injection, kharcha .
-
Embeddings matlab ko vector banati hain; cosine similarity se qareeb text milta hai.
-
RAG = pehle search, phir jawab; hallucination kam aur sources ke saath jawab deta hai.