Chapter 9: Descriptive Statistics aur Probability
MODULE 3 | WEEK 9
Chapter 9: Descriptive Statistics aur Probability
Statistics data se maani nikalne ka ilm hai, aur Probability anishchit (uncertain) cheezon ko napne ka ilm. Ye dono Data Science aur Machine Learning ki rooh hain. Koi bhi ML algorithm andar se statistics aur probability hi istemal karta hai. Is chapter me hum Python ke saath dono ki bunyad banayenge.
9.1 Statistics ki bunyad
Statistics ke do bare hisse hain:
-
Descriptive Statistics: jo data hamare saamne hai usay bayan karna (average kya hai, kitna phaila hua hai). Ye is chapter ka mozu hai.
-
Inferential Statistics: thore se data (sample) se poore group (population) ke baare me andaza lagana. Ye agle chapter me hoga.
Population aur Sample
| Population | Sample | |
|---|---|---|
| Matlab | Poora group jis ke baare me janna hai | Population ka chhota hissa jo hum ne chuna |
| Misaal | Pakistan ke sab university students | Un me se 500 students jin se survey kiya |
| Number ko kehte hain | Parameter(jaise population ka mean, mu) | Statistic(jaise sample ka mean, x-bar) |
| Kyun | Sab se poochna mehnga ya na-mumkin | Aasan, sasta, jaldi |
Data ki qismein
| Qism | Matlab | Misaal |
|---|---|---|
| Nominal (categorical) | Naam wali categories, koi tarteeb nahi | Shehar, rang, jins, blood group |
| Ordinal (categorical) | Categories jin me tarteeb hai | Grade (A, B, C), rating (1 se 5 star), taleem ki |
| satah | ||
| Discrete (numerical) | Ginti ke poore numbers | Bhai behnon ki tadaad, ghar me kamray |
| Qism | Matlab | Misaal |
|---|---|---|
| Continuous (numerical) | Koi bhi value, decimal samet | Qad, wazan, temperature, qeemat |
9.2 Descriptive Statistics
Ek chhote dataset se shuru karte hain: 15 students ke marks .
import numpy as np
import pandas as pd
from scipy import stats
marks = np.array([45, 52, 58, 61, 63, 65, 67, 70, 72, 75, 78, 82, 88, 95, 40])
print(marks)
print(len(marks))
OUTPUT
[45 52 58 61 63 65 67 70 72 75 78 82 88 95 40]
15
A) Central Tendency (data ka markaz)
Ye ek akela number hota hai jo poore data ki numaindagi karta hai. Teen tareeqay hain:
| Measure | Matlab | Kab behtar |
|---|---|---|
| Mean(average) | Sab ka jama / tadaad | Data aam taur par symmetric ho, outliers na hon |
| Median | Tarteeb me lagane parbeech walivalue | Outliers hon ya data ek taraf jhuka ho |
| Mode | Sab se zyada baar aane wali value | Categories ke liye, ya jab sab se aam cheez janni ho |
print("Mean  :", marks.mean().round(2))
print("Median:", np.median(marks))
print("Mode  :", stats.mode(marks, keepdims=False).mode)    # jab sab alag hon to sab se
chhoti value
# Pandas me
s = pd.Series(marks)
print(s.mean().round(2), s.median(), s.mode().tolist()[:3])
OUTPUT
Mean  : 67.4
Median: 67.0
Mode  : 40
67.4 67.0 [40, 45, 52]
OUTPUT
Mean  : 545.0
Median: 50.0
B) Spread (data kitna phaila hua hai)
Sirf average se kaam nahi chalta. Do classes ka average 70 ho sakta hai, magar ek me sab 68 se 72 ke beech hon aur doosri me 30 se 100 ke beech. Is farq ko spread (phailao) napta hai.
| Measure | Matlab | Formula / Idea |
|---|---|---|
| Range | Sab se bara minus sab se chhota | max - min (outlier se bohat mutasir) |
| Variance | Har value ke mean se farq kesquareka average | sigma<sup>2</sup>= sum((x - mean)<sup>2</sup>) / n |
| Standard Deviation (std) | Variance kasquare root(wohi units me) | sigma = sqrt(variance) |
| IQR | Beech ke 50% data ka phailao | Q3 - Q1 (outliers se mehfooz) |
OUTPUT
Range    : 55
Variance : 216.11
Std      : 14.7
Sample std: 15.22
Q1, Q3, IQR: 59.5 76.5 17.0
AAM GALTIYAN
-
NumPy aur Pandas me std ka default alag hai. NumPy me ddof=0 (population), Pandas me ddof=1 (sample). Isliye same data par dono ka jawab thora alag aata hai.
-
Jab tumhare paas sample ho (aam halat me yehi hota hai) to ddof=1 use karo. Isay Bessel's correction kehte hain (n ke bajaye n-1 se taqseem), kyunke sample population ka phailao thora kam dikhata hai.
s = pd.Series(marks)
print("Pandas std :", round(s.std(), 2))          # default ddof=1
print("NumPy std  :", round(np.std(marks), 2))     # default ddof=0
OUTPUT
Pandas std : 15.22
NumPy std  : 14.7
C) Percentiles, Quartiles aur Five-number Summary
Percentile: kisi value ke neeche kitna percent data hai. Maslan 90th percentile ka matlab 90% students us se kam number ke hain. Quartiles data ko 4 barabar hisson me batte hain: Q1 (25%), Q2 (50%, yani median), Q3 (75%).
print(np.percentile(marks, [25, 50, 75, 90]))
print(pd.Series(marks).describe().round(2))     # five-number summary + mean, std
OUTPUT
[59.5 67.  76.5 85.6]
count    15.00
mean     67.40
std      15.22
min      40.00
25%      59.50
50%      67.00
75%      76.50
max      95.00
dtype: float64
Five-number summary: Minimum, Q1, Median, Q3, Maximum. Isi se box plot banta hai. Outlier ki pehchan IQR rule (Chapter 6) se hoti hai: Q1 - 1.5 x IQR se neeche ya Q3 + 1.5 x IQR se upar.
D) Z-score (value average se kitni std door hai)
Z-score = (x - mean) / std . Is se alag alag scale wali cheezon ka muqabla ho sakta hai.
OUTPUT
[-1.52 -1.05 -0.64 -0.44 -0.3  -0.16 -0.03  0.18  0.31  0.52  0.72  0.99
  1.4   1.88 -1.86]
Sab se door value: 95
E) Data ki shakal: Skewness aur Kurtosis
-
Skewness (jhukao): 0 ke qareeb = symmetric. Positive = dum dahini taraf lambi (kuch bohat bari values). Negative = dum baayin taraf lambi.
-
Kurtosis: data ki dum kitni bhari hai. Zyada kurtosis = zyada extreme values (outliers).
import matplotlib.pyplot as plt
np.random.seed(5)
symmetric = np.random.normal(50, 10, 1000)
right_skew = np.random.exponential(10, 1000) + 20     # dahini taraf dum
left_skew = 100 - (np.random.exponential(10, 1000) + 20)   # baayin taraf dum
fig, axes = plt.subplots(1, 3, figsize=(12, 3.4))
for ax, data, title in zip(axes, [symmetric, right_skew, left_skew],
                           ["Symmetric", "Right skewed (positive)", "Left skewed
(negative)"]):
    ax.hist(data, bins=30, color="#6B5B95", edgecolor="white")
    ax.axvline(data.mean(), color="red", linestyle="--", label="Mean")
    ax.axvline(np.median(data), color="green", linestyle="-", label="Median")
    ax.set_title(f"{title}\nskew = {stats.skew(data):.2f}")
    ax.legend(fontsize=8)
plt.tight_layout()
plt.show()
OUTPUT (chart)
<!-- End of picture text -->
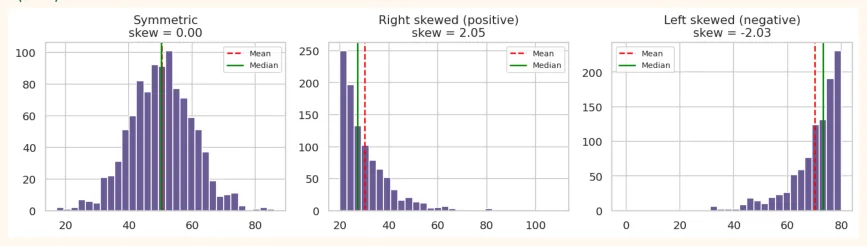
Dekho: symmetric data me mean aur median ek jagah hain. Right skewed me mean (surkh), median (sabz) se dahini taraf khinch jata hai kyunke bari values mean ko upar kheenchti hain. Left skewed me ulta hota hai.
9.3 Probability Theory
Probability kisi waqiye (event) ke hone ke imkan ko 0 se 1 ke beech number se napti hai. 0 matlab na-mumkin, 1 matlab yaqeeni.
# Probability = sazgar nateejay / kul mumkin nateejay
# Ek dice phenkne par 6 aane ki probability:
print(1 / 6)
# Do sikkon me kam az kam ek head:
print(3 / 4)
OUTPUT
0.16666666666666666
0.75
Bunyadi alfaz
-
Experiment: koi amal jis ka nateeja pehle se pata na ho (dice phenkna).
-
Sample Space (S): sab mumkin nateejay. Dice ke liye {1, 2, 3, 4, 5, 6}.
-
Event: sample space ka koi hissa. "Jaft number aana" = {2, 4, 6}.
-
Probability: P(event) = event ke nateejay / kul nateejay (jab sab barabar mumkin hon).
Probability ke usool
| Usool | Formula | Misaal |
|---|---|---|
| Complement | P(A nahi) = 1 - P(A) | Dice par 6 na aane ki = 1 - 1/6 = 5/6 |
| Addition (ya) | P(A ya B) = P(A) + P(B) - P(A aur B) | Dil ya ikka nikalne ki (taash ke patton me) |
| Multiplication (aur) | Independent: P(A aur B) = P(A) x P(B) | Do sikkon par dono head = 1/2 x 1/2 = 1/4 |
| Conditional | P(A | B) = P(A aur B) / P(B) |
OUTPUT
Dil ya ikka: 0.3077
Dono ikke: 0.00452
Conditional Probability aur Bayes' Theorem
Conditional probability ka matlab: "agar ye maloom ho ke B ho chuka hai to A ki probability kya hai?" Bayes' Theorem hamein ulta sawal hal karne deta hai.
Bayes: P(A | B) = P(B | A) x P(A) / P(B)
OUTPUT
Positive aane par bimar hone ki probability: 16.7 %
Sirf 16.7% ! Wajah ye hai ke bimari bohat kam logon (1%) me hai, isliye healthy logon ke 5% false positive asli bimaron se zyada ho jate hain. Isay base rate fallacy kehte hain. ML me classification models (spam, fraud, bimari) ko samajhne ke liye ye soch bohat zaroori hai.
Permutations aur Combinations (ginti ke tareeqay)
-
Permutation: tarteeb ahem hai. 3 logon me se 2 ko "President, Vice President" banana (Ali-Sara aur SaraAli alag hain).
-
Combination: tarteeb ahem nahi . 3 logon me se 2 ki committee (Ali-Sara aur Sara-Ali ek hi hain).
import math
print("Permutation (5 me se 3):", math.perm(5, 3))     # 5 x 4 x 3 = 60
print("Combination (5 me se 3):", math.comb(5, 3))     # 10
print("5 chizon ki tarteebein:", math.factorial(5))    # 120
# Lottery: 49 me se 6 numbers, kitne tareeqay?
print(math.comb(49, 6))
OUTPUT
Permutation (5 me se 3): 60
Combination (5 me se 3): 10
5 chizon ki tarteebein: 120
13983816
Law of Large Numbers (bare numbers ka qanoon)
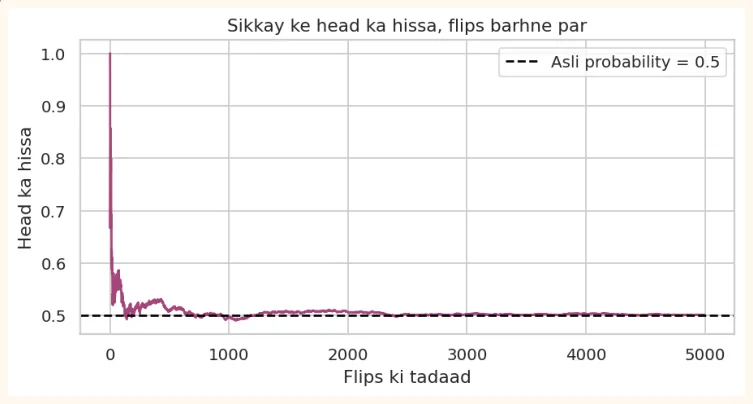
Jitne zyada tajurbe karoge, nateeja asli probability ke utna qareeb aayega. 10 bar sikka uchhalne par 7 head aa sakte hain (70%), magar 10,000 bar uchhalne par 50% ke bohat qareeb aayega.
np.random.seed(11)
flips = np.random.randint(0, 2, 5000)                    # 1 = head
running = np.cumsum(flips) / np.arange(1, 5001)
plt.figure(figsize=(8, 3.6))
plt.plot(running, color="#A4457A")
plt.axhline(0.5, color="black", linestyle="--", label="Asli probability = 0.5")
plt.title("Sikkay ke head ka hissa, flips barhne par")
plt.xlabel("Flips ki tadaad")
plt.ylabel("Head ka hissa")
plt.legend()
plt.show()
OUTPUT (chart)
9.4 Random Variables aur Distributions
Random variable aisi cheez hai jis ki value ek random amal se tay hoti hai (dice ka nateeja, kisi student ka qad). Probability distribution batati hai ke har value ke aane ki probability kitni hai.
1) Normal Distribution (ghanti jaisi shakal)
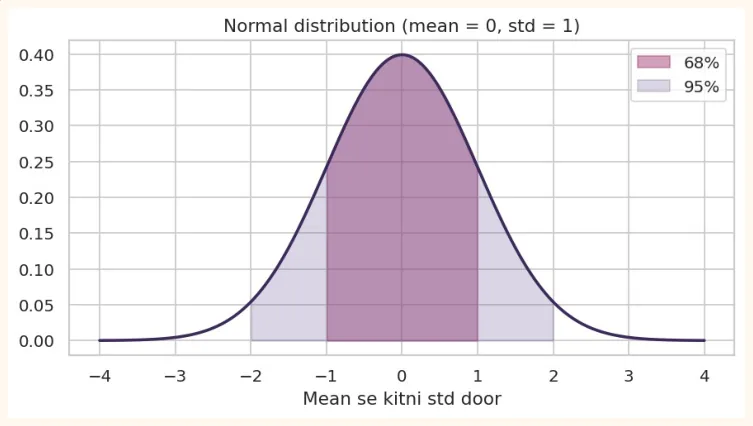
Sab se mashhoor distribution. Qad, wazan, marks, galtiyan aksar is ki tarah hote hain: beech me zyada, dono kinaron par kam.
-
Mean (mu) beech me, std (sigma) phailao tay karta hai.
-
68-95-99.7 Rule: ~68% data mean se 1 std ke andar, ~95% 2 std ke andar, ~99.7% 3 std ke andar.
from scipy.stats import norm
x = np.linspace(-4, 4, 400)
plt.figure(figsize=(8, 3.8))
plt.plot(x, norm.pdf(x), color="#3B2A5A", linewidth=2)
plt.fill_between(x, norm.pdf(x), where=(x > -1) & (x < 1), color="#A4457A", alpha=0.5,
label="68%")
plt.fill_between(x, norm.pdf(x), where=(x > -2) & (x < 2), color="#6B5B95", alpha=0.25,
label="95%")
plt.title("Normal distribution (mean = 0, std = 1)")
plt.xlabel("Mean se kitni std door")
plt.legend()
plt.show()
OUTPUT (chart)
# Students ke marks Normal hain: mean = 65, std = 10
dist = norm(loc=65, scale=10)
print("P(marks < 50)      :", round(dist.cdf(50), 4))                # cdf = 'is se kam' ki
probability
print("P(marks > 80)      :", round(1 - dist.cdf(80), 4))
print("P(55 < marks < 75) :", round(dist.cdf(75) - dist.cdf(55), 4)) # ~68%
print("Top 10% ke liye cutoff:", round(dist.ppf(0.90), 1))           # ppf = ulta sawal
OUTPUT
P(marks < 50)      : 0.0668
P(marks > 80)      : 0.0668
P(55 < marks < 75) : 0.6827
Top 10% ke liye cutoff: 77.8
2) Binomial Distribution (kamyabi / nakami ki ginti)
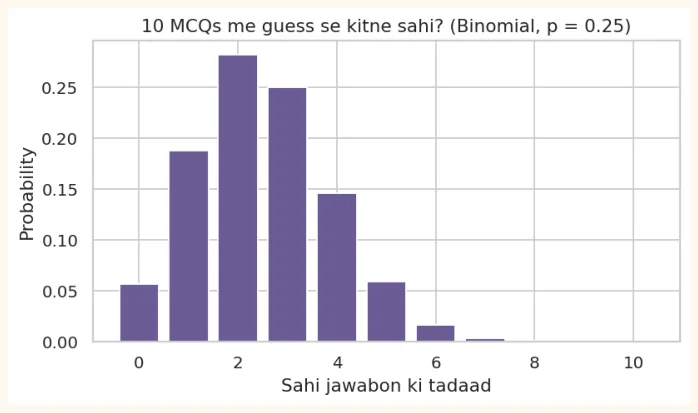
Jab ek tajurba n bar dohraya jaye, har bar sirf do nateejay (kamyab/nakam), aur kamyabi ki probability p hamesha wohi ho. Misaal: 10 sawalon ka MCQ test, har sawal par guess se sahi hone ki probability 0.25.
from scipy.stats import binom
n, p = 10, 0.25                      # 10 MCQs, har ek par sahi guess ki probability 25%
print("Theek 3 sahi   :", round(binom.pmf(3, n, p), 4))
print("Zyada se zyada 3:", round(binom.cdf(3, n, p), 4))
print("5 ya zyada sahi:", round(1 - binom.cdf(4, n, p), 4))
print("Expected sahi  :", n * p)
OUTPUT
Theek 3 sahi   : 0.2503
Zyada se zyada 3: 0.7759
5 ya zyada sahi: 0.0781
Expected sahi  : 2.5
k = np.arange(0, 11)
plt.figure(figsize=(7, 3.6))
plt.bar(k, binom.pmf(k, n, p), color="#6B5B95")
plt.title("10 MCQs me guess se kitne sahi? (Binomial, p = 0.25)")
plt.xlabel("Sahi jawabon ki tadaad")
plt.ylabel("Probability")
plt.show()
OUTPUT (chart)
3) Poisson aur Uniform (mukhtasar)
-
Poisson: ek makhsoos waqt/jagah me kisi waqiye ke kitni bar hone ki ginti, jab average rate maloom ho (ek ghante me call center par kitni calls aayeen, ek page par kitne typos).
-
Uniform: har nateeja barabar mumkin (dice ka nateeja, random.uniform(a, b)).
from scipy.stats import poisson
# Call center par average 4 calls/ghanta. Theek 6 calls aane ki probability?
print(round(poisson.pmf(6, mu=4), 4))
print(round(1 - poisson.cdf(7, mu=4), 4))    # 8 ya zyada calls
OUTPUT
0.1042
0.0511
Central Limit Theorem (CLT): Statistics ka sab se bara jadoo
Chahe original data ki shakal kuch bhi ho (tedhi medhi, ek taraf jhuki), agar tum us me se bar bar sample lo aur har sample ka mean nikalo, to un means ki taqseem Normal ban jati hai (sample jitna bara, utni behtar). Yehi wajah hai ke Normal distribution har jagah nazar aati hai, aur isi par agle chapter ke confidence intervals aur hypothesis tests khare hain.
np.random.seed(21)
population = np.random.exponential(scale=10, size=100000)     # bohat jhuka hua data
fig, axes = plt.subplots(1, 4, figsize=(13, 3.2), sharey=False)
axes[0].hist(population, bins=50, color="#B7791F")
axes[0].set_title("Asli population\n(bohat tedha)")
for ax, n in zip(axes[1:], [2, 10, 50]):
    means = [np.random.choice(population, n).mean() for _ in range(2000)]
    ax.hist(means, bins=40, color="#6B5B95")
    ax.set_title(f"Sample means\n(n = {n})")
plt.tight_layout()
plt.show()
OUTPUT (chart)
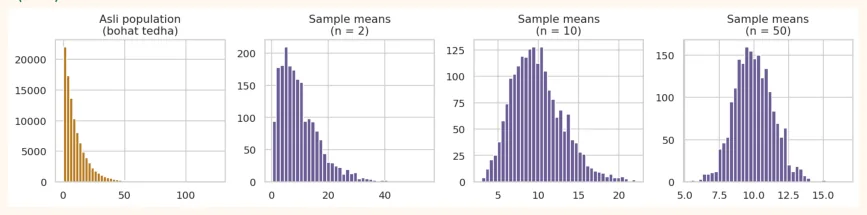
Pehla chart bohat tedha hai, magar jaise jaise sample size (n) barhta hai, means ki taqseem ghanti jaisi Normal banti jati hai aur tang bhi hoti jati hai (yani zyada pakka andaza). Ye CLT hai.
9.5 Hands-on (Python Implementation)
Ek dataset par saari cheezein ek sath lagate hain. Ek class ke 100 students ke marks aur parhai ke ghantay :
import numpy as np
import pandas as pd
from scipy import stats
np.random.seed(42)
hours = np.random.uniform(0, 10, 100).round(1)
marks = (40 + 5 * hours + np.random.normal(0, 8, 100)).clip(0, 100).round()
df = pd.DataFrame({"hours": hours, "marks": marks})
print(df.head())
print(df.describe().round(2))
OUTPUT
   hours  marks
0    3.7   59.0
1    9.5   85.0
2    7.3   77.0
3    6.0   54.0
4    1.6   46.0
        hours   marks
count  100.00  100.00
mean     4.70   63.51
std      2.97   15.54
min      0.10   34.00
25%      1.95   51.00
50%      4.65   62.50
75%      7.30   76.00
max      9.90   98.00
Exercise 1: Central tendency aur spread
print("Marks mean   :", round(df["marks"].mean(), 2))
print("Marks median :", df["marks"].median())
print("Marks std    :", round(df["marks"].std(), 2))
print("IQR          :", df["marks"].quantile(0.75) - df["marks"].quantile(0.25))
print("Skewness     :", round(stats.skew(df["marks"]), 2))
OUTPUT Marks mean : 63.51 Marks median : 62.5 Marks std : 15.54 IQR : 25.0 Skewness : 0.27
Exercise 2: Z-score se outliers dhoondo
df["z"] = stats.zscore(df["marks"])
print("Outliers (|z| > 2):", (df["z"].abs() > 2).sum())
print(df[df["z"].abs() > 2])
OUTPUT
Outliers (|z| > 2): 2
    hours  marks         z
69    9.9   96.0  2.101208
80    8.6   98.0  2.230553
Exercise 3: Probability (data se)
print("P(marks >= 70)         :", (df["marks"] >= 70).mean())
print("P(marks >= 70 | hours > 6):", round((df[df["hours"] > 6]["marks"] >= 70).mean(), 3))
OUTPUT
P(marks >= 70)         : 0.35
P(marks >= 70 | hours > 6): 0.917
Dhyan do: sirf 6 ghantay se zyada parhne wale students me 70+ marks ki probability poori class ki probability se kaafi zyada hai. Ye conditional probability hai, aur ye bhi ek ishara hai ke parhai aur marks ka rishta hai (jis ka tajziya Week 11 me karenge).
Exercise 4: Normal distribution se andaza
from scipy.stats import norm
m, s = df["marks"].mean(), df["marks"].std()
print("Normal assumption par P(marks > 90):", round(1 - norm(m, s).cdf(90), 4))
print("Data me asli hissa                 :", (df["marks"] > 90).mean())
OUTPUT
Normal assumption par P(marks > 90): 0.0441
Data me asli hissa                 : 0.06
Challenge: Binomial se hal karo: agar ek student har sawal par 60% sahi jawab deta hai, to 20 sawalon me kam az kam 15 sahi hone ki probability kya hai? ( 1 - binom.cdf(14, 20, 0.6) )
AAM GALTIYAN
-
Mean ko hamesha sahi markaz samajhna. Outliers ya jhuke hue data me median behtar hai.
-
NumPy aur Pandas ke std ka default alag hona. Sample ho to ddof=1 .
-
P(A|B) aur P(B|A) ko ek samajhna (bimari wali misaal). Base rate bhool jana.
-
Samajh lena ke 10 flips me 7 head aaye to sikka kharab hai. Law of Large Numbers ke liye zyada tajurbe chahiye.
-
Har data ko Normal samajh lena. Pehle histogram aur skewness dekho.
KEY TAKEAWAYS
-
Descriptive statistics data ko bayan karti hai, inferential sample se population ka andaza lagati hai.
-
Center: mean, median, mode. Outliers me median behtar. Spread: range, variance, std, IQR.
-
Sample ke liye std me ddof=1. Z-score = (x - mean) / std.
-
Skewness data ka jhukao batati hai. Right skew me mean median se bara hota hai.
-
Probability 0 se 1. Rules: complement, addition, multiplication. Conditional aur Bayes ulte sawal hal karte hain.
-
Permutation me tarteeb ahem, combination me nahi. Law of Large Numbers: zyada tajurbe, asli probability ke qareeb.
-
Normal (68-95-99.7), Binomial (kamyab/nakam), Poisson (waqiye ki ginti). CLT: sample means ki taqseem Normal ban jati hai.