Chapter 11: Linear Regression aur Regression Project
MODULE 3 | WEEK 11
Chapter 11: Linear Regression aur Regression Project
Ab tak hum ne data ko bayan kiya aur daawon ko parakha. Ab sab se bara qadam: andaza lagana (prediction) . Linear Regression machine learning ka sab se pehla aur sab se zyada istemal hone wala algorithm hai. Isay samajh liya to aage ke bohat saray ML algorithms asaan lagenge. Pehle Covariance aur Correlation (do cheezon ka rishta), phir regression, aur aakhir me ek poora project.
11.1 Covariance aur Correlation
Kya do cheezein ek sath badalti hain? Maslan jab parhai ke ghantay barhte hain to marks bhi barhte hain? Is rishte ko napne ke do tareeqay hain.
Covariance
Covariance batati hai ke do cheezein ek sath badalti hain ya nahi, aur kis simt me.
-
Positive covariance: ek barhe to doosri bhi barhti hai.
-
Negative covariance: ek barhe to doosri ghatti hai.
-
Zero ke qareeb: koi seedha rishta nahi.
Mushkil ye hai ke covariance ka number units par depend karta hai (qad cm me napo ya meter me, number badal jata hai), isliye usay padh kar "rishta kitna mazboot hai" nahi bata sakte. Is masle ka hal correlation hai.
Correlation (Pearson r)
Correlation = covariance / (std of x x std of y) . Ye covariance ko standardize kar deta hai, is liye hamesha -1 se +1 ke beech rehta hai aur units ka asar khatam.
| r ki value | Matlab |
|---|---|
| +0.7 se +1 | Mazboot positive rishta |
| +0.3 se +0.7 | Darmiyana positive rishta |
| -0.3 se +0.3 | Kamzor ya koi (seedha) rishta nahi |
| -0.7 se -0.3 | Darmiyana negative rishta |
| -1 se -0.7 | Mazboot negative rishta |
import numpy as np
import pandas as pd
from scipy import stats
import matplotlib.pyplot as plt
np.random.seed(42)
hours = np.random.uniform(0, 10, 80)
marks = 40 + 5 * hours + np.random.normal(0, 8, 80)
print("Covariance:", np.cov(hours, marks)[0, 1].round(2))
print("Correlation:", np.corrcoef(hours, marks)[0, 1].round(3))
df = pd.DataFrame({"hours": hours, "marks": marks})
print(df.corr().round(3))
OUTPUT
Covariance: 50.08
Correlation: 0.906
       hours  marks
hours  1.000  0.906
marks  0.906  1.000
Pearson vs Spearman
-
Pearson: sirf seedhi lakeer (linear) wale rishte napta hai.
-
Spearman: values ki ranking (tarteeb) par chalta hai, is liye har ek taraf barhta rishta (monotonic) napta hai (seedha ho ya na ho) aur outliers se kam mutasir hota hai.
x = np.arange(1, 21)
y = x ** 3                               # barhta hai magar seedhi lakeer me nahi
print("Pearson :", round(stats.pearsonr(x, y)[0], 3))
print("Spearman:", round(stats.spearmanr(x, y)[0], 3))      # poora 1.0
OUTPUT
Pearson : 0.922
Spearman: 1.0
Alag alag rishton ki tasveer
np.random.seed(0)
n = 100
x = np.random.normal(0, 1, n)
cases = {
    "r = +0.9": 0.9 * x + np.random.normal(0, 0.45, n),
    "r = +0.5": 0.5 * x + np.random.normal(0, 0.87, n),
    "r = 0": np.random.normal(0, 1, n),
    "r = -0.5": -0.5 * x + np.random.normal(0, 0.87, n),
    "r = -0.9": -0.9 * x + np.random.normal(0, 0.45, n),
    "Rishta hai, magar r ~ 0": x ** 2 + np.random.normal(0, 0.2, n),
}
fig, axes = plt.subplots(2, 3, figsize=(10, 6))
for ax, (title, y) in zip(axes.ravel(), cases.items()):
    ax.scatter(x, y, s=12, color="#6B5B95", alpha=0.7)
    ax.set_title(f"{title}  (asli r = {np.corrcoef(x, y)[0, 1]:.2f})", fontsize=10)
plt.tight_layout()
plt.show()
OUTPUT (chart)
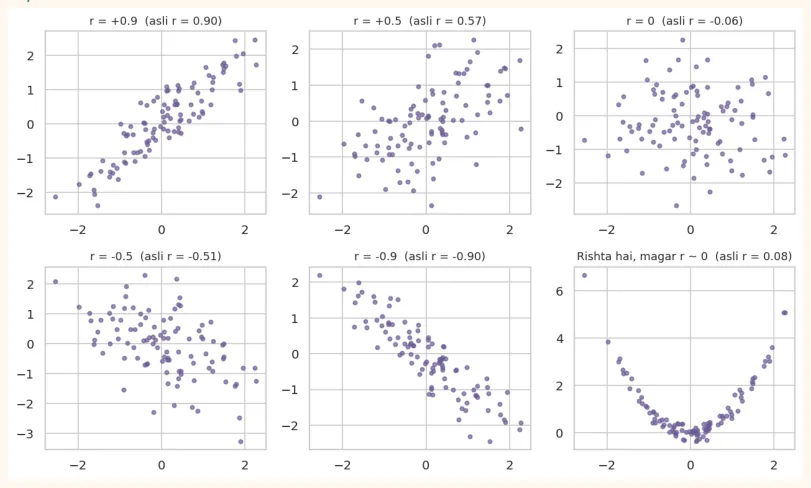
Aakhri chart bohat ahem sabaq hai: x aur y me wazeh rishta (U-shape) hai, magar Pearson r lagbhag 0 hai , kyunke ye seedhi lakeer wala rishta nahi . Isliye sirf number par bharosa na karo, hamesha scatter plot bhi dekho.
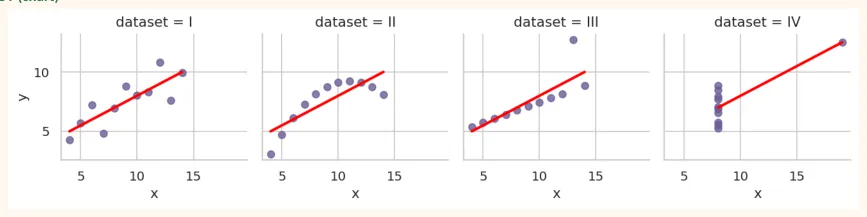
Anscombe's Quartet: chaar dataset, ek jaise numbers
Statistician Francis Anscombe ne chaar alag datasets banaye jin ke mean, variance, correlation aur regression line bilkul ek jaise hain, magar tasveer bilkul alag hai.
import seaborn as sns
anscombe = sns.load_dataset("anscombe")
summary = anscombe.groupby("dataset").agg(
x_mean=("x", "mean"), y_mean=("y", "mean"), y_std=("y", "std"))
summary["corr"] = anscombe.groupby("dataset").apply(lambda d: d["x"].corr(d["y"]),
include_groups=False)
print(summary.round(2))
OUTPUT
         x_mean  y_mean  y_std  corr
dataset
I           9.0     7.5   2.03  0.82
II          9.0     7.5   2.03  0.82
III         9.0     7.5   2.03  0.82
IV          9.0     7.5   2.03  0.82
sns.lmplot(data=anscombe, x="x", y="y", col="dataset", col_wrap=4, height=2.6,
           ci=None, scatter_kws={"color": "#6B5B95"}, line_kws={"color": "red"})
plt.show()
OUTPUT (chart)
ANSCOMBE KA SABAQ
Chaaron ke numbers ek jaise hain, magar pehla theek hai, doosra ghumavdar (curve) hai, teesre me ek outlier line ko kheench raha hai, aur chothe me sab kuch ek nuqtay par tika hai. Sabaq: modeling se pehle hamesha data ko plot karo.
11.2 Simple Linear Regression
Simple Linear Regression ek input (x) se ek output (y) ka andaza lagati hai, data me se ek seedhi lakeer guzar kar:
y = b0 + b1 x
-
y: jis cheez ka andaza lagana hai (target / dependent variable), jaise marks.
-
x: jis se andaza lagana hai (feature / independent variable), jaise parhai ke ghantay.
-
b1 (slope): x me 1 unit izafe par y me kitni tabdeeli aati hai.
-
b0 (intercept): jab x = 0 ho to y kya hoga.
Best line kaun si hai? (Least Squares)
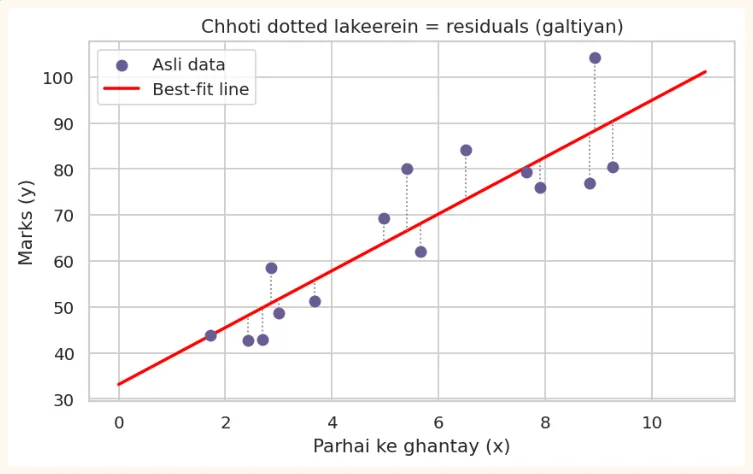
Data ke beech se hazaron lakeerein guzar sakti hain. Best wo hai jo galtiyon (residuals) ke squares ka jama sab se kam kare. Residual = asli y - andaza shuda y (yani har nuqtay ki lakeer se kitni door hai).
np.random.seed(5)
x = np.random.uniform(1, 10, 15)
y = 35 + 6 * x + np.random.normal(0, 7, 15)
b1, b0 = np.polyfit(x, y, 1)
pred = b0 + b1 * x
plt.figure(figsize=(7.5, 4.2))
plt.scatter(x, y, color="#6B5B95", s=45, zorder=3, label="Asli data")
xs = np.linspace(0, 11, 50)
plt.plot(xs, b0 + b1 * xs, color="red", linewidth=2, label="Best-fit line")
for xi, yi, pi in zip(x, y, pred):
    plt.plot([xi, xi], [yi, pi], color="gray", linestyle=":", linewidth=1)   # residual
plt.title("Chhoti dotted lakeerein = residuals (galtiyan)")
plt.xlabel("Parhai ke ghantay (x)")
plt.ylabel("Marks (y)")
plt.legend()
plt.show()
OUTPUT (chart)
Slope aur intercept ka formula
b1 = covariance(x, y) / variance(x) aur b0 = mean(y) - b1 x mean(x) . Teen tareeqon se nikal ke dekhte hain:
# 1) Hath se (formula)
b1_manual = np.cov(x, y, ddof=1)[0, 1] / np.var(x, ddof=1)
b0_manual = y.mean() - b1_manual * x.mean()
print("Manual   :", round(b1_manual, 3), round(b0_manual, 3))
# 2) NumPy polyfit (degree 1 = seedhi lakeer)
b1_np, b0_np = np.polyfit(x, y, 1)
print("polyfit  :", round(b1_np, 3), round(b0_np, 3))
# 3) SciPy linregress (r aur p-value bhi deta hai)
res = stats.linregress(x, y)
print("linregress:", round(res.slope, 3), round(res.intercept, 3),
      "| r =", round(res.rvalue, 3), "| p =", f"{res.pvalue:.2e}")
OUTPUT
Manual   : 6.182 33.15
polyfit  : 6.182 33.15
linregress: 6.182 33.15 | r = 0.883 | p = 1.28e-05
Teeno tareeqon ka jawab ek hi aaya. Ye hamein data me chhupi lakeer y = b0 + b1 x deta hai.
Interpretation (nateeje ka matlab)
print(f"Marks = {res.intercept:.1f} + {res.slope:.1f} x ghantay")
print("Slope:", round(res.slope, 2), "-> har 1 extra ghante par marks me taqreeban itna
izafa")
print("Intercept:", round(res.intercept, 1), "-> 0 ghantay parhne par andaza shuda marks")
new_hours = 8
print(f"{new_hours} ghantay par andaza:", round(res.intercept + res.slope * new_hours, 1))
OUTPUT
Marks = 33.1 + 6.2 x ghantay
Slope: 6.18 -> har 1 extra ghante par marks me taqreeban itna izafa
Intercept: 33.1 -> 0 ghantay parhne par andaza shuda marks
8 ghantay par andaza: 82.6
AAM GALTIYAN
-
Extrapolation: data ki range (jaise 1 se 10 ghantay) se bahar andaza lagana. 100 ghantay par "marks = 600" aaye ga, jo be-maani hai. Model sirf us range me bharosay ka hai jis par bana.
-
Intercept ko hamesha maani wala samajhna. Jab x = 0 mumkin hi na ho (jaise qad 0), to intercept ka koi asli matlab nahi.
-
Slope ko wajah samajh lena. Regression rishta batati hai, wajah sabit nahi karti.
R-squared (R<sup>2</sup> ): model kitna acha hai?
R<sup>2</sup> = 1 - (residuals ka jama) / (kul phailao) . Iska matlab: y ke phailao ka kitna hissa model samjha sakta hai .
-
R<sup>2</sup> = 0.8 matlab marks me jo farq hai uska 80% parhai ke ghanton se samjha ja sakta hai.
-
R<sup>2</sup> = 0 matlab model average se behtar nahi. R<sup>2</sup> = 1 matlab bilkul sahi.
-
Simple regression me R<sup>2</sup> = r<sup>2</sup> (correlation ka square).
pred = res.intercept + res.slope * x
ss_res = ((y - pred) ** 2).sum()           # residuals ka jama
ss_tot = ((y - y.mean()) ** 2).sum()       # kul phailao
r2 = 1 - ss_res / ss_tot
print("R-squared:", round(r2, 3), "| r**2:", round(res.rvalue ** 2, 3))
OUTPUT
R-squared: 0.78 | r**2: 0.78
11.3 statsmodels: regression ki poori report
Data Science me sirf andaza nahi, ye bhi jaanna zaroori hai ke har coefficient kitna bharosemand hai . statsmodels library ek poori statistical report deti hai. Formula API ("y ~ x") R language jaisi aasan hai.
import statsmodels.formula.api as smf
np.random.seed(42)
hours = np.random.uniform(0, 10, 100)
marks = 40 + 5 * hours + np.random.normal(0, 8, 100)
df = pd.DataFrame({"hours": hours, "marks": marks})
model = smf.ols("marks ~ hours", data=df).fit()
print(model.summary())
OUTPUT
OLS Regression Results
==============================================================================
Dep. Variable:                  marks   R-squared:                       0.785
Model:                            OLS   Adj. R-squared:                  0.782
Method:                 Least Squares   F-statistic:                     356.9
Date:                Tue, 13 Oct 2026   Prob (F-statistic):           1.95e-34
Time:                        11:52:00   Log-Likelihood:                -339.09
No. Observations:                 100   AIC:                             682.2
Df Residuals:                      98   BIC:                             687.4
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept     41.7208      1.362     30.625      0.000      39.017      44.424
hours          4.6322      0.245     18.892      0.000       4.146       5.119
==============================================================================
Omnibus:                        0.900   Durbin-Watson:                   2.285
Prob(Omnibus):                  0.638   Jarque-Bera (JB):                0.808
Skew:                           0.217   Prob(JB):                        0.668
Kurtosis: 2.929 Cond. No. 10.7
==============================================================================
Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly sp...
Report ko kaise parhein
| Hissa | Matlab |
|---|---|
| R-squared | Model ne marks ke phailao ka kitna hissa samjha |
| Adj. R-squared | R-squared ka wo roop jo faltu features ki saza deta hai (multiple regression me ahem) |
| coef(Intercept, hours) | b0 aur b1 (har x ka asar) |
| std err | Coefficient ka standard error: andaza kitna be-yaqeeni wala hai |
| **t aur P> | t |
| [0.025, 0.975] | Coefficient ka 95% confidence interval |
| F-statistic, Prob (F) | Poora model kaam ka hai ya nahi (kam az kam ek x ka asar hai?) |
Dekho kaise pichle chapters ka sab kuch (hypothesis test, p-value, confidence interval) yahan ek jagah aa gaya. Ye sab ko jorne wali cheez hai.
print("Coefficients:")
print(model.params.round(3))
print("\nP-values:")
print(model.pvalues.round(4))
print("\n95% CI:")
print(model.conf_int().round(3))
print("\nR-squared:", round(model.rsquared, 3))
OUTPUT
Coefficients:
Intercept    41.721
hours         4.632
dtype: float64
P-values:
Intercept    0.0
hours        0.0
dtype: float64
95% CI:
                0       1
Intercept  39.017  44.424
hours       4.146   5.119
R-squared: 0.785
# Naye data par andaza
new = pd.DataFrame({"hours": [2, 5, 9]})
print(model.predict(new).round(1))
OUTPUT
0    51.0
1    64.9
2    83.4
dtype: float64
11.4 Multiple Linear Regression
Asli zindagi me ek cheez (y) kai wajohat par depend karti hai. Multiple Linear Regression me kai inputs hote hain:
y = b0 + b1 x1 + b2 x2 + ... + bk xk
OUTPUT
        price         size  bedrooms        age       city
0  373.428765   728.924868         1   6.433031     Lahore
1  621.493903  2839.756377         3  29.361627     Lahore
2  531.945474  1815.227694         5  32.316518     Lahore
3  986.987204  2670.395533         3  27.956046  Islamabad
4  472.921537  3433.968536         5  38.593854    Karachi
m2 = smf.ols("price ~ size + bedrooms + age + C(city)", data=houses).fit()
print(m2.params.round(3))
print("R-squared:", round(m2.rsquared, 3), "| Adj R-squared:", round(m2.rsquared_adj, 3))
OUTPUT
Intercept | 601.643 |
|---|---|
C(city)[T.Karachi] | -594.459 |
C(city)[T.Lahore] | -386.205 |
size | 0.129 |
bedrooms | 40.920 |
age | -3.933 |
dtype: float64 | |
| `R-squared: 0.955 | ` |
Model ne asli coefficients ke qareeb numbers dhoond liye: size ka asar ~0.12, bedrooms ~40, age ~-4. C(city) ne shehar ko khud dummy variables (0/1 columns) me badal diya. Alphabet me pehla shehar ( Islamabad ) base category ban gaya, is liye Karachi aur Lahore ke coefficients Islamabad ke muqable me farq dikhate hain: Karachi lagbhag -600 aur Lahore lagbhag -400, jo hamare asli formula (Islamabad +600, Lahore +200, Karachi 0) ke farq se mel khate hain.
Coefficient ko kaise parhein
Multiple regression me har coefficient ka matlab hai: baqi sab cheezein barabar rakhte hue is x me 1 unit izafe par y me kitni tabdeeli. Maslan size ka 0.12 matlab agar kamron ki tadaad, umar aur shehar ek jaise hon to 1 square foot barhne par qeemat taqreeban 0.12 lakh barhti hai.
Adjusted R-squared kyun?
Jitne zyada features jorain, R<sup>2</sup> sirf barhta hai (chahe feature bekar ho). Adjusted R<sup>2</sup> faltu features ki saza deta hai, isliye models ke muqable ke liye behtar hai.
Multicollinearity (jab features aapas me bohat judte hon)
Agar do inputs aapas me bohat zyada correlated hon (jaise size in sq ft aur size in sq meter ) to model ye tay nahi kar pata ke asar kis ka hai, aur coefficients be-bharosa ho jate hain. Pehle correlation matrix dekho, aur VIF (Variance Inflation Factor; 5 se zyada ho to shak) bhi check karo.
from statsmodels.stats.outliers_influence import variance_inflation_factor
X = houses[["size", "bedrooms", "age"]].copy()
X.insert(0, "const", 1.0)
vif = pd.Series([variance_inflation_factor(X.values, i) for i in range(1, X.shape[1])],
                index=["size", "bedrooms", "age"])
print(vif.round(2))          # sab 5 se kam hon to theek
OUTPUT
size        1.01
bedrooms    1.01
age         1.01
dtype: float64
11.5 Regression ki assumptions aur Residual Plots
Linear regression tab bharosay ka hota hai jab data kuch shartein poori kare. Inhe yaad rakhne ka aasan tareeqa: LINE .
| Assumption | Kaise check karein | |
|---|---|---|
| L | **Linearity:**x aur y ka rishta seedhi lakeer jaisa ho | Scatter plot, residuals vs fitted plot me koi curve na ho |
| I | **Independence:**har observation doosre se aazad ho | Data kaise jama hua (time series me masla ho sakta hai) |
| N | **Normality:**residuals taqreeban Normal hon | Residuals ka histogram aur Q-Q plot |
| E | **Equal variance:**residuals ka phailao har jagah barabar ho (homoscedasticity) | Residuals vs fitted: beech me poora barabar patti jaisa pattern |
import statsmodels.api as sm
fitted = m2.fittedvalues
resid = m2.resid
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
axes[0].scatter(fitted, resid, color="#6B5B95", alpha=0.6, s=18)
axes[0].axhline(0, color="red", linestyle="--")
axes[0].set_title("Residuals vs Fitted\n(koi pattern nahi = achha)")
axes[0].set_xlabel("Fitted values")
axes[0].set_ylabel("Residuals")
axes[1].hist(resid, bins=20, color="#A4457A", edgecolor="white")
axes[1].set_title("Residuals ka histogram\n(ghanti jaisa = achha)")
sm.qqplot(resid, line="45", fit=True, ax=axes[2], markerfacecolor="#6B5B95", markersize=3)
axes[2].set_title("Q-Q plot\n(nuqtay lakeer par = Normal)")
plt.tight_layout()
plt.show()
OUTPUT (chart)
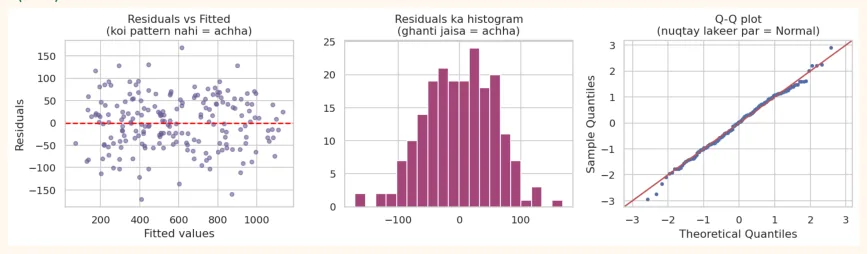
Ye teeno plots achhi halat dikhate hain. Ab dekho jab rishta seedhi lakeer ka nahi hota aur hum phir bhi seedhi lakeer fit kar dein to kya hota hai:
np.random.seed(3)
xc = np.random.uniform(0, 10, 100)
yc = 3 + 0.5 * xc ** 2 + np.random.normal(0, 3, 100)          # curve wala rishta
bad = smf.ols("y ~ x", data=pd.DataFrame({"x": xc, "y": yc})).fit()
fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))
axes[0].scatter(xc, yc, color="#6B5B95", s=15)
axes[0].plot(np.sort(xc), bad.predict(pd.DataFrame({"x": np.sort(xc)})), color="red")
axes[0].set_title("Seedhi lakeer curve ko nahi pakad rahi")
axes[1].scatter(bad.fittedvalues, bad.resid, color="#A4457A", s=15)
axes[1].axhline(0, color="black", linestyle="--")
axes[1].set_title("Residuals me U-shape pattern = Linearity fail")
plt.tight_layout()
plt.show()
OUTPUT (chart)
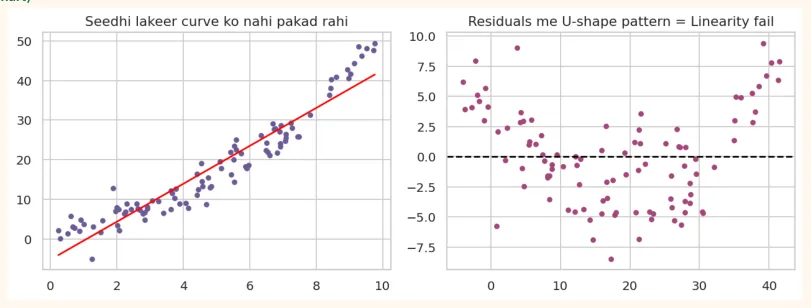
Residuals me wazeh U-shape pattern hai, jo batata hai ke seedhi lakeer is data ke liye ghalat model hai. Hal: x ka square ( x ** 2 ) jorain (polynomial regression), ya log transform lagayen, ya koi aur algorithm (Decision Tree, Random Forest) use karen jo aglay modules me aayenge.
11.6 Evaluation Metrics aur Train/Test Split
Model ko usi data par parakhna jis par wo seekha hai dhoka hai. Jaise tumne exam se pehle wohi sawal yaad kar liye jo paper me aane the, aur number achhe aa gaye, magar naye sawal par kya hoga? Isliye hum data ko do hisson me batte hain:
-
Train set (aam taur par 80%): model isi se seekhta hai.
-
Test set (20%): model ne ye kabhi nahi dekha. Isi par asli kaarkardagi napte hain.
| Metric | Formula / Idea | Matlab |
|---|---|---|
| MAE | Mean Absolute Error: | asli - andaza |
| Metric | Formula / Idea | Matlab |
|---|---|---|
| MSE | Mean Squared Error: (asli - andaza)<sup>2</sup>ka average | Bari galtiyon ko zyada saza deta hai |
| RMSE | sqrt(MSE) | MSE jaisa magar original units me, sab se aam |
| R<sup>2</sup> | 1 - SSres / SStot | Model ne kitna phailao samjha (1 behtar) |
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
X = pd.get_dummies(houses[["size", "bedrooms", "age", "city"]], drop_first=True)
y = houses["price"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print("Train:", X_train.shape, "| Test:", X_test.shape)
model_sk = LinearRegression().fit(X_train, y_train)
pred = model_sk.predict(X_test)
print("MAE :", round(mean_absolute_error(y_test, pred), 2))
print("RMSE:", round(np.sqrt(mean_squared_error(y_test, pred)), 2))
print("R2 (test) :", round(r2_score(y_test, pred), 3))
print("R2 (train):", round(model_sk.score(X_train, y_train), 3))
OUTPUT
Train: (160, 5) | Test: (40, 5)
MAE : 56.39
RMSE: 71.14
R2 (test) : 0.931
R2 (train): 0.961
DONO KE FARQ
Is chapter me statsmodels (statistics: p-values, interpretation) aur scikit-learn (machine learning: prediction, train/test) dono dekhe. Statistics ka mizaaj samajhna hai, ML ka mizaaj andaza lagana . Dono ki zaroorat hai.
11.7 Regression Model Project: Gari ki Fuel Efficiency (mpg)
Sawal: ek gari ki fuel efficiency (mpg: miles per gallon) ka andaza uski khasusiyat (wazan, horsepower, model ka saal waghera) se lagao, aur ye samjho ke kaunsi cheez efficiency par sab se zyada asar daalti hai. Data: 398 garian (seaborn ka mpg dataset).
Step 1: Data load aur inspect
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import statsmodels.formula.api as smf
cars = sns.load_dataset("mpg")
print(cars.shape)
print(cars.isnull().sum()[cars.isnull().sum() > 0])
print(cars.head(3))
OUTPUT
(398, 9)
horsepower    6
dtype: int64
    mpg  cylinders  displacement  horsepower  weight  acceleration  \
0  18.0          8         307.0       130.0    3504          12.0
1  15.0          8         350.0       165.0    3693          11.5
2  18.0          8         318.0       150.0    3436          11.0
   model_year origin                       name
0          70    usa  chevrolet chevelle malibu
1          70    usa          buick skylark 320
2          70    usa         plymouth satellite
Step 2: Cleaning
horsepower me 6 missing values hain. Sirf 6 rows (1.5%) hain, isliye unhe hata dena theek hai.
cars = cars.dropna().reset_index(drop=True)
print(cars.shape)
print(cars[["mpg", "weight", "horsepower", "acceleration",
"model_year"]].describe().round(1))
OUTPUT
(392, 9)
         mpg  weight  horsepower  acceleration  model_year
count  392.0   392.0       392.0         392.0       392.0
mean    23.4  2977.6       104.5          15.5        76.0
std      7.8   849.4        38.5           2.8         3.7
min      9.0  1613.0        46.0           8.0        70.0
25%     17.0  2225.2        75.0          13.8        73.0
50%     22.8  2803.5        93.5          15.5        76.0
75%     29.0  3614.8       126.0          17.0        79.0
max     46.6  5140.0       230.0          24.8        82.0
Step 3: EDA
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
sns.histplot(cars["mpg"], bins=25, kde=True, ax=axes[0], color="#6B5B95")
axes[0].set_title("mpg ki taqseem")
sns.scatterplot(data=cars, x="weight", y="mpg", hue="origin", ax=axes[1])
axes[1].set_title("Wazan aur mpg")
sns.heatmap(cars[["mpg", "cylinders", "displacement", "horsepower", "weight",
"acceleration", "model_year"]].corr(),
            annot=True, fmt=".2f", cmap="coolwarm", vmin=-1, vmax=1, ax=axes[2],
annot_kws={"size": 7})
axes[2].set_title("Correlation")
plt.tight_layout()
plt.show()
OUTPUT (chart)
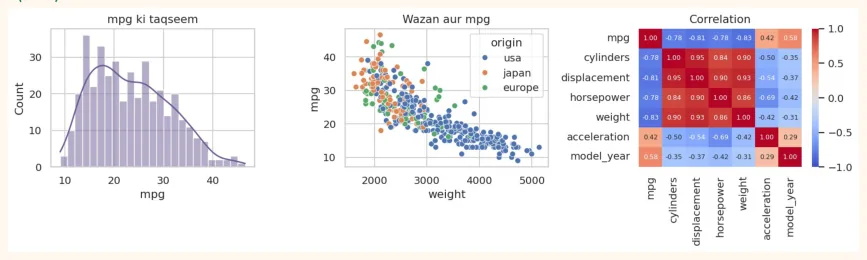
Observations: mpg ka wazan ke saath mazboot negative rishta hai (bhari gari = kam mileage). displacement, horsepower, cylinders aur weight aapas me bhi bohat correlated hain (multicollinearity ka khatra). Rishta mukammal seedhi lakeer jaisa nahi, thora jhuka hua hai.
Step 4: Model 1, sirf wazan se
m1 = smf.ols("mpg ~ weight", data=cars).fit()
print(m1.params.round(4))
print("R-squared:", round(m1.rsquared, 3))
print("Har 1000 pound wazan barhne par mpg me tabdeeli:", round(m1.params["weight"] * 1000,
2))
OUTPUT
Intercept    46.2165
weight       -0.0076
dtype: float64
R-squared: 0.693
Har 1000 pound wazan barhne par mpg me tabdeeli: -7.65
Step 5: Model 2, kai features
m2 = smf.ols("mpg ~ weight + horsepower + acceleration + model_year + C(origin)",
data=cars).fit()
print(m2.summary().tables[1])
print("R-squared:", round(m2.rsquared, 3), "| Adj R-squared:", round(m2.rsquared_adj, 3))
OUTPUT
|===============================coef-------------------------------|=======================================================std err t P>|t| [0.025 0.975]-------------------------------------------------------|
|---|---|
|Intercept -16.0654|4.562 -3.522 0.000 -25.035 -7.096|
|C(origin)[T.japan] 0.3326|0.569 0.585 0.559 -0.785 1.451|
|C(origin)[T.usa] -1.9363|0.521 -3.715 0.000 -2.961 -0.912|
|weight -0.0057|0.001 -11.252 0.000 -0.007 -0.005|
|horsepower -0.0048|0.013 -0.360 0.719 -0.031 0.021|
|acceleration 0.0392|0.098 0.401 0.689 -0.153 0.231|
|model_year 0.7554===============================|0.052 14.617 0.000 0.654 0.857=======================================================|
|R-squared: 0.819 | Adj R-square|d: 0.817|
p-values dekho: jin features ka p-value 0.05 se bara hai (jaise acceleration aur horsepower ) unka asar baqi cheezon ke saath mil kar sabit nahi hota , kyunke weight aur model_year pehle hi zyada tar asar samjha dete hain. weight aur model_year ka asar mazboot hai (model_year ka positive coefficient batata hai ke naye saal ki garian zyada fuel-efficient hain).
Step 6: Train/Test par parakh
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
features = pd.get_dummies(cars[["weight", "horsepower", "acceleration", "model_year",
"origin"]], drop_first=True)
target = cars["mpg"]
X_tr, X_te, y_tr, y_te = train_test_split(features, target, test_size=0.2, random_state=42)
lr = LinearRegression().fit(X_tr, y_tr)
p = lr.predict(X_te)
print("MAE :", round(mean_absolute_error(y_te, p), 2), "mpg")
print("RMSE:", round(np.sqrt(mean_squared_error(y_te, p)), 2), "mpg")
print("R2 train:", round(lr.score(X_tr, y_tr), 3), "| R2 test:", round(r2_score(y_te, p),
3))
OUTPUT
MAE : 2.51 mpg
RMSE: 3.34 mpg
R2 train: 0.826 | R2 test: 0.781
Step 7: Residuals aur actual vs predicted
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].scatter(y_te, p, color="#6B5B95", alpha=0.7)
lims = [y_te.min(), y_te.max()]
axes[0].plot(lims, lims, color="red", linestyle="--")
axes[0].set_xlabel("Asli mpg")
axes[0].set_ylabel("Andaza shuda mpg")
axes[0].set_title("Actual vs Predicted (lakeer ke qareeb = achha)")
axes[1].scatter(p, y_te - p, color="#A4457A", alpha=0.7)
axes[1].axhline(0, color="black", linestyle="--")
axes[1].set_xlabel("Andaza shuda mpg")
axes[1].set_ylabel("Residual")
axes[1].set_title("Residuals vs Predicted")
plt.tight_layout()
plt.show()
OUTPUT (chart)
Step 8: Behtar kaise karein? (ek aur koshish)
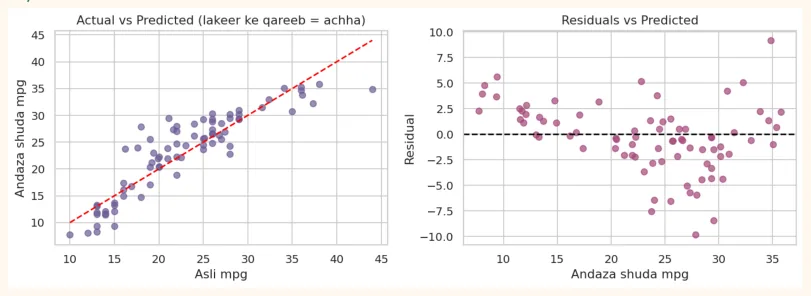
Residual plot me halka sa pattern nazar aa sakta hai (rishta thora jhuka hua hai). Ek aam hal: target ka log lena. Dono models ko ek jaisi features aur ek jaise test set par muqable me rakhte hain, aur RMSE mpg ki original scale par napte hain (log model ke andaze ko np.exp se wapas mpg me badal kar).
train, test = train_test_split(cars, test_size=0.2, random_state=42)
feats = "weight + model_year + C(origin)"
lin = smf.ols("mpg ~ " + feats, data=train).fit()
log = smf.ols("np.log(mpg) ~ " + feats, data=train).fit()
def rmse(a, b):
    return float(np.sqrt(np.mean((a - b) ** 2)))
print("Linear model RMSE:", round(rmse(test["mpg"], lin.predict(test)), 2), "mpg")
print("Log model RMSE   :", round(rmse(test["mpg"], np.exp(log.predict(test))), 2), "mpg")
OUTPUT
Linear model RMSE: 3.33 mpg
Log model RMSE   : 2.75 mpg
Log lene se test RMSE kam hua, yani is data me log transform ne andaza behtar kiya. Ye dikhata hai ke model ek bar bana kar chor dena nahi hota, balke tajurba karke behtar banaya jata hai.
Step 9: Report (nateeja likhna)
Apne project ki README ya report me ye hissay zaroor likho:
-
Maqsad: mpg ka andaza aur asar dalne wali cheezein.
-
Data: 398 garian, 6 rows missing hone ki wajah se hata di gayin (392 bachin).
-
EDA ke nateejay: weight aur mpg me mazboot negative rishta, features aapas me correlated.
-
Models: Model 1 (sirf weight), Model 2 (kai features), Model 3 (log mpg). Har ka R<sup>2</sup> , test RMSE.
-
Sab se ahem asar: weight aur model_year (coefficients aur p-values ke saath).
-
Hadood (limitations): purane data (1970 se 1982), rishta mukammal seedha nahi, features aapas me correlated.
-
Agla qadam: Module 4 me Decision Tree/Random Forest se muqabla.
11.8 Hands-on
# Dataset: seaborn ka 'tips'
tips = sns.load_dataset("tips")
print(tips[["total_bill", "tip", "size"]].corr().round(2))
OUTPUT
            total_bill   tip  size
total_bill        1.00  0.68  0.60
tip               0.68  1.00  0.49
size              0.60  0.49  1.00
-
Simple regression: tip ~ total_bill fit karo. Slope aur R<sup>2</sup> batao. Slope ka matlab apne alfaz me likho.
-
Prediction: 40 dollar ke bill par tip ka andaza lagao.
-
Multiple regression: tip ~ total_bill + size + C(smoker) + C(day) . Kaunse features ka p-value 0.05 se kam hai?
-
Residual plot: residuals vs fitted banao. Kya koi pattern hai? (Hint: bade bills par phailao barhta hai)
-
Train/Test: 80/20 split karke RMSE aur R<sup>2</sup> nikalo.
-
Sochne wala sawal: kya bill ka barhna tip barhne ki wajah hai? Confounding variable kya ho sakta hai?
Challenge: Chapter 9 ka hours/marks dataset lo, usme ek outlier (hours = 9, marks = 10) daal kar regression dobara chalao. Slope aur R<sup>2</sup> kitna badal gaye? Isse outliers ke asar ka andaza hoga.
KEY TAKEAWAYS
-
Covariance simt batati hai, correlation (-1 se +1) mazbooti bhi. Pearson seedhe rishte ke liye, Spearman monotonic ke liye.
-
Correlation matlab causation nahi. Anscombe ka sabaq: modeling se pehle data plot karo.
-
Simple linear regression: y = b0 + b1 x. Slope = x me 1 unit izafe par y ki tabdeeli. Least squares residuals ke squares ka jama kam karti hai.
-
R-squared: model ne y ke phailao ka kitna hissa samjha. Extrapolation se bacho.
-
statsmodels ki report me coef, std err, p-value, confidence interval, R-squared aur F-test hote hain.
-
Multiple regression me coefficient ka matlab: baqi sab barabar rakhte hue us x ka asar. Adjusted R-squared aur VIF dekho.
-
Assumptions (LINE): Linearity, Independence, Normality of residuals, Equal variance. Residual plots se check karo.
-
Metrics: MAE, MSE, RMSE, R-squared. Hamesha test set par parakho (train/test split).