Chapter 10: Inferential Statistics aur Hypothesis Testing
MODULE 3 | WEEK 10
Chapter 10: Inferential Statistics aur Hypothesis Testing
Pichle chapter me hum ne data ko bayan karna seekha. Ab sawal ye hai: jo kuch hamare sample me nazar aa raha hai, kya wo poori population ke baare me bhi sach hai, ya sirf ittefaq (luck)? Isi sawal ka jawab Inferential Statistics deti hai. Ye company ke faislon, medical research, A/B testing aur ML model ke muqabley, sab me kaam aati hai.
10.1 Sampling aur Standard Error
Hum aksar poori population se data nahi le sakte, to sample lete hain. Agar sample ghalat tareeqe se liya jaye to nateeja bhi ghalat aayega, chahe hisaab kitna bhi sahi ho.
| Sampling ka tareeqa | Kaise | Misaal |
|---|---|---|
| Simple Random | Har kisi ke chune jane ke barabar imkan | Sab students ke naam parchiyon me daal kar nikalna |
| Stratified | Pehle groups (strata) bana kar har group se random lena | Har department se 50 students |
| Systematic | Har k-th cheez chunna | Roll number list me har 10wa student |
| Cluster | Poore groups chun lena | 10 me se 3 classes ke sab students |
| Convenience (kharab) | Jo aasani se mil jaye | Sirf apne dost se poochna |
DHYAN RAKHO
Sampling bias: agar "Pakistan ke log kitna internet use karte hain" ka survey sirf Facebook par kiya jaye to nateeja ghalat hoga, kyunke jo log online hi nahi un tak sawal hi nahi pohancha. Data jitna bhi bada ho, ghalat tareeqe se liya hua sample ghalat nateeja dega.
Sampling Distribution aur Standard Error
Ek sample ka mean ek number deta hai. Agar hum bar bar naye sample lein to har bar mean thora alag aayega. In sab means ki taqseem ko sampling distribution kehte hain. Iska std Standard Error (SE) kehlata hai:
SE = s / sqrt(n) (s = sample std, n = sample size)
OUTPUT
Population mean: 60.15
Ek sample ka mean: 63.23
Means ka mean   : 60.19
Means ka std    : 2.69
Formula 15/sqrt(30): 2.74
Dekho: sample means ka std ( SE ) lagbhag formula sigma / sqrt(n) ke barabar aaya. Aur n barhane se SE kam hota hai, yani zyada data = zyada pakka andaza.
10.2 Confidence Interval (CI)
Sirf ek number ("sample ka average 63") dena kafi nahi. Behtar ye hai ke ek range do jis me asli population ka mean ghaliban hoga. Isay Confidence Interval kehte hain.
CI = sample mean +/- (critical value x SE)
OUTPUT
Sample mean: 61.20
95% CI: (54.90, 67.51)
t-distribution kyun? Jab sample chhota ho (aam taur par 30 se kam) aur population ka std na pata ho to tdistribution use hota hai. Ye Normal jaisi hi hai, bas dum thori bhari, taake chhote sample ki be-yaqeeni shamil ho. n barhne par t aur Normal ek jaise ho jate hain.
95% Confidence ka asli matlab
Ye sab se zyada ghalat samjhi jane wali baat hai. Ghalat: "asli mean is range me 95% probability se hai". Sahi: "agar hum ye tareeqa bar bar dohrayen to 95% intervals asli mean ko pakad lenge". Ye dekh kar samajhna aasan hai:
import matplotlib.pyplot as plt
np.random.seed(8)
true_mean = 60
miss = 0
plt.figure(figsize=(8, 5))
for i in range(60):
    s = np.random.choice(population, 25)
    lo, hi = stats.t.interval(0.95, 24, loc=s.mean(), scale=stats.sem(s))
    hit = lo <= true_mean <= hi
    miss += (not hit)
    plt.plot([lo, hi], [i, i], color="#2F7D4F" if hit else "#C0392B", linewidth=2)
    plt.plot(s.mean(), i, "o", color="black", markersize=2.5)
plt.axvline(true_mean, color="black", linestyle="--", label="Asli mean = 60")
plt.title(f"60 confidence intervals (surkh = asli mean miss, {miss} miss)")
plt.xlabel("Marks")
plt.yticks([])
plt.legend()
plt.show()
OUTPUT (chart)
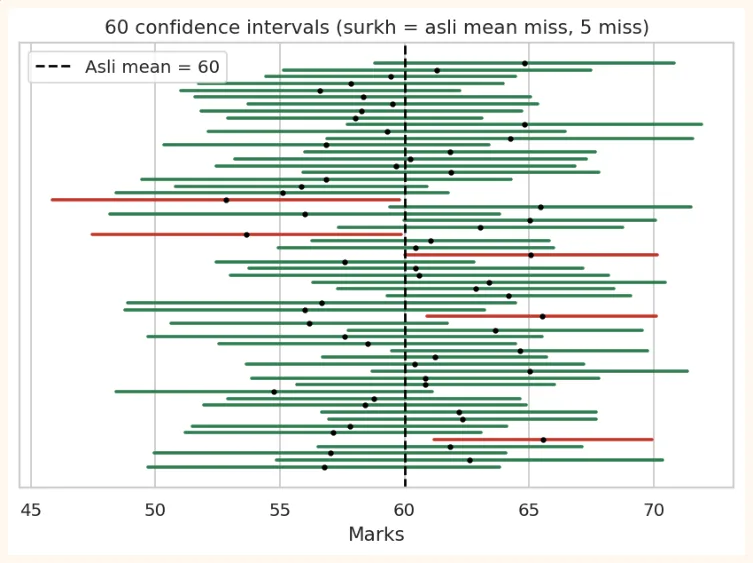
Zyada tar lakeerein (sabz) asli mean (kali lakeer) ko pakad leti hain, aur kuch (surkh) chook jati hain. 95% CI ka matlab hai ke lambay arse me lagbhag 95% intervals pakad lete hain.
CI ko kya chhota ya bara karta hai?
| Cheez | CI par asar |
|---|---|
| Sample size (n)barhana | CItang(zyada pakka andaza) |
| Data me phailao (std)zyada | CIchora |
| Confidence levelbarhana(95% se 99%) | CIchora(zyada yaqeen ke liye zyada range) |
for n in [10, 30, 100, 1000]:
    s = np.random.choice(population, n)
    lo, hi = stats.t.interval(0.95, n - 1, loc=s.mean(), scale=stats.sem(s))
    print(f"n = {n:>4}:  CI width = {hi - lo:.2f}")
OUTPUT
n =   10:  CI width = 16.23
n =   30:  CI width = 10.76
n =  100:  CI width = 6.36
n = 1000:  CI width = 1.95
10.3 Hypothesis Testing
Hypothesis testing ek tareeqa hai jis se hum data ki roshni me kisi daway (claim) ko parakhte hain.
Bunyadi alfaz
| Lafz | Matlab | Misaal |
|---|---|---|
| Null Hypothesis (H0) | "Koi farq / koi asar nahi" wala default daawa | H0: nayi dawai aur purani dawai ka asar ek jaisa hai |
| Alternative (H1) | Jo hum sabit karna chahte hain | H1: nayi dawai ka asar alag hai |
| Significance level (alpha) | Hum kitni ghalti bardasht karenge. Aam taur par 0.05 (5%) | alpha = 0.05 |
| p-value | Agar H0 sach ho, to itna (ya us se zyada) anokha data milne ki probability | p = 0.01 |
Faisla kaise hota hai
-
p-value < alpha (jaise 0.01 < 0.05): data H0 ke hisaab se bohat anokha hai. H0 ko radd karo (farq statistically significant hai).
-
p-value >= alpha (jaise 0.30): data H0 ke saath mel khata hai. H0 ko radd nahi kar sakte (saboot kaafi nahi).
SAB SE ZAROORI
p-value kya NAHI hai: ye "H0 ke sach hone ki probability" nahi hai, aur "hamare nateejay ke ghalat hone ki probability" bhi nahi. Ye sirf is sawal ka jawab hai: "agar koi farq hota hi nahi, to itna farq sirf ittefaq se dekhne ki kitni umeed thi?" . Chhota p-value = ittefaq ka imkan kam.
Hypothesis test ke 5 steps
-
H0 aur H1 likho.
-
alpha chuno (aam taur par 0.05).
-
Sahi test chuno (neeche table dekho) aur test statistic aur p-value nikalo.
-
p-value ki alpha se muqabla karke faisla karo.
-
Nateeja asaan alfaz me likho (statistics ke baghair kisi ko samajh aaye).
Type I aur Type II errors
| H0 asal me sach hai | H0 asal me ghalat hai | |
|---|---|---|
| H0 radd kiya | Type I error(false positive): begunah ko saza. Probability = alpha | Sahi faisla |
| H0 radd nahi kiya | Sahi faisla | Type II error(false negative): mujrim ko choor diya. Probability = beta |
One-tailed vs Two-tailed
-
Two-tailed: H1 kehta hai "farq hai" (zyada ya kam, koi bhi taraf). Aam tor par yehi use hota hai.
-
One-tailed: H1 kehta hai "zyada hai" ya "kam hai" (ek hi taraf). Sirf tab jab pehle se wazeh ho.
10.4 Alag alag Tests aur unka istemal
| Sawal | Test | scipy function |
|---|---|---|
| Ek group ka mean kisi dawe wali value ke barabar hai? | One-sample t-test | ttest_1samp |
| Do alag groups ke mean me farq hai? | Independent (two-sample) t-test | ttest_ind |
| Ek hi group ka pehle aur baad ka muqabla? | Paired t-test | ttest_rel |
| Teen ya zyada groups ke mean me farq hai? | One-way ANOVA | f_oneway |
| Do categorical cheezon me rishta hai? | Chi-square test of independence | chi2_contingency |
| Kya data Normal hai? | Shapiro-Wilk test | shapiro |
1) One-sample t-test
Sawal: ek school kehta hai ke uske students ka average 60 marks hai. Ek sample ne 40 students ke marks diye. Kya daawa theek hai?
np.random.seed(3)
sample = np.random.normal(64, 12, 40).round()      # 40 students ke marks
t_stat, p = stats.ttest_1samp(sample, popmean=60)
print("Sample mean:", sample.mean().round(2))
print("t =", round(t_stat, 3), "| p-value =", round(p, 4))
print("Faisla:", "H0 radd (farq significant)" if p < 0.05 else "H0 radd nahi kar sakte")
OUTPUT
Sample mean: 61.88
t = 0.97 | p-value = 0.3379
Faisla: H0 radd nahi kar sakte
2) Independent two-sample t-test
Sawal: Class A ke marks Class B se alag hain?
np.random.seed(4)
class_a = np.random.normal(68, 10, 35)
class_b = np.random.normal(62, 10, 35)
t_stat, p = stats.ttest_ind(class_a, class_b, equal_var=False)   # Welch t-test (behtar
default)
print("Mean A:", class_a.mean().round(2), "| Mean B:", class_b.mean().round(2))
print("t =", round(t_stat, 3), "| p-value =", round(p, 4))
print("Faisla:", "H0 radd (farq significant)" if p < 0.05 else "H0 radd nahi kar sakte")
OUTPUT
Mean A: 67.3 | Mean B: 64.05
t = 1.355 | p-value = 0.1799
Faisla: H0 radd nahi kar sakte
SABAQ
Ek dilchasp baat: is data me dono classes ke asli averages alag the (68 aur 62), magar sirf 35-35 students ke sample ki wajah se test ye farq pakad nahi saka (p-value 0.05 se bara). Yehi Type II error hai: asli farq maujood tha, magar saboot kaafi nahi the. Zyada students ka sample lete to farq nazar aa jata.
3) Paired t-test
Sawal: 25 students ne ek training se pehle aur baad me test diya. Kya training se marks barhe? (Ek hi log, do bar napa gaya.)
np.random.seed(6)
before = np.random.normal(55, 10, 25)
after = before + np.random.normal(4, 5, 25)        # thora izafa
t_stat, p = stats.ttest_rel(after, before)
print("Average izafa:", (after - before).mean().round(2))
print("t =", round(t_stat, 3), "| p-value =", round(p, 4))
print("Faisla:", "H0 radd (training ka asar hai)" if p < 0.05 else "H0 radd nahi kar sakte")
OUTPUT
Average izafa: 3.28
t = 3.349 | p-value = 0.0027
Faisla: H0 radd (training ka asar hai)
4) One-way ANOVA (teen ya zyada groups)
Sawal: teen alag tareeqon se parhaye gaye students ke marks me farq hai? Do se zyada groups par bar bar t-test karna ghalat hai (ghalti ka imkan barhta jata hai), isliye ANOVA use hota hai.
np.random.seed(9)
method1 = np.random.normal(60, 10, 30)
method2 = np.random.normal(66, 10, 30)
method3 = np.random.normal(72, 10, 30)
f_stat, p = stats.f_oneway(method1, method2, method3)
print("F =", round(f_stat, 3), "| p-value =", round(p, 5))
print("Faisla:", "Kam az kam ek group alag hai" if p < 0.05 else "Koi farq sabit nahi")
OUTPUT
F = 7.999 | p-value = 0.00065
Faisla: Kam az kam ek group alag hai
5) Chi-square test of independence (categories ka rishta)
Sawal: kya jins aur pasandeeda subject ka koi rishta hai? Is ke liye contingency table chahiye (har combination ki ginti).
observed = pd.DataFrame({"Math": [30, 20], "Arts": [15, 35]},
                        index=["Male", "Female"])
print(observed)
chi2, p, dof, expected = stats.chi2_contingency(observed)
print("chi2 =", round(chi2, 3), "| p-value =", round(p, 4), "| dof =", dof)
print("Faisla:", "Rishta hai" if p < 0.05 else "Rishta sabit nahi")
OUTPUT
        Math  Arts
Male      30    15
Female    20    35
chi2 = 7.919 | p-value = 0.0049 | dof = 1
Faisla: Rishta hai
6) Kya data Normal hai? (Shapiro-Wilk)
np.random.seed(2)
normal_data = np.random.normal(50, 5, 100)
skewed_data = np.random.exponential(5, 100)
print("Normal data p :", round(stats.shapiro(normal_data).pvalue, 4))
print("Skewed data p :", f"{stats.shapiro(skewed_data).pvalue:.2e}")
OUTPUT
Normal data p : 0.5678
Skewed data p : 1.22e-08
Yahan H0 = data Normal hai . Chhota p-value (< 0.05) ka matlab data Normal nahi hai. T-test aur ANOVA ke liye (khaaskar chhote samples me) data ka approximately Normal hona achha hota hai. Agar na ho to nonparametric tests (jaise Mann-Whitney U, stats.mannwhitneyu ) use hote hain.
10.5 A/B Testing
A/B testing company ki sab se aam hypothesis testing hai: do versions (A aur B) ko do random groups par chalao aur dekho ke kya koi asli farq hai.
OUTPUT
Rate A: 0.1 | Rate B: 0.125
z = -2.502 | p-value = 0.0124
Faisla: B ka farq significant hai
10.6 Aam ghaltiyan aur ahem ehtiyat
-
Statistical significance practical importance nahi: bohat bare sample me ek bohat chhota farq bhi "significant" nikal sakta hai (jaise average marks me 0.1 ka farq). Sirf p-value nahi, farq ka size (effect size) bhi dekho.
-
p-hacking: bohat saray tests chalana aur sirf jo "significant" aaye wo batana. 20 tests chalao to ek ittefaq se 0.05 se kam aa hi jayega.
-
H0 "sabit" nahi hota: "H0 radd nahi kar sakte" ka matlab "H0 sach hai" nahi. Bas saboot kaafi nahi.
-
Test ki sharaiet: har test ki kuch shartein hoti hain (Normal data, independence). Unhe dekhe baghair test lagana.
-
Correlation vs causation: sirf randomized experiment (jaise A/B test) hi wajah sabit kar sakta hai.
Effect size (Cohen's d) ka ek chhota sa nazara
def cohens_d(a, b):
na, nb = len(a), len(b)
    pooled = np.sqrt(((na - 1) * a.std(ddof=1) ** 2 + (nb - 1) * b.std(ddof=1) ** 2) / (na +
nb - 2))
return (a.mean() - b.mean()) / pooled
print("Cohen's d (class A vs B):", round(cohens_d(class_a, class_b), 2))
# Thumb rule: 0.2 chhota, 0.5 darmiyana, 0.8 bara farq
OUTPUT
Cohen's d (class A vs B): 0.32
AAM GALTIYAN
-
p-value ko "H0 ke sach hone ki probability" samajhna.
-
"p > 0.05" ko "koi farq nahi hai" samajhna. Sirf ye ke farq sabit nahi hua.
-
Teen ya zyada groups par bar bar t-test lagana (ANOVA use karo).
-
Paired data par independent t-test lagana (jaise ek hi bachon ke pehle/baad ke marks).
-
Bohat bare data me chhote farq ko "bohat ahem" samajhna.
-
Ek se zyada tests chala kar sirf kamyab wala batana (p-hacking).
10.7 Hands-on
Neeche ka data banao aur sawalon ke jawab do:
np.random.seed(100)
men = np.random.normal(172, 7, 50)        # mardon ke qad (cm)
women = np.random.normal(160, 6, 50)      # auraton ke qad (cm)
print(men.mean().round(1), women.mean().round(1))
OUTPUT
171.7 159.0
Exercise 1: Confidence Interval
lo, hi = stats.t.interval(0.95, len(men) - 1, loc=men.mean(), scale=stats.sem(men))
print(f"Mardon ke qad ka 95% CI: ({lo:.1f}, {hi:.1f})")
OUTPUT
Mardon ke qad ka 95% CI: (169.8, 173.6)
Exercise 2: One-sample test
Kya mardon ka average qad 170 cm hai? (H0: mu = 170)
t, p = stats.ttest_1samp(men, 170)
print("p-value:", round(p, 4), "->", "H0 radd" if p < 0.05 else "H0 radd nahi")
OUTPUT
p-value: 0.0746 -> H0 radd nahi
Exercise 3: Two-sample test aur effect size
t, p = stats.ttest_ind(men, women, equal_var=False)
print("p-value:", p)
print("Cohen's d:", round(cohens_d(men, women), 2))
OUTPUT
p-value: 1.2012679922177802e-16
Cohen's d: 2.0
Exercise 4: A/B test
Ek email subject line A par 120/1000 logon ne email kholi, B par 150/1000 ne. proportions_ztest se faisla karo aur nateeja do jumlon me likho.
z, p = proportions_ztest(np.array([120, 150]), np.array([1000, 1000]))
print("p-value:", round(p, 4))
OUTPUT
p-value: 0.0496
Dhyan do: p-value 0.05 ke bohat qareeb hai. Aisi sarhad par faisla karna mushkil hota hai. Behtar hai ke test zyada visitors par dobara chalao ya effect size aur CI bhi dekho, aur sirf "significant" lafz par bharosa na karo.
KEY TAKEAWAYS
-
Inferential statistics sample se population ka andaza lagati hai. Sample ka tareeqa sahi (random) hona chahiye.
-
Standard Error = s / sqrt(n). Sample size barhane se SE kam hota hai, andaza behtar hota hai.
-
95% Confidence Interval ka matlab: ye tareeqa bar bar dohrayen to 95% intervals asli value ko pakadte hain.
-
Hypothesis test: H0 (koi farq nahi) aur H1. p-value < alpha (0.05) to H0 radd. p-value H0 ke sach hone ki probability nahi.
-
Type I = jhoota alarm (alpha). Type II = alarm na bajna (beta).
-
Tests: ttest_1samp, ttest_ind (Welch), ttest_rel (paired), f_oneway (ANOVA), chi2_contingency, shapiro.
-
Significance aur practical importance alag hain: effect size zaroor dekho. p-hacking se bacho.