Chapter 41: Big Data
MODULE 7 | WEEK 41
Chapter 41: Big Data
Ab tak tumne jo data dekha wo tumhare laptop ki RAM me aa jata tha (Excel sheet, CSV, Pandas DataFrame). Magar asli duniya me Daraz, Careem, Jazz, banks aur YouTube jaisi companies roz TB (terabyte) aur PB (petabyte) data banati hain, jo ek computer me samata hi nahi. Is chapter me hum seekhenge ke Big Data kya hai , ek computer kyun kam parta hai, aur data ko kai computers par bant kar kaise sambhala jata hai ( HDFS, MapReduce, partitioning, batch aur streaming ). Pehle har idea chhote Python code se hath se samjhenge, phir Chapter 42 me Apache Spark me wohi kaam asaani se karenge.
41.1 Big Data kya hai?
Big Data us data ko kehte hain jo itna bara, itni tezi se aane wala ya itna mukhtalif ho ke ek computer aur purane tools (jaise Excel ya ek database) use sambhal na sakein. Sirf "bara" hona kaafi nahi; data ki 5 khasusiyaat dekhi jati hain, jinhein 5 V kehte hain.
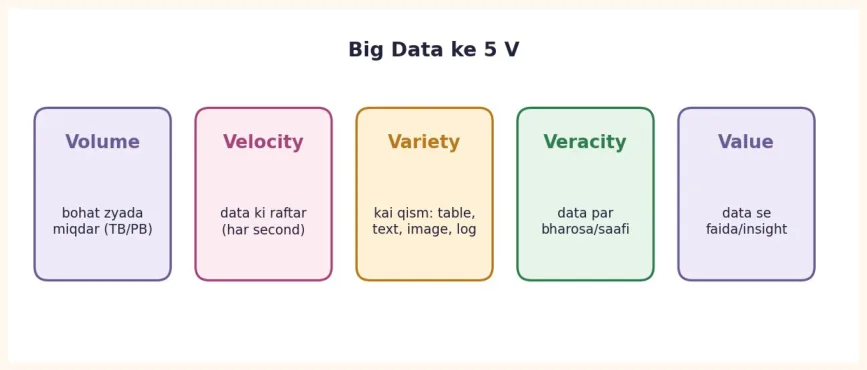
| V | Matlab | Misaal |
|---|---|---|
| Volume | Data ki miqdar (GB se TB, PB) | Ek bank ke saalon ke transactions; YouTube par roz upload hone wali videos |
| Velocity | Data kitni tezi se aa raha hai | Har second hazaron UPI/Easypaisa transactions, Twitter/X posts |
| Variety | Data ki kai shaklein | Table (structured), JSON/log (semi-structured), image/video/audio (unstructured) |
| Veracity | Data par kitna bharosa hai (galat, adhura, duplicate) | Sensor ki ghalat reading, ek customer ke do record |
| Value | Data se kaam ki baat nikalna | Fraud pakadna, sahi product dikhana, traffic ka andaza |
41.2 Ek computer kyun kam parta hai? Scale up vs Scale out
Jab data barhta hai to do raaste hote hain:
| Scale Up (Vertical) | Scale Out (Horizontal) | |
|---|---|---|
| Kaise | Ek hi computer ko taqatwar banao (zyada RAM, CPU, bara disk) | Bohat se aam computers ko jod do (cluster) |
| Had | Ek had ke baad mehnga aur namumkin | Zaroorat par aur machines jodte jao |
| Kharabi | Ek machine kharab = sab kuch band | Ek machine kharab = baqi kaam karte rahte hain |
| Misaal | 16 GB laptop se 256 GB server | 100 sasti machines ka cluster |
| Big Data me | Kam istemal | Yehi standard hai(Hadoop, Spark) |
Ek chhota hisaab dekhte hain: 1 TB data ek disk se parhne me kitna waqt lagega agar disk 200 MB/second ki raftar se parhe, aur agar wohi data 10 ya 100 disks/machines par bata ho?
size_tb = 1
mb_per_sec = 200                      # ek disk ki raftar
total_mb = size_tb * 1024 * 1024
for disks in [1, 10, 100]:
    sec = total_mb / (mb_per_sec * disks)
    print(f"{disks:>3} disk: {sec:>7.0f} second = {sec/60:>5.1f} minute")
OUTPUT
  1 disk:    5243 second =  87.4 minute
 10 disk:     524 second =   8.7 minute
100 disk:      52 second =   0.9 minute
Ek machine par 1 TB parhne me takreeban 87 minute , jab ke 100 machines ek sath parhein to 1 minute se bhi kam . Yehi parallel (ek sath) kaam Big Data ki jaan hai.
41.3 Distributed Storage: HDFS
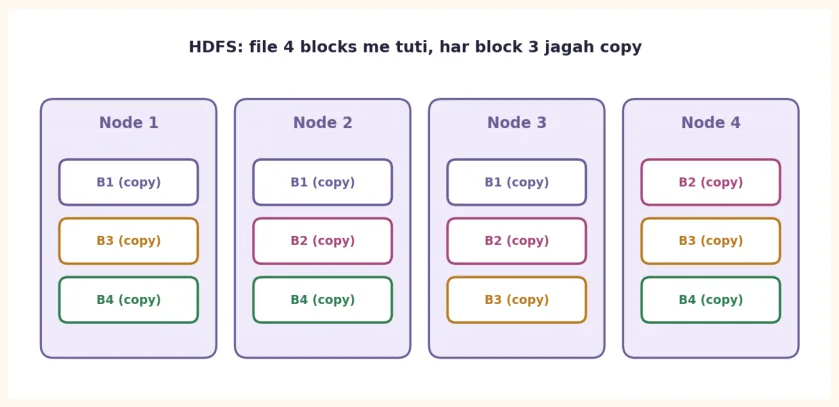
HDFS (Hadoop Distributed File System) ek aisa file system hai jo ek bari file ko tukron (blocks) me tor kar kai machines par rakhta hai . Iske teen bunyadi idea hain:
-
Blocks: file ko barabar tukron me torna (aam tor par 128 MB ka block).
-
Replication: har block ki 3 copies alag alag machines par (default). Ek machine kharab ho jaye to data zaya nahi hota.
-
NameNode aur DataNodes: NameNode "fehrist" rakhta hai (kaunsa block kis machine par hai), DataNodes asal blocks rakhte hain.
OUTPUT
Blocks ki tadaad: 4
B1 -> ['N2', 'N5', 'N4']
B2 -> ['N5', 'N4', 'N3']
B3 -> ['N5', 'N1', 'N3']
B4 -> ['N1', 'N4', 'N2']
N2 kharab: True
Do machines ek sath kharab: 10/10 surtoon me file safe
Chunke har block ki 3 copies hain, isliye koi bhi 2 machines ek sath kharab hon to bhi har block ki kam az kam ek copy bachti hai. Ye fault tolerance (kharabi bardasht karna) kehlata hai.
41.4 MapReduce: kaam ko bant kar karne ka tareeqa
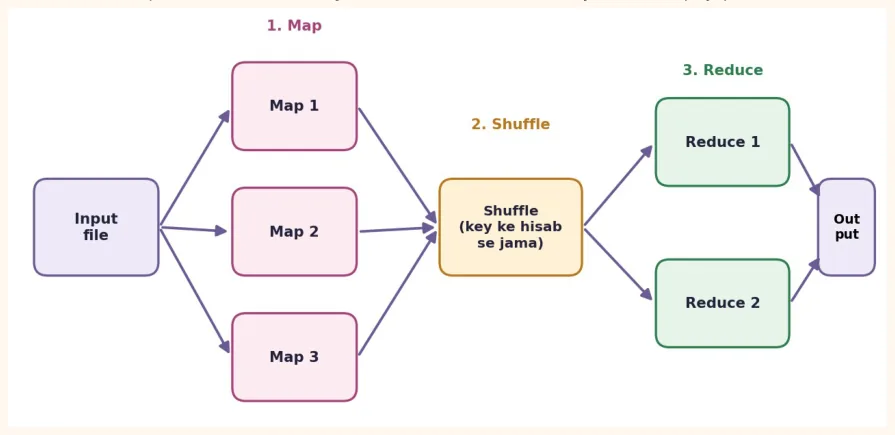
MapReduce ek programming model hai jo kisi bhi bare kaam ko 3 qadam me bantta hai:
-
Map: har machine apne hisse ke data par kaam kare aur (key, value) jode banaye.
-
Shuffle: wo jode jinki key ek jaisi hai unhein ek jagah jama kiya jaye.
-
Reduce: har key ke tamam values ko jod kar (sum, count, max) ek jawab banaya jaye.
Word Count: MapReduce ka "Hello World"
from collections import defaultdict
lines = ["spark tez hai",
"hadoop purana hai spark naya hai",
"big data hai"]
# 1) MAP:
har lafz ke liye (lafz, 1)
mapped = []
for line in lines:
    for word in line.split():
        mapped.append((word, 1))
        print("MAP    :", mapped[:4], "...")
        # 2) SHUFFLE: ek jaisi key ek jagah
        groups = defaultdict(list)
        for key, value in mapped:
            groups[key].append(value)
            print("SHUFFLE:")
            for key, vals in groups.items():
                print("   ", key, vals)
                # 3) REDUCE: har key ke values ka jama
                result = {key: sum(vals) for key, vals in groups.items()}
                print("REDUCE :")
                for key, total in result.items():
                    print("   ", key, total)
OUTPUT
MAP    : [('spark', 1), ('tez', 1), ('hai', 1), ('hadoop', 1)] ...
SHUFFLE:
    spark [1, 1]
    tez [1]
    hai [1, 1, 1, 1]
    hadoop [1]
    purana [1]
    naya [1]
    big [1]
    data [1]
REDUCE :
    spark 2
    tez 1
    hai 4
    hadoop 1
    purana 1
    naya 1
    big 1
    data 1
Asli Hadoop me Map aur Reduce alag alag machines par chalte hain aur beech ka data disk par likha jata hai, jis wajah se MapReduce sust hota hai. Isi kamzori ko door karne ke liye Spark aaya (Chapter 42).
41.5 Data ke formats: Row-based vs Columnar
Big Data me data ko kis shakal me rakha jaye ye bhi bohat ahem hai. Ek file ko do tareeqon se rakha ja sakta hai:
-
Row-based (CSV, JSON): ek row ke sare columns ek sath. Ek record dhoondne ya likhne ke liye acha.
-
Columnar (Parquet, ORC): ek column ki sari values ek sath. Analytics (sirf kuch columns ka sum/average) ke liye bohat tez aur chhota.
Maslan 1000 rows me se sirf amount column ka jama chahiye. Dekhte hain dono tareeqon me kitni values chhoo kar guzarni parti hain:
# row-store: har row = (id, city, amount, qty)
rows = [(i, "Karachi", 100 + i, 5) for i in range(1000)]
columns = {                                                # column-store
    "id":     [r[0] for r in rows],
    "city":   [r[1] for r in rows],
    "amount": [r[2] for r in rows],
    "qty":    [r[3] for r in rows],
}
# Row-store: har row poori parhni parti hai (4 values)
touched_row = sum(len(r) for r in rows)
total_row = sum(r[2] for r in rows)
# Column-store: sirf 'amount' column
touched_col = len(columns["amount"])
total_col = sum(columns["amount"])
print("Row-store   :", touched_row, "values chhui, jama =", total_row)
print("Column-store:", touched_col, "values chhui, jama =", total_col)
OUTPUT
Row-store   : 4000 values chhui, jama = 599500
Column-store: 1000 values chhui, jama = 599500
| Format | Qism | Khaas baat | Kab istemal karein |
|---|---|---|---|
| CSV | Row, text | Saada, har jagah khulta hai; bara aur sust | Chhota data, sharing |
| JSON | Row, text | Nested data rakh sakta hai; bara | APIs, logs |
| Parquet | Columnar, binary | Compressed, schema sath, sirf zaroori columns parhta hai | Big Data analytics ka standard |
| ORC | Columnar, binary | Parquet jaisa, Hive me aam | Hive/Hadoop ecosystem |
41.6 Partitioning aur Data Skew
Data ko machines me bantne ka kaam partitioning kehlata hai. Sab se aam tareeqa hash partitioning hai: har record ki key ka hash nikal kar hash % partitions se tay hota hai ke wo kis partition me jayega. Achi partitioning me har partition ke paas taqreeban barabar kaam hota hai.
def h(key):
    # saada deterministic hash
    v = 0
    for ch in str(key):
        v = (v * 31 + ord(ch)) % 1000003
    return v
def partition_sizes(keys, n=4):
    sizes = [0] * n
    for k in keys:
        sizes[h(k) % n] += 1
    return sizes
balanced = [f"cust{i}" for i in range(1000)]
skewed   = ["cust_hot"] * 600 + [f"cust{i}" for i in range(400)]
print("Balanced:", partition_sizes(balanced))
print("Skewed  :", partition_sizes(skewed))
OUTPUT
Balanced: [251, 249, 249, 251]
Skewed  : [102, 700, 98, 100]
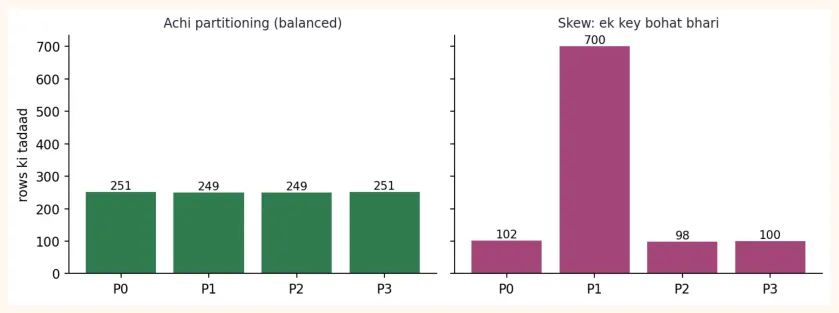
Doosri soorat me ek key ( cust_hot ) ke 600 records hain, to ek partition par sara bojh aa gaya aur baqi machines farigh baithi hain. Ye Data Skew hai: poora job sab se sust partition ke barabar sust ho jata hai. Hal: behtar key chunna, salting (key me random lafz jorna) ya skew wali key ko alag sambhalna.
41.7 Batch vs Streaming
| Batch | Streaming | |
|---|---|---|
| Data | Jama shuda, poori file/table | Musalsal aata hua (event by event) |
| Kab chalta hai | Waqt tay (har raat, har ghanta) | Har waqt, chand second ke andar |
| Latency | Minute se ghante | Millisecond se second |
| Misaal | Raat ko din bhar ki sales ka report | Card fraud ka foran alert, live traffic |
| Tools | Hadoop MapReduce, Spark | Kafka, Spark Structured Streaming, Flink |
Streaming me data ko aksar time window me bant kar ginte hain. Neeche 5 second ke tumbling windows ki chhoti si misaal hai:
# har event = (second, user)
events = [(1, "A"), (3, "B"), (4, "A"), (7, "A"), (8, "B"), (11, "A")]
window = 5
counts = {}
for t, user in events:
    start = (t // window) * window
    counts[start] = counts.get(start, 0) + 1
for start in sorted(counts):
    print(f"[{start:>2}s se {start + window:>2}s): {counts[start]} events")
OUTPUT
[ 0s se  5s): 3 events
[ 5s se 10s): 2 events
[10s se 15s): 1 events
41.8 Big Data Ecosystem ek nazar me
| Kaam | Tool | Ek line me |
|---|---|---|
| Storage | HDFS, S3, Azure Blob/ADLS | Bara data kai machines/cloud par rakhna |
| Kaam | Tool | Ek line me |
|---|---|---|
| Batch processing | Hadoop MapReduce,Apache Spark | Bare data par hisab kitab; Spark zyada tez |
| SQL on big data | Hive, Spark SQL, Presto/Trino, Athena | Bare data par SQL chalana |
| Messaging / ingest | Apache Kafka, Kinesis, Event Hubs | Live data ko pipeline me laana |
| Stream processing | Spark Structured Streaming,Flink | Live data par hisab |
| NoSQL database | MongoDB, Cassandra, HBase, DynamoDB | Bohat tez likhna/parhna, lachakdaar schema |
| Orchestration | Airflow, Azure Data Factory | Kaam ka silsila aur schedule |
41.9 Data Lake vs Data Warehouse
| Data Warehouse | Data Lake | |
|---|---|---|
| Data ki shakal | Saaf, structured tables | Har qism ka raw data (CSV, JSON, image, log) |
| Schema | Pehle tay (schema-on-write) | Parhte waqt tay (schema-on-read) |
| Qeemat | Zyada | Kam (sasta object storage) |
| Kis ke liye | BI dashboards, reports | Data science, ML, raw archive |
| Misaal | Redshift, Synapse, BigQuery, Snowflake | S3, Azure Data Lake Storage |
Aaj ka rujhan Lakehouse hai: Data Lake ke sasta storage par Warehouse jaisi tables aur SQL (Delta Lake, Apache Iceberg). Is par Chapter 43-44 me bhi baat hogi.
41.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Har bare lagne wale data ko Big Data keh dena. Agar data aapke laptop me aa jata hai aur Pandas theek chal raha hai, to Pandas hi behtar hai.
-
Sirf Volume ko Big Data samajhna; Velocity aur Variety bhi utni hi ahem hain.
-
CSV ko hi har jagah rakhna ; analytics ke liye Parquet kai guna tez hai.
-
Partition key sochay bina chunna (skew ka masla).
-
Sochna ke replication backup ki jagah le leta hai. Replication kharabi se bachata hai, galti se delete ya corruption se nahi; backup alag zaroori hai.
Hands-on
- Scale: 41.2 me
size_tb = 10
aur
disks = 500
rakh kar hisaab lagao; kitna waqt laga?
- HDFS:
file_mb = 1000
aur
replicas = 2
karo. Kya ab bhi koi 2 machines ek sath kharab hone par file safe rehti hai? Kyun/kyun nahi?
-
MapReduce:
linesme apne pasandeeda 5 jumle daalo aur word count nikalo; sab se zyada aane wala lafz kaunsa hai? -
Columnar: row-store aur column-store me ab
qtyka average nikalo aur dekho kitni values chhui gayin. -
Skew:
skewedlist mecust_hotki tadaad 600 se 100 karo aur partition sizes dekho. -
Streaming:
window = 3
karo aur nateeja dekho.
KEY TAKEAWAYS
-
Big Data = bohat bara, tez ya mukhtalif data jo ek computer sambhal na sake: 5 V (Volume, Velocity, Variety, Veracity, Value).
-
Scale out (kai sasti machines) Big Data ka standard hal hai; scale up ki had hoti hai.
-
HDFS: file blocks me tutti hai aur har block ki 3 copies hoti hain ( fault tolerance ).
-
MapReduce: Map (key, value banao) -> Shuffle (key ke hisab se jama) -> Reduce (jama/ginti).
-
Analytics ke liye columnar formats (Parquet) row-based formats (CSV) se tez aur chhote hote hain.
-
Partitioning kaam bantti hai; data skew se ek machine par bojh aa jata hai.
-
Batch = jama data, Streaming = musalsal data; Data Lake (raw, sasta) vs Warehouse (saaf, structured).