Chapter 42: Apache Spark
MODULE 7 | WEEK 42
Chapter 42: Apache Spark
Chapter 41 me humne dekha ke bare data par kaam kai machines me bant kar hota hai, aur purana MapReduce har qadam ke baad data disk par likhta hai, isliye sust hai. Apache Spark wohi kaam memory (RAM) me karta hai aur Python, SQL, Scala aur Java me asaan API deta hai. Aaj dunya ki zyadatar Big Data companies Spark istemal karti hain. Is chapter me hum PySpark (Spark ka Python wala hissa) seekhenge: RDD, DataFrame, Spark SQL, lazy evaluation, joins, window functions, performance aur Parquet , aur aakhir me MLlib ka ek chhota sa nazara.
42.1 Spark kya hai aur tez kyun hai?
Apache Spark ek open-source distributed computing engine hai jo bare data par tez aur parallel kaam karta hai. Is ke teen bare faide hain:
-
In-memory processing: darmiyani nateeje RAM me rehte hain, har qadam par disk par nahi likhe jate. Isi liye iterative kaam (machine learning) me MapReduce se kai guna tez.
-
Ek hi engine, kai kaam: batch, SQL, streaming, machine learning (MLlib), graph.
-
Asaan API: Python (PySpark), SQL, Scala, Java, R.
| Hissa | Kaam |
|---|---|
| Spark Core (RDD) | Buniyad: kaam bantna, memory, fault tolerance |
| Spark SQL / DataFrame | Table jaisa data aur SQL; sab se zyada istemal |
| Structured Streaming | Live data par wohi DataFrame code |
| MLlib | Distributed machine learning |
| GraphX | Graph ka analysis (Scala/Java) |
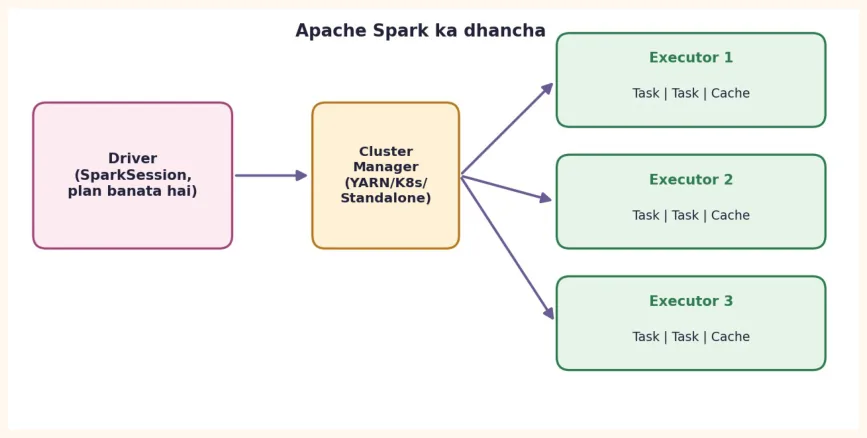
| Hissa | Kya karta hai |
|---|---|
| Driver | Tumhara program yahan chalta hai.SparkSessionyahin hota hai. Wo kaam kaplanbanata hai aur tasks bhejta hai. |
| Cluster Manager | Machines ke wasail (CPU/RAM) baantta hai (Standalone, YARN, Kubernetes). |
| Executor | Worker machines ke process jotasks chalatehain aur datacachekarte hain. |
| Task / Partition | Data ka ek tukra aur us par hone wala ek chhota kaam. Ek partition = ek task. |
42.2 Setup: SparkSession aur dataset
Colab me ek cell me install karo aur SparkSession banao. local[*] ka matlab hai ke apni ek machine ke sab cores istemal karo (seekhne ke liye kaafi hai; cluster par ye badal jata hai).
!pip install pyspark
from pyspark.sql import SparkSession
spark = (SparkSession.builder
         .appName("Module8")
         .master("local[*]")
         .getOrCreate())
print(spark.version)
OUTPUT (namoona; aap ka version alag ho sakta hai) 4.0.0
Ab hum is chapter aur Chapter 44 ke liye 5000 rows ka sales data banate hain. Ye code kahin bhi chalta hai (sirf Python), aur seed 42 ki wajah se har baar wohi data banta hai:
import random, csv
from datetime import date, timedelta
random.seed(42)
cities = ["Karachi", "Lahore", "Islamabad", "Quetta", "Peshawar"]
price_range = {"Mobile": (25000, 90000), "Laptop": (60000, 250000),
"Headphones": (2000, 15000), "Watch": (5000, 40000)}
start = date(2025, 1, 1)
with open("sales.csv", "w", newline="") as f:
    w = csv.writer(f)
    w.writerow(["order_id", "order_date", "city", "category",
    "qty", "unit_price", "customer_id"])
    for i in range(1, 5001):
        cat = random.choice(list(price_range))
        lo, hi = price_range[cat]
        d = start + timedelta(days=random.randint(0, 364))
        w.writerow([i, d.isoformat(), random.choice(cities), cat,
        random.randint(1, 4), random.randrange(lo, hi, 500),
        random.randint(1, 800)])
        print("sales.csv tayyar")
OUTPUT
sales.csv tayyar
Colab me file aur upar wala code ek hi jagah chalao ( Files panel me sales.csv nazar aa jayegi). Pehle 3 rows:
OUTPUT (namoona; sales.csv ki pehli 3 rows)
+--------+----------+---------+--------+---+----------+-----------+
|order_id|order_date|     city|category|qty|unit_price|customer_id|
+--------+----------+---------+--------+---+----------+-----------+
|       1|2025-01-13|Islamabad|  Mobile|  2|     53500|        143|
|       2|2025-12-13| Peshawar|  Mobile|  1|     79000|         33|
|       3|2025-02-17|   Lahore|  Mobile|  2|     89500|        617|
+--------+----------+---------+--------+---+----------+-----------+
42.3 RDD: Spark ki buniyad
RDD (Resilient Distributed Dataset) Spark ka sab se purana aur buniyadi data structure hai: ek list jo kai machines (partitions) par bati hui hai . Resilient ka matlab: koi machine kharab ho jaye to Spark yaad rakhe hue plan (lineage) se wo hissa dobara bana leta hai. Aaj kal hum zyada tar DataFrame istemal karte hain, magar RDD samajhna Spark ko samajhna hai.
sc = spark.sparkContext
lines = sc.parallelize([
"spark tez hai",
"hadoop purana hai spark naya hai",
"big data hai",
])
counts = (lines
.flatMap(lambda line: line.split())      # har jumla -> lafz
.map(lambda w: (w, 1))                   # (lafz, 1)
.reduceByKey(lambda a, b: a + b))        # key ke hisab se jama
print(counts.sortBy(lambda kv: (-kv[1], kv[0])).collect())
OUTPUT (namoona) [('hai', 4), ('spark', 2), ('big', 1), ('data', 1), ('hadoop', 1), ('naya', 1), ('purana', 1), ('tez', 1)]
Ye wohi Word Count hai jo humne Chapter 41 me hath se kiya tha; ab flatMap / map Map hai aur reduceByKey Shuffle + Reduce . Fark sirf ye hai ke Spark ye kaam khud kai machines par bant deta hai.
| Operation | Qism | Kya karta hai |
|---|---|---|
map(f) | Transformation | Har element par f lagata hai |
filter(f) | Transformation | Sirf wo elements rakhta hai jin par f True ho |
flatMap(f) | Transformation | Har element se 0 ya zyada elements banata hai |
reduceByKey(f) | Transformation (shuffle) | Ek jaisi key ke values jodta hai |
collect() | Action | Sara data driver ke paas le aata hai (bare data par khatarnak) |
count(),take(n) | Action | Ginti / pehle n elements |
42.4 DataFrame: table jaisa distributed data
DataFrame Pandas DataFrame jaisa lagta hai (rows aur named columns), magar andar se kai machines par bata hua hota hai aur Spark ka optimizer (Catalyst) is par kaam ko tez banata hai. Isi liye production me DataFrame/SQL hi pehli pasand hai.
CSV parhna (schema khud likho)
inferSchema=True data ko do baar parhta hai (sust), aur type galat bhi nikal sakta hai. Bare data me schema khud likhna behtar hai:
from pyspark.sql.types import (StructType, StructField, IntegerType,
StringType, DateType)
schema = StructType([
StructField("order_id",    IntegerType(), True),
StructField("order_date",  DateType(),    True),
StructField("city",        StringType(),  True),
StructField("category",    StringType(),  True),
StructField("qty",         IntegerType(), True),
StructField("unit_price",  IntegerType(), True),
StructField("customer_id", IntegerType(), True),
])
sales = spark.read.csv("sales.csv", header=True, schema=schema)
sales.printSchema()
print(sales.count())
OUTPUT (namoona)
root
 |-- order_id: integer (nullable = true)
 |-- order_date: date (nullable = true)
 |-- city: string (nullable = true)
 |-- category: string (nullable = true)
 |-- qty: integer (nullable = true)
 |-- unit_price: integer (nullable = true)
 |-- customer_id: integer (nullable = true)
5000
select, filter, withColumn
from pyspark.sql import functions as F
big = (sales
.withColumn("revenue", F.col("qty") * F.col("unit_price"))   # naya column
.filter(F.col("city") == "Karachi")                          # sirf Karachi
.select("order_id", "category", "qty", "unit_price", "revenue"))
big.show(3)
OUTPUT (namoona)
+--------+--------+---+----------+-------+
|order_id|category|qty|unit_price|revenue|
+--------+--------+---+----------+-------+
|       8|   Watch|  4|     10000|  40000|
|      15|  Mobile|  3|     76000| 228000|
|      20|  Mobile|  2|     45000|  90000|
+--------+--------+---+----------+-------+
groupBy aur agg
sales = sales.withColumn("revenue", F.col("qty") * F.col("unit_price"))
by_cat = (sales.groupBy("category")
.agg(F.count("*").alias("orders"),
F.sum("revenue").alias("total_revenue"),
F.round(F.avg("revenue"), 2).alias("avg_order"))
.orderBy(F.desc("total_revenue")))
by_cat.show()
OUTPUT (namoona)
+----------+------+-------------+---------+
|  category|orders|total_revenue|avg_order|
+----------+------+-------------+---------+
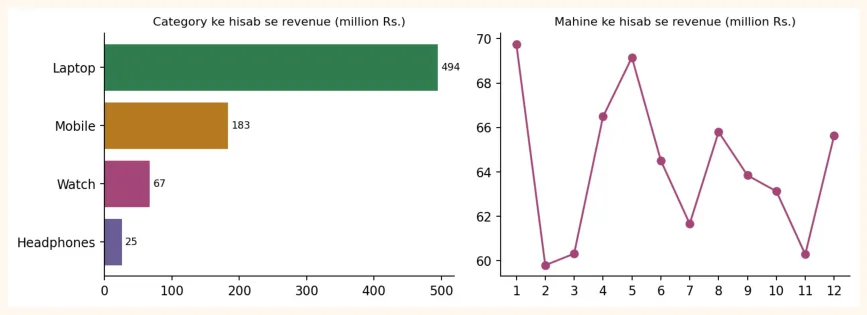
|    Laptop|  1260|    494225000|392242.06|
|    Mobile|  1263|    183377500| 145192.0|
|     Watch|  1246|     67262500| 53982.74|
|Headphones|  1231|     25482000| 20700.24|
+----------+------+-------------+---------+
Tasdeeq: wohi hisab Pandas se karke dekhte hain (ye OUTPUT asli hai). Dono ke nateeje aik jaise aane chahiye:
import pandas as pd
pdf = pd.read_csv("sales.csv")
pdf["revenue"] = pdf["qty"] * pdf["unit_price"]
res = (pdf.groupby("category")["revenue"]
.agg(orders="count", total_revenue="sum", avg_order="mean")
.round(2)
.sort_values("total_revenue", ascending=False))
print(res)
OUTPUT
            orders  total_revenue  avg_order
category
Laptop        1260      494225000  392242.06
Mobile        1263      183377500  145192.00
Watch         1246       67262500   53982.74
Headphones    1231       25482000   20700.24
Mahine ke hisab se aur city ke hisab se
monthly = (sales
.groupBy(F.month("order_date").alias("month"))
.agg(F.sum("revenue").alias("revenue"))
.orderBy("month"))
monthly.show(4)
city_rev = (sales.groupBy("city")
.agg(F.sum("revenue").alias("revenue"))
.orderBy(F.desc("revenue")))
city_rev.show()
OUTPUT (namoona)
+-----+--------+
|month| revenue|
+-----+--------+
|    1|69752000|
|    2|59793500|
|    3|60314000|
|    4|66487000|
+-----+--------+
+---------+---------+
|     city|  revenue|
+---------+---------+
|   Lahore|171351000|
| Peshawar|159378000|
|Islamabad|151400500|
|  Karachi|150230500|
|   Quetta|137987000|
+---------+---------+
Chhote nateeje ko Pandas me badal kar ( toPandas() ) chart bana sakte ho. Dhyan: toPandas() sara data driver ki memory me laata hai, isliye sirf chhote aggregated nateeje par chalao, poore bare data par nahi.
import matplotlib.pyplot as plt
pdf_cat = by_cat.toPandas()                       # chhota nateeja (4 rows)
pdf_mon = monthly.toPandas()
# phir matplotlib se bar chart aur line chart (Module 2 ki tarah)
42.5 Spark SQL
Agar tumhein SQL aati hai to DataFrame ko temporary view bana kar seedha SQL likh sakti ho. DataFrame aur SQL ek hi engine par chalte hain, isliye raftar barabar hai.
sales.createOrReplaceTempView("sales")
top = spark.sql("""
    SELECT customer_id,
           COUNT(*)      AS orders,
           SUM(revenue)  AS spent
    FROM sales
    GROUP BY customer_id
    ORDER BY spent DESC
    LIMIT 3
""")
top.show()
OUTPUT (namoona)
+-----------+------+-------+
|customer_id|orders|  spent|
+-----------+------+-------+
|        615|    11|3319500|
|        397|     9|3078000|
|         69|    14|3035500|
+-----------+------+-------+
42.6 Lazy Evaluation, Transformations aur Actions
Spark ki sab se ahem baat: jab tum filter , select , withColumn , groupBy jaise transformations likhte ho to Spark kuch nahi chalata , sirf ek plan (DAG) yaad rakhta hai. Kaam tab shuru hota hai jab tum action ( show , count , collect , write ) chalate ho.
Transformations (lazy) Actions (kaam shuru) select , filter / where , withColumn show() , count() groupBy().agg() , join , orderBy collect() , take(n) , first() repartition , distinct , drop write.parquet(...) , toPandas()
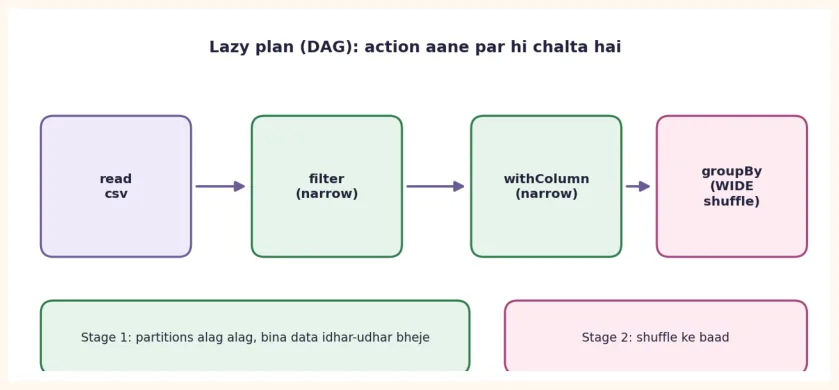
Narrow vs Wide transformation:
-
Narrow (
filter,select,withColumn): har partition apne aap kaam karta hai, data machines ke beech nahi bhejna parta . Sasta aur tez. -
Wide (
groupBy,join,orderBy,distinct): data partitions ke beech bhejna (shuffle) parta hai, jo network aur disk ki wajah se mehnga hai. Spark plan ko stages me tor deta hai: har wide transformation par nayi stage.
(sales.filter(F.col("qty") > 1)
      .groupBy("city")
      .agg(F.count("*").alias("n"))
      .explain())
OUTPUT (namoona; plan ka tafseeli rup version ke hisab se badalta hai)
== Physical Plan ==
AdaptiveSparkPlan isFinalPlan=false
+- HashAggregate(keys=[city#2], functions=[count(1)])
   +- Exchange hashpartitioning(city#2, 200)     <-- ye SHUFFLE hai
      +- HashAggregate(keys=[city#2], functions=[partial_count(1)])
         +- Filter (isnotnull(qty#4) AND (qty#4 > 1))
            +- FileScan csv [city#2,qty#4] ...
explain() me Exchange nazar aaye to samajh jao yahan shuffle ho raha hai. Performance sudharne ka matlab aksar shuffle kam karna hota hai.
42.7 Joins aur Window Functions
Join
regions = spark.createDataFrame(
[("Karachi", "Sindh"), ("Lahore", "Punjab"), ("Islamabad", "Capital"),
("Quetta", "Balochistan"), ("Peshawar", "KP")],
["city", "region"])
joined = sales.join(regions, on="city", how="left")
(joined.groupBy("region")
.agg(F.sum("revenue").alias("revenue"))
.orderBy(F.desc("revenue"))
.show())
OUTPUT (namoona)
+-----------+---------+
|     region|  revenue|
+-----------+---------+
|     Punjab|171351000|
|         KP|159378000|
|    Capital|151400500|
|      Sindh|150230500|
|Balochistan|137987000|
+-----------+---------+
| Join type | Nateeja |
|---|---|
inner | Sirf wo rows jinki key dono tables me ho |
left | Left table ki sab rows; right me na mile to null |
right | Right table ki sab rows |
outer | Dono ki sab rows |
left_semi/left_anti | Left ki wo rows jinki key right mehai/nahi hai(right ke columns nahi aate) |
Window function: har group ke andar ranking
groupBy rows ko ghata deta hai. Window function rows rakhti hai magar group ke andar hisab (rank, running total) karti hai. Maslan: har category ki sab se zyada revenue wali city :
from pyspark.sql.window import Window
cc = (sales.groupBy("category", "city")
.agg(F.sum("revenue").alias("revenue")))
w = Window.partitionBy("category").orderBy(F.desc("revenue"))
(cc.withColumn("rank", F.row_number().over(w))
.filter(F.col("rank") == 1)
.orderBy("category")
.show())
OUTPUT (namoona) +----------+------+---------+----+ | category| city| revenue|rank| +----------+------+---------+----+ |Headphones|Quetta| 5437000| 1| | Laptop|Lahore|110832500| 1| | Mobile|Lahore| 40554000| 1| | Watch|Lahore| 14556500| 1| +----------+------+---------+----+
42.8 Performance: partitions, cache aur Parquet
| Tarkeeb | Kyun aur kaise |
|---|---|
| Pehle filter, pehle select | Bhaari kaam (join/groupBy) se pehle rows aur columns kam karo. |
| Built-in functions (F.*) | Python UDF se kai guna tez, kyunke Spark unhein optimize kar sakta hai. |
| Parquet me rakho | Columnar + compressed; sirf zaroori columns parhta hai. |
| cache() / persist() | Jo DataFrame bar bar istemal ho use memory me rakho. |
| repartition(n) / coalesce(n) | repartitionshuffle ke sath barabar bantta hai;coalescebina shuffle partitionskamkarta hai. |
| Broadcast join | Chhoti table ke sath join me shuffle bachao. |
| collect() se parhez | Sara data driver par aane se memory khatam ho sakti hai. |
clean = sales.filter(F.col("qty") > 0).cache()      # memory me rakho
print(clean.count())                                # pehli action: cache bharta hai
print(clean.count())                                # doosri:
cache se, tez
print(clean.rdd.getNumPartitions())
print(clean.repartition(8).rdd.getNumPartitions())
print(clean.coalesce(2).rdd.getNumPartitions())
clean.unpersist()                                   # kaam khatam to cache khali karo
OUTPUT (namoona; chhoti file me partitions aksar kam hote hain) 5000 5000 1 8 1
Note: coalesce(2) partitions sirf kam kar sakta hai; agar pehle se 1 hai to wo 1 hi rehta hai.
Parquet likhna aur parhna
(sales.write
      .mode("overwrite")
      .partitionBy("category")          # category ke hisab se alag folder
      .parquet("sales_parquet"))
fast = spark.read.parquet("sales_parquet")
# sirf Laptop wala folder parha jata hai
fast.filter(F.col("category") == "Laptop").count()
OUTPUT (namoona: folder ka dhancha aur count)
sales_parquet/
  _SUCCESS
  category=Headphones/part-....snappy.parquet
  category=Laptop/part-....snappy.parquet
  category=Mobile/part-....snappy.parquet
  category=Watch/part-....snappy.parquet
1260
partitionBy("category") se data folders me bat jata hai, aur category par filter karne par Spark sirf zaroori folder parhta hai ( partition pruning ). Sirf kam unique values wale column (category, saal-mahina) par partitionBy karo; customer_id jaise column par karoge to hazaron chhote folders ban jayenge.
42.9 MLlib ka chhota nazara: customers ke groups
MLlib Spark ki machine learning library hai. Uska Pipeline scikit-learn ki tarah hai, magar data distributed rehta hai. Neeche customers ko unke kharche aur orders ke hisab se 3 groups me baantne ka misaal hai ( KMeans , Module 4 Chapter 16 yaad karo).
from pyspark.ml.feature import VectorAssembler, StandardScaler
from pyspark.ml.clustering import KMeans
from pyspark.ml import Pipeline
cust = (sales.groupBy("customer_id")
.agg(F.count("*").alias("orders"),
F.sum("revenue").alias("spent")))
assembler = VectorAssembler(inputCols=["orders", "spent"], outputCol="raw")
scaler    = StandardScaler(inputCol="raw", outputCol="features")
kmeans    = KMeans(k=3, seed=42, featuresCol="features")
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(cust)
result = model.transform(cust)
result.groupBy("prediction").count().orderBy("prediction").show()
OUTPUT (namoona; groups ke sizes aap ke run me alag ho sakte hain)
+----------+-----+
|prediction|count|
+----------+-----+
|         0|  ...|
|         1|  ...|
|         2|  ...|
+----------+-----+
Ye sirf nazara hai: MLlib ka asli fayda tab hai jab data itna bara ho ke scikit-learn ek machine par na chale. Chhote data ke liye scikit-learn hi behtar aur zyada features wala hai.
42.10 Pandas vs Spark: kab kya?
| Pandas | Spark (PySpark) | |
|---|---|---|
| Data ka size | Ek machine ki RAM tak (aam tor par GB) | GB se PB, cluster par |
| Raftar (chhota data) | Tez | Shuru ka overhead, chhote data par sust |
| Lazy? | Nahi, foran chalta hai | Haan, action par chalta hai |
| Data | Memory me, mutable | Distributed, immutable (har step naya DataFrame) |
| Seekhna | Asaan | Thora zyada (shuffle, partition, plan) |
| Kab | EDA, chhote projects | Bare logs, pipelines, production ETL |
42.11 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Chhote data par Spark chalana; Pandas tez aur asaan hai.
-
Har cheez par
collect()yatoPandas()karna, jis se driver ki memory khatam ho jati hai. -
Lazy evaluation bhool jana : sochna ke
filterlikhte hi kaam ho gaya. Action ke baghair kuch nahi chalta. -
Python ka
and/oristemal karna; Spark me&,|aur bracket chahiye. -
Bare data par
inferSchema=True(data do baar parhna) aur schema ki galtiyan. -
Zyada partitions ya zyada chhoti files: hazaron chhote tasks bhi sust karte hain.
-
Python UDF har jagah likhna jab built-in function maujood ho.
-
API key ya passwords Spark code me likhna. Hamesha environment variables/secrets.
Hands-on
-
RDD: word count me apne 5 jumle daalo aur sirf wo lafz rakho jinki tadaad 2 ya zyada ho (
filter). -
DataFrame:
qty >= 3
aur
city == "Lahore"
wali rows ki ginti nikalo.
- Naya column:
revenue_lakh = revenue / 100000
banao aur round(..., 2) karo.
-
groupBy: har
cityaurcategoryke jore ka average qty nikalo aur sab se bara 5 dikhao. -
SQL: upar ka
by_catwala hisab SQL me likho aur nateeja milao. -
Window: har mahine ki sab se zyada bikne wali category dhoondo (
row_number). -
Performance:
explain()meExchangedhoondo;groupByke baghair filter wali query me wo nazar aata hai ya nahi? -
Parquet:
partitionBy("city")se likho aur folders ginti karo.
KEY TAKEAWAYS
-
Spark = in-memory distributed engine: Driver plan banata hai, Executors tasks chalate hain, Cluster Manager wasail baantta hai.
-
RDD buniyad hai; DataFrame + Spark SQL roz ka kaam (optimizer ki wajah se tez).
-
Lazy evaluation: transformations sirf plan (DAG) banate hain; action par kaam hota hai.
-
Narrow transformations sasti; wide (groupBy, join, orderBy) shuffle karti hain aur mehngi hain.
-
Schema khud likho , pehle filter/select, built-in functions, Parquet aur cache istemal karo.
-
Chhoti table ke sath join me broadcast join ;
collect()aurtoPandas()sirf chhote nateeje par. -
Chhote data ke liye Pandas , bare data ke liye Spark .