Chapter 44: Class-Based Projects
MODULE 7 | WEEK 44
Chapter 44: Class-Based Projects
Ab tak 3 chapters me concepts seekhe. Is hafte ka maqsad hai ke tum class me, instructor aur sathiyon ke sath mil kar , wohi concepts teen chhote mukammal projects me istemal karo. Har project ka mushkil (kya karna hai), steps, checkpoints (sahi nateeja kya hona chahiye) aur rubric (number kaise milenge) diya gaya hai. Pehle project ka code mukammal hai; baqi me dhancha aur madad hai aur baqi kaam tumhara.
44.1 Teen projects ek nazar me
| Project | Maqsad | Tools | Waqt |
|---|---|---|---|
| 1. Retail Sales Analytics | Ganda data saaf karna, hisab kitab, Parquet me rakhna, report | PySpark DataFrame/SQL, Parquet | 90-120 min |
| 2. Cloud Data Lake | Data ko cloud storage me zones me rakhna aur Spark se process karna | S3 ya Blob, IAM, PySpark | 90 min |
| 3. Server Log Analysis | Text logs parse kar ke errors aur slow pages dhoondna | PySpark, regexp_extract, window | 60-90 min |
44.2 Project 1: Retail Sales Analytics
Qadam 1: parho aur halat dekho.
from pyspark.sql import SparkSession, functions as F
from pyspark.sql.types import *
spark = (SparkSession.builder.appName("RetailProject")
.master("local[*]").getOrCreate())
schema = StructType([
StructField("order_id", IntegerType()), StructField("order_date", DateType()),
StructField("city", StringType()),      StructField("category", StringType()),
StructField("qty", IntegerType()),
StructField("unit_price", IntegerType()),
StructField("customer_id", IntegerType()),
])
raw = spark.read.csv("sales_dirty.csv", header=True, schema=schema)
print("Raw rows:", raw.count())
OUTPUT (namoona) Raw rows: 5100
Qadam 2: saaf karo (har qadam ke baad ginti likho).
step1 = raw.dropDuplicates()                                   # duplicate rows
step2 = step1.dropna(subset=["city"])                          # khali city
clean = step2.filter(F.col("qty") > 0)                         # ghalat qty
print("Duplicate hatane ke baad :", step1.count())
print("Khali city hatane ke baad:", step2.count())
print("Ghalat qty hatane ke baad:", clean.count())
clean = clean.withColumn("revenue", F.col("qty") * F.col("unit_price"))
OUTPUT (namoona; pehli line: 5100 - 100 duplicates) Duplicate hatane ke baad : 5000 Khali city hatane ke baad: 4950 Ghalat qty hatane ke baad: 4920
OUTPUT
4920
category
Laptop        482855000
Mobile        180811500
Watch          66188000
Headphones     24952500
Name: revenue, dtype: int64
Qadam 4: Parquet me likho aur wapas parho.
(clean.write.mode("overwrite")
      .partitionBy("category")
      .parquet("retail_curated"))
check = spark.read.parquet("retail_curated")
print(check.count())
OUTPUT (namoona)
4920
Qadam 5: report. toPandas() se chhote nateeje nikal kar 2 chart banao (category ka bar chart, mahine ka line chart) aur 5 line ka insight likho (maslan "Laptop sab se zyada revenue deta hai magar orders Mobile se kam").
| Deliverable | Kya jama karna hai |
|---|---|
| Code | Notebook ya.pyjo shuru se aakhir tak bina error chale |
| Data quality report | Kitni rows kyun hatayin (4 qadam wali ginti) |
| Charts + insights | 2 chart aur 5 line ka tajzia |
| README | Kya kiya, kaise chalaen, kya seekha |
| Rubric (Project 1) | Number |
|---|---|
| Safai sahi aur har qadam ki ginti documented | 30 |
| Teeno sawalon ke jawab sahi (Pandas se tasdeeq) | 30 |
| Parquet partition sahi aur wapas parhna | 15 |
| Charts aur insight | 15 |
| Code ki saafi aur README | 10 |
| Kul | 100 |
|---|
44.3 Project 2: Cloud Data Lake (Raw, Clean, Curated)
Is project me tum Project 1 ka pipeline cloud par chalaogi. Data lake me data 3 zones me rakha jata hai (Medallion pattern: Bronze/Silver/Gold ):
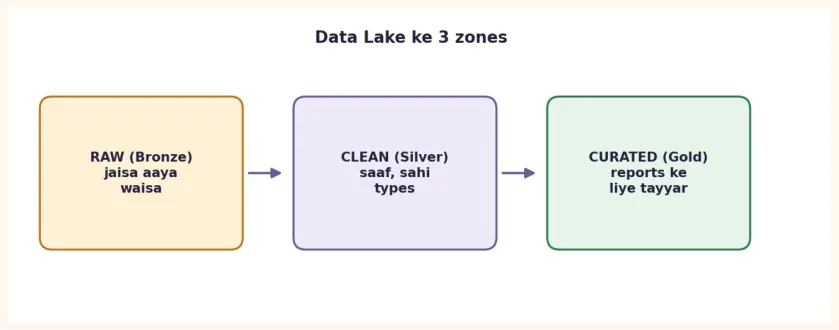
| Zone | Kya rakhte hain | Qanoon |
|---|---|---|
| Raw (Bronze) | Jaisa data aaya waisa,kabhi badla nahi jata | Sirf append; purana mat mitao. Dobara process karne ka bharosa isi se aata hai. |
| Clean (Silver) | Saaf, sahi types, duplicate hata hue | Parquet |
| Curated (Gold) | Reports/dashboards/ML ke liye tayyar aggregates | Parquet, business ke naam wale columns |
Steps (AWS ya Azure me se ek chuno):
-
Ek private bucket/container banao:
raw/,clean/,curated/folders (prefix) ke sath. -
sales_dirty.csvkoraw/me upload karo (boto3/azure-storage-blob, Chapter 43.6). -
Spark (Colab ya Databricks/EMR) se
raw/parho, Project 1 ki safai chalao aurclean/me Parquet likho. -
clean/se parh kar aggregates (category, city, mahina) bana karcurated/me likho. -
IAM/RBAC: ek read-only identity banao jo sirf
curated/parh sake. Test karo ke woraw/nahi parh sakti. -
Lifecycle rule:
raw/ki 90 din purani files sasti tier me. -
Cost: apni farzi/asli kharch ka hisab likho; aakhir me sab delete karo aur screenshot lo.
# Colab me S3 se parhne ka asaan tareeqa: boto3 se download, phir Spark se parho
import boto3, os
s3 = boto3.client("s3")             # keys environment/`aws configure` se
bucket = "my-sales-bucket-rania-123"
s3.download_file(bucket, "raw/sales_dirty.csv", "sales_dirty.csv")
# ... Project 1 ki safai ...
clean.write.mode("overwrite").parquet("clean_out")        # local folder
# wapas upload (folder ki har file ka upload ek loop me)
for root, _, files in os.walk("clean_out"):
    for name in files:
        path = os.path.join(root, name)
        key = "clean/" + os.path.relpath(path, "clean_out")
        s3.upload_file(path, bucket, key)
44.4 Project 3: Server Log Analysis
Websites ke log files Big Data ki sab se aam misaal hain: har request ek line. Hum 2000 lines ki ek log file banate hain (OUTPUT asli hai) aur Spark se errors, slow pages aur ghanton ka load dhoondte hain.
import random
from datetime import datetime, timedelta
random.seed(5)
pages = ["/home", "/cart", "/checkout", "/search", "/login"]
levels = ["INFO"] * 17 + ["WARN"] * 2 + ["ERROR"] * 1
t = datetime(2025, 3, 1, 9, 0, 0)
with open("server.log", "w") as f:
    for i in range(2000):
        t += timedelta(seconds=random.randint(1, 4))
        f.write(f"{t:%Y-%m-%d %H:%M:%S} {random.choice(levels)} "
        f"{random.choice(pages)} {random.randint(20, 900)}ms\n")
        print(open("server.log").read().splitlines()[0])
        print(open("server.log").read().splitlines()[1])
        print(sum(1 for _ in open("server.log")), "lines")
OUTPUT
2025-03-01 09:00:03 INFO /login 49ms
2025-03-01 09:00:07 INFO /home 180ms
2000 lines
logs = spark.read.text("server.log")                      # ek column: "value"
pattern = r"^(\S+ \S+) (\w+) (\S+) (\d+)ms$"
parsed = logs.select(
    F.to_timestamp(F.regexp_extract("value", pattern, 1)).alias("ts"),
    F.regexp_extract("value", pattern, 2).alias("level"),
    F.regexp_extract("value", pattern, 3).alias("page"),
    F.regexp_extract("value", pattern, 4).cast("int").alias("ms"),
)
parsed.groupBy("level").count().orderBy(F.desc("count")).show()
parsed.groupBy("page").agg(F.round(F.avg("ms"), 1).alias("avg_ms")) \
      .orderBy(F.desc("avg_ms")).show()
Checkpoint (asli OUTPUT): wohi hisab seedhe Python se. Spark ke nateeje inhi se milne chahiye:
import re, collections
lv = collections.Counter()
pg = collections.defaultdict(list)
for line in open("server.log"):
    m = re.match(r"^(\S+ \S+) (\w+) (\S+) (\d+)ms$", line.strip())
    lv[m.group(2)] += 1
    pg[m.group(3)].append(int(m.group(4)))
    print(dict(lv))
    for p, v in pg.items():
        print(p, round(sum(v) / len(v), 1))
OUTPUT
{'INFO': 1683, 'WARN': 208, 'ERROR': 109}
/login 460.2
/home 457.4
/search 441.9
/cart 458.0
/checkout 465.0
Tumhara kaam:
-
Errors per ghanta:
F.date_trunc("hour", "ts")se group kar ke ERROR ki ginti nikalo aur sab se ganda ghanta batao. -
Slow requests:
ms > 800wali rows ki ginti aur sab se zyada slow page. -
Error rate: har page ka
ERROR / totalfeesad nikalo aur sab se kharab page dhoondo. -
Window: har page ke andar
mska running average (rowsBetween(-50, 0)) nikalo. -
Report: 5 line me likho ke engineering team ko kya theek karna chahiye.
| Rubric (Project 3) | Number |
|---|---|
| Parsing sahi (regex) aur schema sahi types ke sath | 30 |
| Chaaron sawalon ke jawab (Python check se milte hon) | 43 |
| Window function sahi istemal | 10 |
| Report ki wazahat | 10 |
| Code ki saafi | 10 |
| Kul | 100 |
|---|
44.5 README aur Demo
Har project ke saath ek README.md zaroori hai. Ye tumhari portfolio ka chehra hai. Neeche ka dhancha istemal karo:
# Project ka naam
## Masla
Ek do jumle: kaun sa sawal hal kiya?
## Data
Kahan se, kitne rows/columns, kya saaf kiya.
## Tareeqa
Pipeline ke qadam (nakshaa ho to behtar). Tools: PySpark, S3/Blob ...
## Nateeja
Mukhya numbers/charts aur 3-5 insights.
## Chalane ka tareeqa
1. pip install pyspark
2. python make_data.py
3. python pipeline.py
## Seekha / agla kaam
Kya mushkil tha, aur agar waqt hota to kya karte.
| Demo (3 minute) | Kya dikhana hai |
|---|---|
| 30 sec | Masla aur data |
| 90 sec | Code ya pipeline chalta hua (live ya recorded) |
| 45 sec | Nateeja aur insight |
| 15 sec | Sab se bari mushkil aur kya seekha |
44.6 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Safai ke qadam undocumented chhor dena (kitni rows kyun hatayin kuch pata nahi).
-
Raw data par overwrite karna; raw hamesha jaisa aaya waisa rakho.
-
Spark ke nateeje ko kisi doosre tareeqe (Pandas/SQL) se check na karna .
-
Poora data
collect()karke chart banana. -
Access keys README ya notebook me chhor dena.
-
Project ke baad cloud resources delete na karna .
-
README me chalane ka tareeqa na likhna: doosra tumhara code chala hi nahi pata.
Hands-on (extra)
-
Project 1 me Region (Chapter 45.7 ka join) jor kar region ke hisab se report banao.
-
Project 1 me
price > 100000wali rows ko alag "premium" Parquet me likho. -
Project 2 me dusre cloud (AWS ya Azure) ke naam badal kar steps ki ek table likho.
-
Project 3 me
WARNaurERRORko milakar "problem rate" nikalo.
KEY TAKEAWAYS
-
Project ka dhancha: masla -> data -> safai (documented) -> hisab -> nateeja -> README -> demo.
-
Data lake zones: Raw (kabhi na badlo), Clean (saaf Parquet), Curated (reports ke liye).
-
Spark ke nateeje ko doosre tareeqe (Pandas/SQL/Python) se tasdeeq karo.
-
Least privilege ke sath cloud par kaam karo aur kaam ke baad cleanup karo.
-
Text logs:
regexp_extractse parse, phir normal DataFrame operations. -
Git commits, README aur demo professional kaam ki pehchan hain.