Chapter 43: Cloud Computing (AWS ya Azure)
MODULE 7 | WEEK 43
Chapter 43: Cloud Computing (AWS ya Azure)
Pichle do chapters me humne dekha ke Big Data kai machines par chalta hai. Sawal ye hai: itni saari machines kahan se aayen ? Apni company ka data center banana bohat mehnga hai. Is ka jawab hai Cloud : tum Amazon (AWS) ya Microsoft (Azure) jaisi companies ki machines kiraye par lete ho, jitni der istemal karo utne hi paise do. Is chapter me hum cloud ke bunyadi tasawwurat, AWS aur Azure ki core services, IAM (security), storage, kharcha (cost) aur Big Data aur ML ko cloud par chalana seekhenge. Tum AWS ya Azure me se koi ek chun sakti ho: concepts dono me ek jaise hain, sirf naam alag hain.
43.1 Cloud kya hai?
Cloud computing ka matlab hai internet ke zariye computing wasail (server, storage, database, networking, software) kiraye par lena , aur jitna istemal karo utna hi bill dena ( pay-as-you-go ). Apna data center khareedne, bijli, thandak aur staff ki zaroorat nahi.
Service models: IaaS, PaaS, SaaS
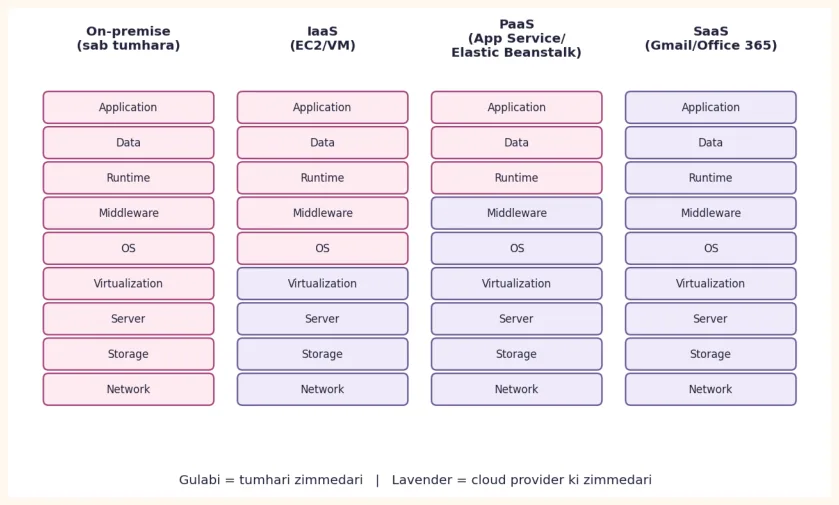
| Model | Kya milta hai | Misaal |
|---|---|---|
| IaaS(Infrastructure) | Virtual machine, storage, network; OS aur uske upar sab tumhara | AWS EC2, Azure Virtual Machines |
| PaaS (Platform) | Tayyar platform; sirf app/code tumhara | AWS Elastic Beanstalk, Azure App Service, Databricks |
| SaaS(Software) | Tayyar software istemal karo | Gmail, Office 365, Salesforce |
Deployment models: Public cloud (AWS/Azure jaisi companies ka sab ke liye), Private cloud (sirf ek company ka), Hybrid (dono ka mel) aur Multi-cloud (ek se zyada providers).
43.2 Regions aur Availability Zones
-
Region: dunya me ek joghrafiyai ilaqa jahan provider ke data centers hain (maslan Mumbai, Frankfurt, Dubai). Data kis region me rakha jaye ye tay karna parta hai: latency (tezi), qanoon (data kis mulk me rahe) aur qeemat teen cheezein dekhi jati hain.
-
Availability Zone (AZ): ek region ke andar alag alag data centers (alag bijli, network). Ek AZ band ho jaye to doosri chalti rehti hai.
Apni app/data kai AZ me rakho to ek data center kharab hone par bhi service chalti rehti hai; ye wahi replication ka idea hai jo HDFS me dekha tha.
43.3 AWS vs Azure: core services ka naqsha
| Kaam | AWS | Azure |
|---|---|---|
| Virtual machine | EC2 | Virtual Machines |
| Object storage (files/data lake) | S3 | Blob Storage / ADLS Gen2 |
|---|---|---|
| Relational database | RDS, Aurora | Azure SQL Database |
| Kaam | AWS | Azure |
|---|---|---|
| NoSQL database | DynamoDB | Cosmos DB |
| Security / access | IAM | Microsoft Entra ID + RBAC |
|---|---|---|
| Serverless function | Lambda | Azure Functions |
| Big Data / Spark cluster | EMR, Glue (Spark) | Databricks, Synapse, HDInsight |
| ETL / orchestration | Glue, Step Functions, MWAA (Airflow) | Data Factory |
| Data warehouse | Redshift | Synapse Analytics |
| SQL on data lake | Athena | Synapse serverless SQL |
| Streaming ingest | Kinesis, MSK (Kafka) | Event Hubs |
| Machine learning | SageMaker | Azure Machine Learning |
| Monitoring / billing | CloudWatch, Budgets | Azure Monitor, Cost Management |
43.4 Account banane ke baad pehle 5 kaam
-
Root/Owner account par MFA (2-step verification) lagao aur us se roz ka kaam mat karo.
-
Budget aur billing alert banao (maslan 5 USD par email), phir kuch aur.
-
Roz ke kaam ke liye alag IAM user/role (Azure me alag user + RBAC) banao jis ke paas sirf zaroori ijazat ho.
-
Apni region tay karo (nazdeek aur sasti) aur sab resources usi me banao.
-
Tags/naam ka ek usool rakho (
project=module8) taake baad me sab kuch dhoond kar delete kar sako.
AAM GALTIYAN
Free tier/credits ki shartein badalti rehti hain (kaun si service, kitni der, kitna data). Provider ka free tier page parho ; free tier se bahar jaate hi bill aata hai. Student ke liye aksar alag credits hote hain; apne instructor se poochho.
43.5 IAM: kaun kya kar sakta hai?
IAM (Identity and Access Management) tay karta hai kaun (identity) kis cheez (resource) par kya (action) kar sakta hai. Bunyadi iklaye:
| Lafz | Matlab | Misaal |
|---|---|---|
| User | Ek insaan/app ki pehchan | rania-dev |
| Group | Users ka majmua | data-team |
| Role | Ijazaton ka set jo koi bhi (user, service) kuch der ke liye istemal kar sakta hai; access keys se behtar | EC2 ko S3 parhne ka role |
| Policy | Ijazaton ka document (JSON) | Sirf ek bucket parhne ki ijazat |
OUTPUT
Ijazat  : Allow
Actions : ['s3:GetObject', 's3:ListBucket']
Resource: 2 cheezein
Likhne ki ijazat hai? False
Azure me yehi kaam RBAC role assignment se hota hai: maslan kisi user ya app ko storage account par "Storage Blob Data Reader" role de do (sirf parhna) ya "Storage Blob Data Contributor" (parhna aur likhna).
KHABARDAR
-
Access key/secret kabhi code, notebook ya GitHub me mat likho. Bots GitHub par keys minuton me dhoond kar crypto-mining kar dete hain aur bill hazaron dollar tak jata hai.
-
Keys environment variable ya secrets manager (AWS Secrets Manager, Azure Key Vault) me rakho; jahan ho sake role istemal karo.
-
Galti se key leak ho jaye to foran disable/rotate karo.
43.6 Cloud Storage: S3 aur Azure Blob
Object storage (S3, Azure Blob) Big Data ka data lake hai: sasta, lamtanahi (practically unlimited) aur bohat reliable . Data bucket (AWS) / container (Azure) me objects (files) ki shakal me hota hai. Object ka key/path hota hai jaise raw/2025/sales.csv (folders asal me sirf naam ka hissa hain).
AWS S3: boto3 ke sath
# pip install boto3
# Credentials: terminal me `aws configure` ya environment variables.
# Kabhi code me access key mat likho.
import boto3
s3 = boto3.client("s3", region_name="ap-south-1")
# bucket ka naam poori dunya me unique hona chahiye
bucket = "my-sales-bucket-rania-123"
s3.create_bucket(Bucket=bucket,
                 CreateBucketConfiguration={"LocationConstraint": "ap-south-1"})
s3.upload_file("sales.csv", bucket, "raw/sales.csv")        # upload
resp = s3.list_objects_v2(Bucket=bucket, Prefix="raw/")     # list
for obj in resp.get("Contents", []):
    print(obj["Key"], obj["Size"], "bytes")
s3.download_file(bucket, "raw/sales.csv", "sales_copy.csv") # download
OUTPUT (namoona; size aap ki file ki hogi)
raw/sales.csv 222952 bytes
Azure Blob Storage: azure-storage-blob ke sath
# pip install azure-storage-blob
import os
from azure.storage.blob import BlobServiceClient
# connection string code me likhne ki bajaye environment variable se
conn = os.environ["AZURE_STORAGE_CONNECTION_STRING"]
service = BlobServiceClient.from_connection_string(conn)
container = service.create_container("raw")      # container = bucket ke barabar
with open("sales.csv", "rb") as f:
    container.upload_blob("sales.csv", f)                  # upload
for blob in container.list_blobs():                        # list
    print(blob.name, blob.size, "bytes")
OUTPUT (namoona)
sales.csv 222952 bytes
| Storage ki qismein (ek jaisa idea) | Kab |
|---|---|
| Standard / Hot | Aksar istemal hone wala data |
| Infrequent / Cool | Kabhi kabhi parha jane wala; sasta storage, thora mehnga access |
| Archive (Glacier / Archive tier) | Saalon purana backup; bohat sasta, wapas lene me der |
Aur Lifecycle rule laga kar data khud ba khud sasti tier me chala jata hai (maslan 90 din purani files Cool me).
AAM GALTIYAN
Bucket/container public mat rakho. Buckets ke public hone ki wajah se hi bari companies ka data leak hota hai. Default me private rakho aur sirf IAM/RBAC se access do.
43.7 Cloud ka kharcha: pehle hisab, phir kaam
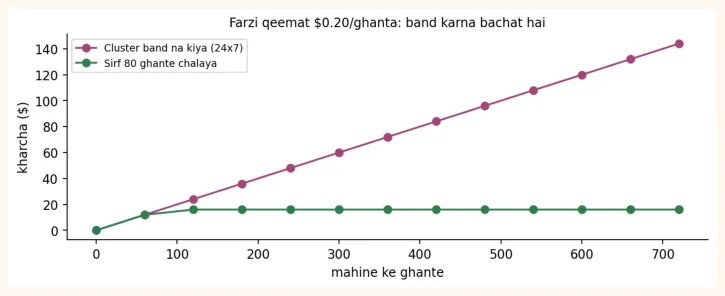
Cloud me bill har cheez ka bantta hai: compute (machine ka waqt), storage (kitna data), data transfer (data bahar nikalna) aur services. Spark cluster jitni der chalta rehta hai utna bill, chahe tum kaam na kar rahi ho . Chalo farzi qeematon se ek hisab dekhte hain (ye OUTPUT asli hai, magar qeemat farzi hai):
cluster_per_hour = 0.20        # farzi:
$ per ghanta
storage_gb_month = 0.023       # farzi:
$ per GB per mahina
storage_gb = 500
hours_24x7 = 24 * 30           # cluster poora mahina chalta chhora
hours_used = 80                # sirf kaam ke waqt chalaya
cost_a = cluster_per_hour * hours_24x7 + storage_gb * storage_gb_month
cost_b = cluster_per_hour * hours_used + storage_gb * storage_gb_month
print(f"Cluster 24x7        : ${cost_a:,.2f}")
print(f"Sirf 80 ghante      : ${cost_b:,.2f}")
saved = cost_a - cost_b
print(f"Bachat              : ${saved:,.2f}  ({saved / cost_a:.0%})")
OUTPUT
Cluster 24x7        : $155.50
Sirf 80 ghante      : $27.50
Bachat              : $128.00  (82%)
-
Budget + alert pehle din lagao (AWS Budgets / Azure Cost Management).
-
Cluster auto-terminate (kaam na ho to khud band) ya transient cluster (kaam ke liye banao, kaam ke baad khatam).
-
Spot / Low-priority instances: sasti magar chheen li ja sakti hain; batch Spark ke liye acha.
-
Serverless (Athena, Lambda, Synapse serverless): jab tak query chalao tabhi paise.
-
Data transfer kam rakho: compute aur storage ek hi region me rakho.
-
Kaam ke baad delete karo : bucket, cluster, VM, disks, IP addresses.
43.8 Cloud par Big Data pipeline
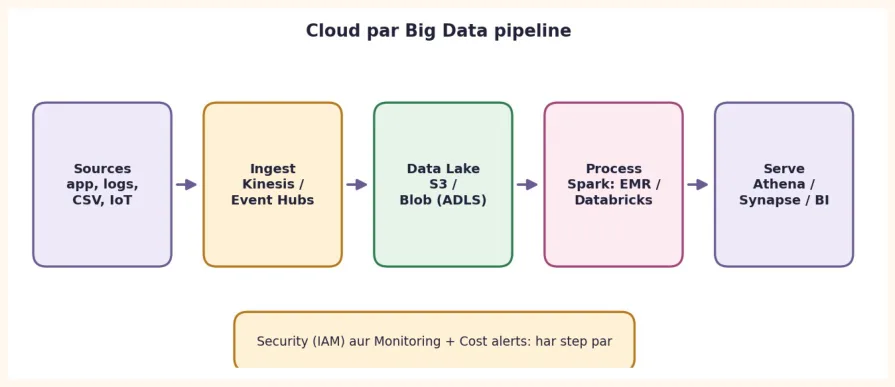
Ab hum Chapter 41-42 ko cloud par jodte hain. Aam pipeline kuch aisi hoti hai:
| Qadam | AWS | Azure |
|---|---|---|
| Ingest(data andar laana) | Kinesis, S3 upload, DMS | Event Hubs, Data Factory |
| Store(data lake) | S3 | ADLS Gen2 / Blob |
| Process(Spark) | EMR, Glue | Databricks, Synapse Spark |
| Serve / Query | Athena, Redshift | Synapse, Power BI |
| Orchestrate | Step Functions, MWAA | Data Factory |
Spark ko cloud storage se jorna bhi wohi DataFrame code hai, sirf path badalta hai (aur cluster par connector/credentials pehle se set hote hain):
# AWS S3
df = spark.read.parquet("s3a://my-sales-bucket-rania-123/curated/sales/")
# Azure Data Lake Storage Gen2
df = spark.read.parquet("abfss://curated@mystorageacct.dfs.core.windows.net/sales/")
# dono me aage ka code bilkul wohi
df.groupBy("category").count().show()
43.9 Cloud par ML model chalana: overview
Module 4-7 me banaya hua model apne laptop se nikal kar sab ke liye kaam kare, is ke kai raaste hain:
| Raasta | AWS | Azure | Kab |
|---|---|---|---|
| Managed ML platform | SageMaker (train + endpoint) | Azure Machine Learning | Training aur deploy ek jagah, MLOps |
| Container | App Runner / ECS | Container Apps / App Service | FastAPI + Docker (Module 7 ki tarah) |
| Raasta | AWS | Azure | Kab |
|---|---|---|---|
| Serverless | Lambda | Azure Functions | Chhoti, kabhi kabhi chalne wali API |
| Virtual machine | EC2 | Azure VM | Poora control; khud sambhalna parta hai |
Sab me bunyadi idea ek hi hai: model + code ko package karo (aksar Docker) , cloud par chalao , IAM se secure karo , logs/monitoring dekho , aur kharcha nigrani me rakho .
43.10 AWS ya Azure: kaise chunein?
| Sawal | Jawab |
|---|---|
| Pehle kaunsa seekhun? | Jo tumhari class/instructor/company istemal kare. Concepts dono me ek hain. |
| Free tier / credits? | Dono ke apne offers hain jo badalte rehte hain; official page dekho. |
| Job market | Dono ki demand hai; AWS ka share bara, Azure Microsoft ki companies (enterprise) me mazboot. |
| Certification | Shuruat ke liye:AWS Cloud PractitioneryaMicrosoft AZ-900 / DP-900. |
| Spark ke liye | AWS: EMR/Glue. Azure:Databricks/Synapse(Databricks dono par bhi chalta hai). |
43.11 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Billing alert lagaye baghair cluster/VM chalana aur baad me bara bill dekhna.
-
Access keys GitHub par push kar dena.
-
Root account se roz ka kaam aur MFA na lagana.
-
Bucket public chhor dena.
-
Cluster chalta chhor dena aur resources delete na karna (VM, disk, public IP, load balancer).
-
Compute aur storage alag regions me rakhna (data transfer ka bill aur zyada latency).
-
Admin/
*permission de dena; least privilege istemal karo.
Hands-on (apne cloud account me, free tier ke andar)
-
Account safety: MFA lagao aur 5 USD ka budget alert banao.
-
Storage: ek private bucket/container banao aur
sales.csvupload karo. -
IAM/RBAC: ek read-only role/policy banao aur check karo ke likhna rok diya gaya hai.
-
Lifecycle: 30 din purani files ko sasti tier me bhejne ka rule likho (screenshot lo).
-
Cost: 43.7 ke code me apni farzi qeematein badal kar 3 scenarios ka hisab lagao.
-
Cleanup: sab resources delete karo aur billing page par dekho ke koi charge baqi nahi.
-
Likho: AWS aur Azure ki ek ek service jo S3/Blob ki jagah le sakti hai (table 43.3 dekho) aur 3 farq likho.
KEY TAKEAWAYS
-
Cloud = internet par kiraye ki computing, pay-as-you-go , zaroorat par elastic .
-
IaaS (VM) -> PaaS (platform) -> SaaS (software): upar jate hue tumhari zimmedari kam hoti hai.
-
Region (ilaqa) aur Availability Zone (alag data center): replication se reliability.
-
AWS aur Azure ke concepts ek jaise: S3 = Blob/ADLS, EC2 = VM, IAM = Entra+RBAC, EMR = Databricks/Synapse.
-
IAM me least privilege , MFA , keys kabhi code me nahi ; Shared Responsibility yaad rakho.
-
Storage aur compute alag : data lake S3/ADLS me, Spark cluster sirf kaam ke waqt.
-
Pehle budget alert, kaam ke baad resources delete.