Chapter 22: Advanced Neural Networks aur Optimization Techniques
MODULE 5 | WEEK 22
Chapter 22: Advanced Neural Networks aur Optimization Techniques
Pichle chapter me tumne ek chhota network banaya. Asli masail me network gehre hote hain aur unhe train karna ek fun hai: loss ruk jata hai, network overfit kar jata hai, ya training bohat dheemi hoti hai. Is chapter me hum seekhenge ke network ko behtar kaise banayein : gehre networks, overfitting se bachao ( L2, Dropout, Early Stopping, Batch Normalization ), sahi weight initialization , aur optimizers ( SGD, Momentum, RMSprop, Adam ) jo training ko tez aur stable banate hain.
22.1 Gehre networks aur multiclass classification
Is chapter me ek asli dataset istemal karenge: Digits (Chapter 8 me dekha tha). 1797 haath se likhe hue number (0 se 9) ki 8x8 tasveerein , yani har tasveer ke 64 pixels (0 se 16 tak). Ye multiclass classification hai: 10 classes, to aakhri layer me 10 neurons aur softmax .
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
digits = load_digits()
X, y = digits.data, digits.target
print("X shape:", X.shape, " classes:", np.unique(y))
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25,
random_state=42, stratify=y)
scaler = StandardScaler().fit(X_tr)          # sirf train par fit (leakage nahi)
X_tr_s, X_te_s = scaler.transform(X_tr), scaler.transform(X_te)
print("Train:", X_tr_s.shape, " Test:", X_te_s.shape)
OUTPUT
X shape: (1797, 64)  classes: [0 1 2 3 4 5 6 7 8 9]
Train: (1347, 64)  Test: (450, 64)
Ab alag alag gehrai (depth) ke networks aazmate hain. sklearn ka MLPClassifier bhi asli neural network hai (backprop + gradient descent), to ye natije asli hain:
from sklearn.neural_network import MLPClassifier
for layers in [(), (16,), (64,), (128, 64), (128, 64, 32)]:
    if layers == ():
        from sklearn.linear_model import LogisticRegression
        m = LogisticRegression(max_iter=2000)
        name = "Koi hidden layer nahi (Logistic)"
    else:
        m = MLPClassifier(hidden_layer_sizes=layers, max_iter=500, random_state=0)
        name = "Hidden layers " + str(layers)
        m.fit(X_tr_s, y_tr)
        print(name.ljust(34), "test accuracy:", round(m.score(X_te_s, y_te), 3))
OUTPUT
Koi hidden layer nahi (Logistic)   test accuracy: 0.978
Hidden layers (16,)                test accuracy: 0.958
Hidden layers (64,)                test accuracy: 0.978
Hidden layers (128, 64)            test accuracy: 0.98
Hidden layers (128, 64, 32)        test accuracy: 0.976
22.2 Overfitting neural network me
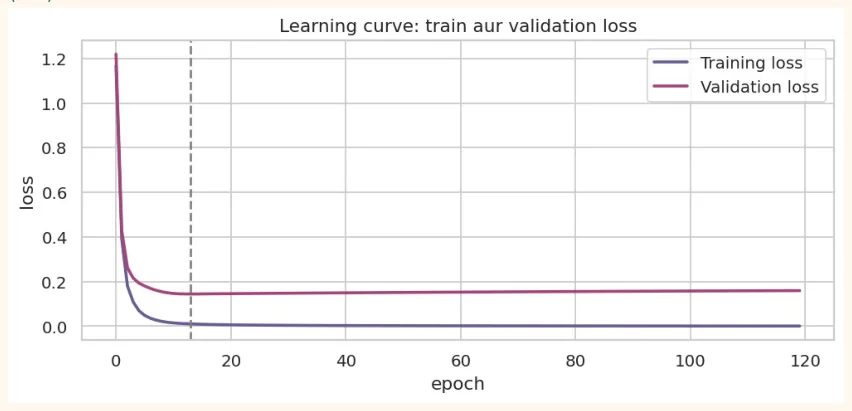
Neural network ke parameters bohat zyada hote hain, is liye wo training data yaad kar leta hai. Pehchanne ka tareeqa: har epoch par training loss aur validation loss dono dekho. Agar training loss girta rahe magar validation loss uper jane lage , to overfitting shuru ho gayi.
OUTPUT
Validation loss sab se kam epoch: 14
Us waqt train loss: 0.0103  val loss: 0.1445
Aakhri epoch par  train loss: 0.0008  val loss: 0.1595
OUTPUT (chart)
22.3 Regularization: overfitting ka ilaaj
1) L2 Regularization (Weight Decay)
Chapter 13 me Ridge yaad karo: loss me weights ke squares ka jurmana jodna. Neural network me bhi wohi: bade weights ko saza milti hai, to network saada rehta hai. sklearn me parameter alpha , Keras me kernel_regularizer=regularizers.l2(0.001).
2) Dropout
Training ke dauran har step par kuch neurons ko random band (0) kar diya jata hai (maslan 30% ya 50%). Network kisi ek neuron par bharosa nahi kar sakta, is liye har neuron mazboot features seekhta hai. Testing me dropout band hota hai.
3) Early Stopping
Jab validation loss behtar hona band ho jaye (kuch epochs tak), training rok do aur behtareen weights wapas le lo. Ye sab se saada aur asardaar tareeqa hai.
es = MLPClassifier(hidden_layer_sizes=(128, 64), early_stopping=True,
validation_fraction=0.15, n_iter_no_change=10,
max_iter=500, random_state=0)
es.fit(X_tr_s, y_tr)
print("max_iter 500 tha, training ruki:", es.n_iter_, "epochs par")
print("Behtareen validation score:", round(es.best_validation_score_, 3))
print("Test accuracy:", round(es.score(X_te_s, y_te), 3))
OUTPUT
max_iter 500 tha, training ruki: 31 epochs par
Behtareen validation score: 0.975
Test accuracy: 0.971
4) L2 (alpha) ka asar
for a in [0.0001, 0.01, 0.1, 1, 3]:
    m = MLPClassifier(hidden_layer_sizes=(128, 64), alpha=a,
    max_iter=500, random_state=0).fit(X_tr_s, y_tr)
    print("alpha =", str(a).ljust(7), "train:", round(m.score(X_tr_s, y_tr), 3),
    "  test:", round(m.score(X_te_s, y_te), 3))
OUTPUT
alpha = 0.0001  train:
1.0   test:
0.98
alpha = 0.01    train:
1.0   test:
0.978
alpha = 0.1     train:
1.0   test:
0.984
alpha = 1       train:
1.0   test:
0.98
alpha = 3       train:
0.996   test:
0.976
SUNEHRA USOOL
-
Pehle Early Stopping lagao, ye hamesha madad karta hai.
-
Phir zaroorat ho to Dropout (0.2 se 0.5) ya L2 aazmao.
-
Sab se asardaar hal aksar zyada data ya chhota network hota hai.
22.4 Batch Normalization
Gehre networks me har layer ke inputs ka scale badalta rehta hai, jis se training mushkil hoti hai. Batch Normalization har layer ke output ko (har mini-batch par) mean 0 aur std 1 par le aati hai, phir do seekhe hue parameters ( gamma scale ke liye, beta shift ke liye) lagati hai. Nateeja: training tez aur stable .
np.random.seed(0)
batch = np.random.randn(32, 4) * [1, 10, 100, 0.1] + [5, -20, 300, 0]   # 4 features, bohat
mukhtalif scale
print("Pehle   mean:", batch.mean(axis=0).round(1))
print("Pehle   std :", batch.std(axis=0).round(1))
eps = 1e-5
normed = (batch - batch.mean(axis=0)) / np.sqrt(batch.var(axis=0) + eps)
print("Baad me mean:", normed.mean(axis=0).round(2))
print("Baad me std :", normed.std(axis=0).round(2))
OUTPUT
Pehle   mean: [  5.1 -18.9 297.3   0. ]
Pehle   std : [ 1.2 11.1 80.8  0.1]
Baad me mean: [-0. -0. -0.  0.]
Baad me std : [1. 1. 1. 1.]
22.5 Weight Initialization
Weights ka shuru ka qadar (initial value) bohat ahem hai. Agar sab zero ho to sab neurons ek jaisa seekhte hain (symmetry). Agar bohat bare hon to activations phat jate hain, bohat chhote hon to signal mar jata hai . Do mashhoor tareeqay:
Naam Formula (std) Kis activation ke saath Xavier / Glorot sqrt(2 / (fan_in + fan_out)) Sigmoid, Tanh (Keras ka default) He sqrt(2 / fan_in) ReLU
np.random.seed(0)
def forward_std(init, layers=10, width=256):
    a = np.random.randn(1000, width)
    stds = []
    for _ in range(layers):
        fan_in = a.shape[1]
        if init == "chhota (0.01)":
            W = np.random.randn(fan_in, width) * 0.01
        elif init == "bara (1.0)":
            W = np.random.randn(fan_in, width) * 1.0
else:
    W = np.random.randn(fan_in, width) * np.sqrt(2 / fan_in)   # He
a = np.maximum(0, a @ W)             # ReLU stds.append(a.std()) return stds
for init in ["chhota (0.01)", "bara (1.0)", "He"]:
    s = forward_std(init)
    print(init.ljust(14), "layer 1:", format(s[0], ".4g").ljust(10), "layer 5:", format(s[4], ".4g").ljust(11), "layer 10:", format(s[9], ".4g"))
OUTPUT chhota (0.01) layer 1: 0.09312 layer 5: 1.614e-05 layer 10: 3.094e-10 bara (1.0) layer 1: 9.325 layer 5: 1.601e+05 layer 10: 2.532e+10 He layer 1: 0.8284 layer 5: 0.7855 layer 10: 0.6848
He initialization me signal ka size har layer par qareeb qareeb ek jaisa rehta hai, jab ke ghalat scale par ya to ghat kar khatam hota hai ya phat jata hai.
22.6 Vanishing aur Exploding Gradients
Backprop me gradient har layer par guna hota jata hai. Agar har factor 1 se chhota ho to gradient peeche jate jate khatam ho jata hai ( vanishing ), aur agar bara ho to phat jata hai ( exploding ). Sigmoid ka derivative ziyada se ziyada 0.25 hota hai, to gehre sigmoid networks me pehli layers kuch seekh hi nahi pati.
sig = lambda z:
1 / (1 + np.exp(-z))
np.random.seed(1)
depth = 10
for name, act, dact in [
("Sigmoid", sig, lambda a: a * (1 - a)),
("ReLU",    lambda z: np.maximum(0, z), lambda a: (a > 0).astype(float)),
]:
h = np.random.randn(64, 100)
Ws, As = [], [h]
for _ in range(depth):
    W = np.random.randn(100, 100) * np.sqrt(2 / 100)
    h = act(h @ W)
    Ws.append(W)
    As.append(h)
    g = np.ones_like(h)              # aakhri layer par
    gradient = 1
    mags = []
    for W, a in zip(reversed(Ws), reversed(As[1:])):
        g = (g * dact(a)) @ W.T
        mags.append(np.abs(g).mean())
        mags = mags[::-1]
        print(name.ljust(8), "gradient size, pehli layer:", format(mags[0], ".2e"),
        "| aakhri layer:", format(mags[-1], ".2e"))
OUTPUT
Sigmoid  gradient size, pehli layer: 6.70e-06 | aakhri layer: 2.54e-01
ReLU     gradient size, pehli layer: 1.86e+00 | aakhri layer: 8.29e-01
22.7 Optimizers: network ko tez aur behtar seekhana
Gradient descent weights ko
w = w - lr * gradient
se update karta hai. Isi ke kai behtar roop hain:
| Optimizer | Idea | Fayda / Nuqsan |
|---|---|---|
| SGD | Har mini-batch ke gradient par seedha qadam | Saada; dheema ho sakta hai, learning rate par bohat nirbhar |
| SGD + Momentum | Pichle qadmon ki "raftar" bhi jama rakho | Ghatiyon (valleys) me tez, oscillation kam |
| RMSprop | Har parameter ka learning rate gradient ke size se adjust | Alag alag scale wale parameters ke liye acha |
| Adam | Momentum + RMSprop ka milap | Sab se mashhoor default; aksar bina tuning acha chalta hai |
OUTPUT
SGD       loss 60 qadam baad: 0.0365  | loss<0.01 hone me qadam: None
Momentum  loss 60 qadam baad: 0.0167  | loss<0.01 hone me qadam: 57
RMSprop   loss 60 qadam baad: 0.0005  | loss<0.01 hone me qadam: 15
Adam      loss 60 qadam baad: 0.0018  | loss<0.01 hone me qadam: 58
xx, yy = np.meshgrid(np.linspace(-8, 4, 200), np.linspace(-3, 3, 200))
zz = 0.1 * xx**2 + 2 * yy**2
cols = {"SGD": "#6B5B95", "Momentum": "#A4457A", "RMSprop": "#2F7D4F", "Adam": "#B7791F"}
fig, ax = plt.subplots(figsize=(9, 4))
ax.contour(xx, yy, zz, levels=18, cmap="Greys", alpha=0.5)
for name, pa in paths.items():
    ax.plot(pa[:, 0], pa[:, 1], "o-", ms=3, lw=1.5, color=cols[name], label=name)
ax.plot(0, 0, "k*", ms=14)
ax.set_title("Optimizers ke raaste (ghati ke beech tak)")
ax.legend()
plt.show()
OUTPUT (chart)
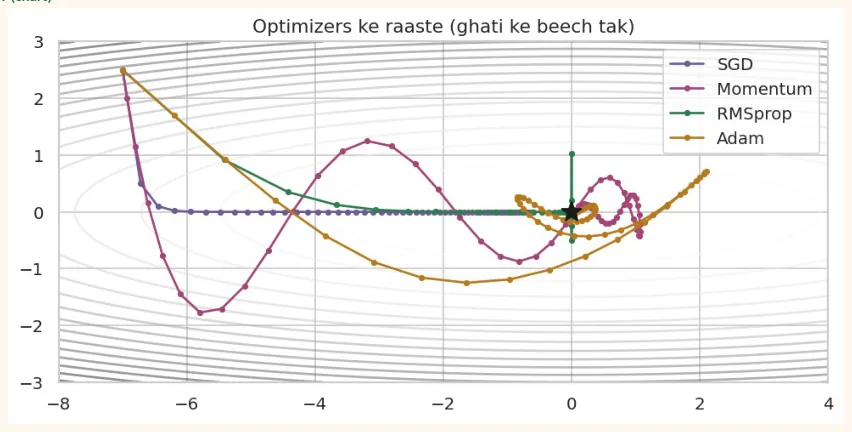
Is tajurbe se ek sabaq: koi optimizer har masle me sab se behtar nahi hota, har ek ka asar learning rate aur masle ki shakal par nirbhar hai. Practice me Adam (lr = 0.001) se shuru karna aam hai.
sklearn me solvers ka muqabla (Digits par)
import time
for solver, kw in [("sgd", {"learning_rate_init": 0.01, "momentum": 0}),
("sgd", {"learning_rate_init": 0.01, "momentum": 0.9,
"nesterovs_momentum": True}),
("adam", {"learning_rate_init": 0.001})]:
m = MLPClassifier(hidden_layer_sizes=(128, 64), solver=solver, max_iter=60,
random_state=0, **kw)
import warnings
warnings.filterwarnings("ignore")
m.fit(X_tr_s, y_tr)
tag = solver + (" + momentum" if kw.get("momentum", 0) > 0 else " (plain)")
if solver ==
"sgd"
else "adam"
print(tag.ljust(15), "final train loss:", round(m.loss_, 4),
" test acc:", round(m.score(X_te_s, y_te), 3))
OUTPUT
sgd (plain)     final train loss: 0.4275  test acc: 0.904
sgd + momentum  final train loss: 0.0206  test acc: 0.971
adam            final train loss: 0.0042  test acc: 0.978
22.8 Learning Rate aur Scheduling
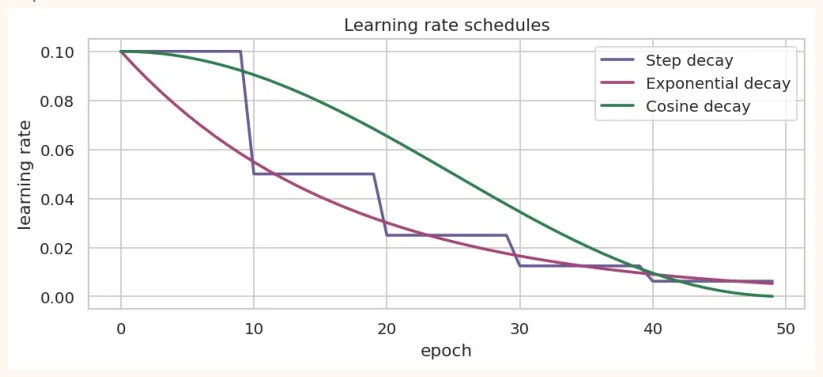
Learning rate (lr) sab se ahem hyperparameter hai. Bohat bara: loss uchhalta hai ya phat jata hai. Bohat chhota: training bohat dheemi. Scheduling me shuru me bara lr rakhte hain (tez safar) aur baad me chhota karte jate hain (nazuk adjustment).
epochs = np.arange(0, 50)
lr0 = 0.1
step = lr0 * 0.5 ** (epochs // 10)           # har 10 epoch par aadha
expo = lr0 * np.exp(-0.06 * epochs)          # silsila war ghatna
cosine = 0.5 * lr0 * (1 + np.cos(np.pi * epochs / 50))
print("epoch 0  :", lr0, round(expo[0], 4), round(cosine[0], 4))
print("epoch 25 : step", round(step[25], 4), " exp", round(expo[25], 4), " cosine",
round(cosine[25], 4))
print("epoch 49 : step", round(step[49], 4), " exp", round(expo[49], 4), " cosine",
round(cosine[49], 4))
fig, ax = plt.subplots(figsize=(9, 3.4))
ax.plot(epochs, step, color="#6B5B95", lw=2, label="Step decay")
ax.plot(epochs, expo, color="#A4457A", lw=2, label="Exponential decay")
ax.plot(epochs, cosine, color="#2F7D4F", lw=2, label="Cosine decay")
ax.set_xlabel("epoch")
ax.set_ylabel("learning rate")
ax.legend()
ax.set_title("Learning rate schedules")
plt.show()
OUTPUT
epoch 0  : 0.1 0.1 0.1
epoch 25 : step 0.025  exp 0.0223  cosine 0.05
epoch 49 : step 0.0062  exp 0.0053  cosine 0.0001
OUTPUT (chart)
22.9 Keras me ye sab: gehra network aur callbacks
Ab sab kuch ek Keras model me jodte hain: Dense + BatchNormalization + Dropout + L2 , Adam optimizer, aur callbacks ( EarlyStopping , ReduceLROnPlateau ). Multiclass labels (0 se 9 integers) hain, to loss sparse_categorical_crossentropy.
from tensorflow import keras
from tensorflow.keras import layers, regularizers, callbacks
model = keras.Sequential([
keras.Input(shape=(64,)),
layers.Dense(128, activation="relu", kernel_regularizer=regularizers.l2(1e-4)),
layers.BatchNormalization(),
layers.Dropout(0.3),
layers.Dense(64, activation="relu"),
layers.Dense(10, activation="softmax"),
])
model.compile(optimizer=keras.optimizers.Adam(learning_rate=0.001),
loss="sparse_categorical_crossentropy",
metrics=["accuracy"])
model.summary()
OUTPUT (namoona)
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━Layer (type)┃┃┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ | ┳━━━━━━━━━━━━━━━━━━━━━━━━Output Shape━━━━━━━━━━━━━━━━━━━━━━━━ | ━━┳━━━━━━━━━━━━━━━━━┓Param #┃┃━━╇━━━━━━━━━━━━━━━━━┩ |
|---|---|---|
│ dense (Dense) │ | (None, 128) | │ 8,320 │ |
│ batch_normalization (BatchNormalization) │ | (None, 128) | │ 512 │ |
│ dropout (Dropout) │ | (None, 128) | │ 0 │ |
│ dense_1 (Dense) │ | (None, 64) | │ 8,256 │ |
│ dense_2 (Dense) │└──────────────────────────────────────────┴ | (None, 10)──────────────────────── | │ 650 │──┴─────────────────┘ |
Total params: 17,738 (69.29 KB) | ||
Trainable params: 17,482 (68.29 KB) | ||
Non-trainable params: 256 (1.00 KB) |
OUTPUT (namoona)
Training ruki: 31 epochs par (max 200)
Test accuracy: 0.978
22.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Test set par early stopping/tuning karna. Hamesha alag validation set (ya
validation_split) use karo. -
Dropout testing me bhi lagana. Keras
predictme ye khud band karta hai, magar apne hath ke code me dhyan do. -
BatchNorm aur Dropout ko saath saath ghalat tarteeb se lagana; aam tarteeb: Dense, BatchNorm, Activation, Dropout.
-
Adam ke saath bohat bara lr (jaise 0.1) rakhna.
-
Har masle me bara network lagana. Pehle chhota network aur baseline.
-
Data scale na karna aur phir kehna ke "network seekh nahi raha".
Hands-on
-
Overfit karo: Digits par
(256,128)ka network sgd se chalao aur learning curve me val loss ka uper jana khud dekho. -
Alpha badlo:
alphako 0.0001 se 3 tak badal kar train aur test accuracy ka farq likho. -
Optimizer race: upar ke optimizer code me
lrbadlo (SGD 0.5 par kya hota hai?). -
Dropout rate: Keras model me dropout 0.1, 0.3, 0.6 aazmao.
-
Callbacks:
patience3 aur 20 rakh karlen(history.history["loss"])ka muqabla karo.
KEY TAKEAWAYS
-
Gehra network = zyada taqat magar zyada overfitting ka khatra; chhote se shuru karo.
-
Overfitting ki pehchan: train loss girta rahe, validation loss uper jaye.
-
Regularization: Early Stopping (pehli pasand), L2, Dropout; training me dropout, testing me nahi.
-
Batch Normalization har layer ke inputs ko normalize kar ke training tez aur stable banata hai.
-
Initialization: ReLU ke liye He , sigmoid/tanh ke liye Xavier . Zero initialization kabhi nahi.
-
Vanishing gradient: sigmoid ka derivative <= 0.25; ReLU aur BatchNorm madadgar hain.
-
Optimizers: SGD, Momentum, RMSprop, Adam. Adam (lr=0.001) aam default hai.
-
Learning rate sab se ahem hyperparameter hai; scheduling aur ReduceLROnPlateau use karo.