Chapter 27: Autoencoders aur Representation Learning
MODULE 5 | WEEK 27
Chapter 27: Autoencoders aur Representation Learning
Ab tak ke neural networks me hume jawab (label) milta tha. Autoencoder ek aisa network hai jo khud apne aap se seekhta hai : wo apne input ko pehle chhote khulase (code) me dabata hai, phir us khulase se wapas asal input banane ki koshish karta hai. Is koshish me wo data ki sab se ahem maloomat seekh leta hai, isay Representation Learning kehte hain. Is chapter me autoencoder ki banawat, PCA se muqabla , denoising , anomaly detection , aur aakhir me VAE ka idea dekhenge jo agle chapter ke GAN ka rasta banata hai.
27.1 Autoencoder kya hai?
Autoencoder ke teen hisse hain:
| Hissa | Kaam | Shakal |
|---|---|---|
| Encoder | Input ko chhote code me dabata hai | Layers jo size kam karti jati hain (64 -> 32 -> 8) |
| Bottleneck (Latent) | Sab se chhota hissa; maloomat ka khulasa | Chhoti si layer (maslan 8 numbers) |
| Decoder | Code se wapas asal input banata hai | Layers jo size barhati jati hain (8 -> 32 -> 64) |
Input  ->  Encoder  ->  CODE (chhota)  ->  Decoder  ->  Reconstruction
 64                         8                         64
Loss = reconstruction error = aam( (Input - Reconstruction)^2 )
Target (y) = khud Input!  (isi liye "self-supervised" bhi kehte hain)
27.2 Autoencoder vs PCA
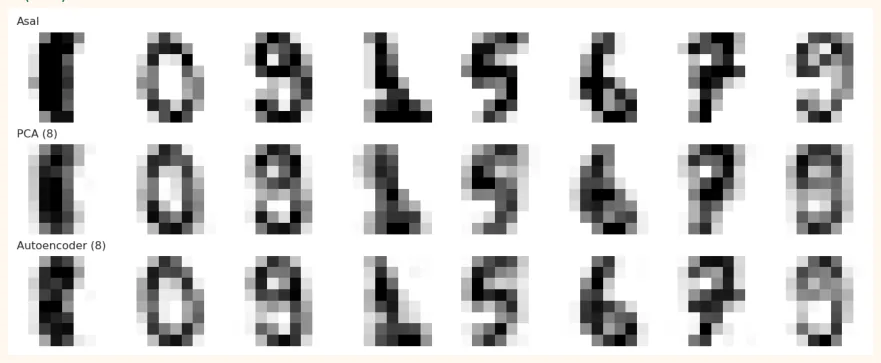
Chapter 17 me PCA ne bhi 64 columns ko kam kiya tha. PCA aur autoencoder ka maqsad ek hi hai, magar PCA sirf linear (seedhe) tareeqe se dabata hai, jab ke autoencoder non-linear (tedhe) rishte bhi pakad sakta hai. Dono ko Digits par 8 numbers tak dabane ka muqabla:
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.decomposition import PCA
from sklearn.neural_network import MLPRegressor
digits = load_digits()
X, y = digits.data / 16.0, digits.target                # 0 se 1
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25,
random_state=42, stratify=y)
# PCA:
64 -> 8 -> 64
pca = PCA(n_components=8).fit(X_tr)
rec_pca = pca.inverse_transform(pca.transform(X_te))
# Autoencoder:
64 -> 64 -> 8 -> 64 -> 64   (target = khud input)
ae = MLPRegressor(hidden_layer_sizes=(64, 8, 64), activation="relu",
learning_rate_init=0.002, max_iter=3000,
tol=1e-7, n_iter_no_change=100, random_state=0)
ae.fit(X_tr, X_tr)
rec_ae = ae.predict(X_te)
mse = lambda a, b:
np.mean((a - b) ** 2)
print("PCA (8 components)  reconstruction MSE:", round(mse(X_te, rec_pca), 4))
print("Autoencoder (8-d)   reconstruction MSE:", round(mse(X_te, rec_ae), 4))
print("Autoencoder ke layer sizes:", [ae.coefs_[0].shape[0]] + [c.shape[1] for c in
ae.coefs_])
OUTPUT
PCA (8 components)  reconstruction MSE: 0.0245
Autoencoder (8-d)   reconstruction MSE: 0.0186
Autoencoder ke layer sizes: [64, 64, 8, 64, 64]
Is run me autoencoder ka error PCA se kam aaya: 8 numbers me dabane ke baad bhi tasveer ko behtar wapas bana pata hai, kyun ke wo tedhe rishte bhi seekh sakta hai. (Chhote data aur chhote network par farq bohat bara nahi hota, aur ek seed se doosre seed me thora badal sakta hai.)
Reconstruction dekhna
idx = np.arange(8)
fig, axes = plt.subplots(3, 8, figsize=(10, 4))
rows = [("Asal", X_te), ("PCA (8)", rec_pca), ("Autoencoder (8)", rec_ae)]
for r, (name, data) in enumerate(rows):
    for c, i in enumerate(idx):
        axes[r, c].imshow(data[i].reshape(8, 8), cmap="gray_r", interpolation="nearest",
        vmin=0, vmax=1)
        axes[r, c].axis("off")
        axes[r, 0].set_title(name, fontsize=9, loc="left")
        plt.tight_layout()
        plt.show()
OUTPUT (chart)
27.3 Denoising Autoencoder
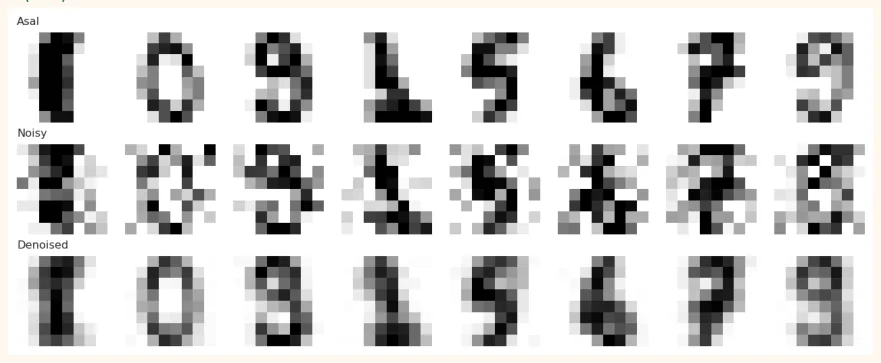
Input me jaanbujh kar shor (noise) daal kar network ko sikhate hain ke saaf (clean) tasveer wapas banaye. Is se wo shor nikalna seekh jata hai (purani, dhundli tasveeron ki safai, scan shuda papers).
rng = np.random.RandomState(0)
X_tr_noisy = np.clip(X_tr + rng.normal(0, 0.3, X_tr.shape), 0, 1)
X_te_noisy = np.clip(X_te + rng.normal(0, 0.3, X_te.shape), 0, 1)
dae = MLPRegressor(hidden_layer_sizes=(64, 16, 64), activation="relu",
learning_rate_init=0.003, max_iter=800, random_state=0)
dae.fit(X_tr_noisy, X_tr)                 # input:
noisy,  target:
CLEAN
denoised = dae.predict(X_te_noisy)
print("Noisy tasveer ka error (clean ke muqable me):", round(mse(X_te_noisy, X_te), 4))
print("Denoise karne ke baad error                 :", round(mse(denoised, X_te), 4))
fig, axes = plt.subplots(3, 8, figsize=(10, 4))
for r, (name, data) in enumerate([("Asal", X_te), ("Noisy", X_te_noisy), ("Denoised",
denoised)]):
for c in range(8):
    axes[r, c].imshow(data[c].reshape(8, 8), cmap="gray_r", interpolation="nearest",
    vmin=0, vmax=1)
    axes[r, c].axis("off")
    axes[r, 0].set_title(name, fontsize=9, loc="left")
    plt.tight_layout()
    plt.show()
OUTPUT
Noisy tasveer ka error (clean ke muqable me): 0.0527
Denoise karne ke baad error                 : 0.0318
OUTPUT (chart)
27.4 Anomaly Detection: ajeeb cheez pakadna
Idea: autoencoder ko sirf "normal" data par train karo. Wo normal cheezon ko ache se wapas bana lega, magar anokhi (anomaly) cheez ko kharab banayega, yani uska reconstruction error bara hoga. Bank fraud, machine ki kharabi, network hamla pakadne me yehi tareeqa chalta hai.
Tajurba: autoencoder ko 0 se 8 ke digits par train karo (9 kabhi dikhao hi nahi), phir dekho ke test me 9 par error zyada aata hai ya nahi.
from sklearn.metrics import roc_auc_score
normal = y_tr != 9
ae_n = MLPRegressor(hidden_layer_sizes=(64, 8, 64), activation="relu",
learning_rate_init=0.002, max_iter=3000,
tol=1e-7, n_iter_no_change=100, random_state=0)
ae_n.fit(X_tr[normal], X_tr[normal])             # sirf normal (9 ke bina)
err = ((X_te - ae_n.predict(X_te)) ** 2).mean(axis=1)    # har tasveer ka error
is_anomaly = (y_te == 9)
print("Normal tasveeron ka aam error :", round(err[~is_anomaly].mean(), 4))
print("Digit 9 (anomaly) ka aam error:", round(err[is_anomaly].mean(), 4))
print("ROC-AUC (error se anomaly pehchan):", round(roc_auc_score(is_anomaly, err), 3))
fig, ax = plt.subplots(figsize=(8, 3.2))
ax.hist(err[~is_anomaly], bins=30, alpha=0.7, color="#6B5B95", label="Normal (0 se 8)")
ax.hist(err[is_anomaly], bins=30, alpha=0.7, color="#A4457A", label="Anomaly (9)")
ax.set_xlabel("reconstruction error")
ax.legend()
ax.set_title("Anomalies ka error zyada hota hai")
plt.show()
OUTPUT
Normal tasveeron ka aam error : 0.0173
Digit 9 (anomaly) ka aam error: 0.0384
ROC-AUC (error se anomaly pehchan): 0.891
OUTPUT (chart)
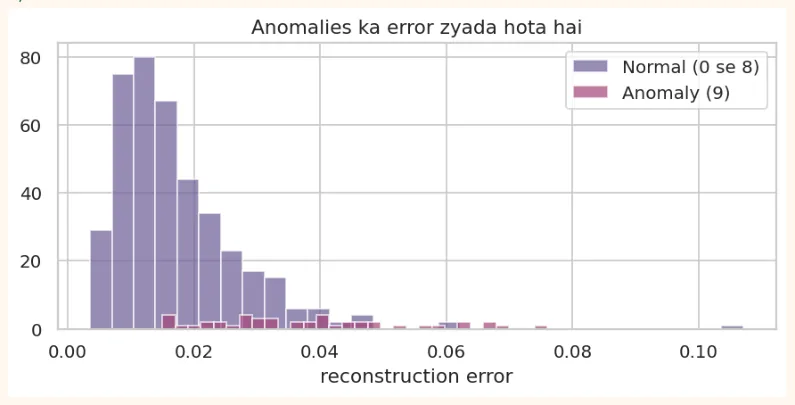
AUC 0.5 matlab andaza lagana, 1.0 matlab mukammal. Yahan AUC 0.5 se kaafi upar hai, yani error se anomaly ki pehchan mumkin hai (par mukammal nahi, kyun ke 9 aur 4/7 jaise digits aapas me milte hain). Threshold chunne ke liye validation data par aisa error chuno jis se kam se kam 95% normal neeche rahein.
AAM GALTIYAN
-
Training me anomalies shamil karna: phir network unhein bhi seekh leta hai.
-
Threshold andaze se rakhna. Hamesha validation data par tay karo.
-
Bohat bara bottleneck: network har cheez copy kar leta hai, anomalies ka error bhi chhota.
27.5 Representation Learning: encoder ke features
Autoencoder ka encoder hissa data ko 8 maani-khez numbers me badalta hai. Ye numbers dusre model (jaise classifier) ko input diye ja sakte hain. Pehle label ke baghair representation seekhi jati hai, phir kam labels par bhi classifier banane ki koshish ki jati hai ( semi-supervised ).
from sklearn.linear_model import LogisticRegression
def encode(model, X):
    """Autoencoder ke pehle do layers (bottleneck tak) hath se chalao"""
    a = np.maximum(0, X @ model.coefs_[0] + model.intercepts_[0])
    return np.maximum(0, a @ model.coefs_[1] + model.intercepts_[1])
Z_tr, Z_te = encode(ae, X_tr), encode(ae, X_te)
print("Code shape:", Z_tr.shape, "(64 pixels -> 8 numbers)")
raw = LogisticRegression(max_iter=3000).fit(X_tr, y_tr)
code = LogisticRegression(max_iter=3000).fit(Z_tr, y_tr)
pca_f = LogisticRegression(max_iter=3000).fit(pca.transform(X_tr), y_tr)
print("Asal 64 pixels par accuracy :", round(raw.score(X_te, y_te), 3))
print("Autoencoder ke 8 numbers par :", round(code.score(Z_te, y_te), 3))
print("PCA ke 8 numbers par         :", round(pca_f.score(pca.transform(X_te), y_te), 3))
OUTPUT
Code shape: (1347, 8) (64 pixels -> 8 numbers)
Asal 64 pixels par accuracy : 0.962
Autoencoder ke 8 numbers par : 0.916
PCA ke 8 numbers par         : 0.9
Dhyan se parho: 8 numbers (asal ka 8 mein se ek hissa) par bhi classifier ne qareeb 92% accuracy di, jab ke asal 64 pixels par ~96% thi. Autoencoder ke codes PCA ke 8 numbers se behtar rahe. Yani 8 guna chhoti
representation me zyada tar maloomat bach gayi. Yehi representation learning hai: pehle data ka maani-khez khulasa seekho, phir usay istemal karo. Bade models (BERT, GPT, Chapter 30) isi idea ka bohat bara roop hain.
# Kam labels par: sirf 100 labelled tasveerein
small = np.random.RandomState(1).choice(len(X_tr), 100, replace=False)
raw100 = LogisticRegression(max_iter=3000).fit(X_tr[small], y_tr[small])
code100 = LogisticRegression(max_iter=3000).fit(Z_tr[small], y_tr[small])
print("Sirf 100 labels, asal pixels par     :", round(raw100.score(X_te, y_te), 3))
print("Sirf 100 labels, autoencoder codes par:", round(code100.score(Z_te, y_te), 3))
OUTPUT
Sirf 100 labels, asal pixels par     : 0.902
Sirf 100 labels, autoencoder codes par: 0.88
Is chhote tajurbe me asal pixels thore behtar rahe. Isi liye ye na samajhna ke representation learning har jagah jeet jata hai. Fayda tab nazar aata hai jab bohat saara bina label ka data ho aur labelled data bohat kam ho, aur jab data bara aur pecheeda (tasveer, text) ho. Hamesha raw features ka baseline saath rakho aur nateeja khud dekho.
27.6 Keras me Autoencoder
Dense Autoencoder
from tensorflow import keras
from tensorflow.keras import layers
inputs = keras.Input(shape=(64,))
x = layers.Dense(32, activation="relu")(inputs)
code = layers.Dense(8, activation="relu", name="code")(x)      # bottleneck
x = layers.Dense(32, activation="relu")(code)
outputs = layers.Dense(64, activation="sigmoid")(x)            # pixels 0 se 1
autoencoder = keras.Model(inputs, outputs)
encoder = keras.Model(inputs, code)                            # sirf encoder alag se
autoencoder.compile(optimizer="adam", loss="mse")
autoencoder.summary()
OUTPUT (namoona)
Model: "functional"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━Layer (type)┃┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ | ━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━Output Shape┃━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━ | ━━┳━━━━━━━━━━━━━━━━━┓Param #┃┃━━╇━━━━━━━━━━━━━━━━━┩ |
|---|---|---|
│ input_layer (InputLayer) | │ (None, 64) | │ 0 │ |
│ dense (Dense) | │ (None, 32) | │ 2,080 │ |
│ code (Dense) | │ (None, 8) | │ 264 │ |
│ dense_1 (Dense) | │ (None, 32) | │ 288 │ |
│ dense_2 (Dense)└─────────────────────────────── | │ (None, 64)────┴──────────────────────── | │ 2,112 │──┴─────────────────┘ |
 Total params: 4,744 (18.53 KB)
 Trainable params: 4,744 (18.53 KB)
 Non-trainable params: 0 (0.00 B)
OUTPUT (namoona)
Codes ki shape: (450, 8)
Convolutional Autoencoder (tasveeron ke liye behtar)
Tasveeron par Dense ke bajaye Conv2D + MaxPooling2D (encoder) aur Conv2D + UpSampling2D (decoder) behtar chalte hain. UpSampling2D tasveer ka size doguna karta hai (pooling ka ulta).
def conv_p(k, in_ch, out_ch):
    return (k * k * in_ch + 1) * out_ch
layers_p = [conv_p(3, 1, 8), conv_p(3, 8, 4), conv_p(3, 4, 4), conv_p(3, 4, 8), conv_p(3, 8,
1)]
print("Har Conv2D ke parameters:", layers_p)
print("Kul:", sum(layers_p))
OUTPUT
Har Conv2D ke parameters: [80, 292, 148, 296, 73]
Kul: 889
inp = keras.Input(shape=(8, 8, 1))
x = layers.Conv2D(8, 3, padding="same", activation="relu")(inp)   # (8, 8, 8)
x = layers.MaxPooling2D(2)(x)                                      # (4, 4, 8)
x = layers.Conv2D(4, 3, padding="same", activation="relu")(x)      # (4, 4, 4)
x = layers.MaxPooling2D(2)(x)                                      # (2, 2, 4)  <-
bottleneck: 16 numbers
x = layers.Conv2D(4, 3, padding="same", activation="relu")(x)      # (2, 2, 4)
x = layers.UpSampling2D(2)(x)                                      # (4, 4, 4)
x = layers.Conv2D(8, 3, padding="same", activation="relu")(x)      # (4, 4, 8)
x = layers.UpSampling2D(2)(x)                                      # (8, 8, 8)
out = layers.Conv2D(1, 3, padding="same", activation="sigmoid")(x) # (8, 8, 1)
conv_ae = keras.Model(inp, out)
conv_ae.compile(optimizer="adam", loss="mse")
print("Kul parameters:", conv_ae.count_params())
OUTPUT (namoona)
Kul parameters: 889
27.7 Variational Autoencoder (VAE): generation ka rasta
Aam autoencoder ka code ek ek number-list (point) hota hai. VAE me encoder ek point ke bajaye ek distribution (mean aur variance) deta hai, aur code us distribution me se random sample hota hai. Is se latent space smooth ho jati hai, aur hum naye code sample kar ke decoder se nayi tasveerein bana sakte hain: yaani autoencoder se generative model .
Encoder ->  mu, log_var   (distribution ke 2 hisse)
            z = mu + sigma * epsilon,   epsilon ~ Normal(0, 1)    <- reparameterization
trick
Decoder ->  reconstruction
Loss = reconstruction loss  +  KL divergence(distribution, Normal(0,1))
       (sahi banao)             (latent space ko saaf-suthra rakho)
np.random.seed(0)
mu, log_var = np.array([1.0, -0.5]), np.array([-1.0, 0.0])       # encoder ke outputs (2-d
latent)
sigma = np.exp(0.5 * log_var)
samples = []
for _ in range(5):
    eps = np.random.randn(2)           # random shor
    z = mu + sigma * eps               # reparameterization trick
    samples.append(z)
print("Ek hi input ke 5 alag alag latent samples:")
print(np.array(samples).round(2))
kl = -0.5 * np.sum(1 + log_var - mu**2 - np.exp(log_var))
print("KL divergence:", round(kl, 3))
OUTPUT
Ek hi input ke 5 alag alag latent samples:
[[ 2.07 -0.1 ]
 [ 1.59  1.74]
 [ 2.13 -1.48]
 [ 1.58 -0.65]
 [ 0.94 -0.09]]
KL divergence: 0.809
Reparameterization trick ka maqsad: random sampling ko mu + sigma * epsilon banane se gradient mu aur sigma tak pohanch sakta hai (backprop chal sakta hai), kyun ke randomness sirf epsilon me hai.
27.8 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Bottleneck input jitna bara rakhna: network sirf copy karna seekhta hai.
-
Autoencoder ko sirf accuracy se nahi, reconstruction dekh kar parakhna.
-
Test/anomaly data par encoder train karna (leakage).
-
Anomaly detection me threshold andaze se rakhna.
-
Dense autoencoder bari tasveeron par (parameters bohat); Conv autoencoder use karo.
-
Input aur target ka farq bhoolna: autoencoder me
fit(X, X), denoising mefit(X_noisy, X_clean).
Hands-on
-
Bottleneck badlo: NumPy/sklearn autoencoder me bottleneck 2, 4, 8, 16 karo aur reconstruction MSE ka graph banao.
-
Noise badlo: denoising me noise std 0.1, 0.3, 0.6 aazmao.
-
Anomaly: 9 ki jagah 0 ko anomaly bana kar AUC dekho.
-
PCA se muqabla: har bottleneck size par PCA aur autoencoder ka MSE table me likho.
-
Keras: Colab me
fashion_mnistpar Dense autoencoder (784 -> 64 -> 784) banao aur reconstruction chart dekho.
KEY TAKEAWAYS
-
Autoencoder = Encoder + Bottleneck + Decoder; target khud input hota hai (self-supervised).
-
Bottleneck chhota rakho warna network sirf copy karta hai.
-
PCA linear compression hai, autoencoder non-linear; autoencoder aksar kam error deta hai.
-
Denoising AE: input noisy, target clean.
-
Anomaly detection: sirf normal par train; anomaly ka reconstruction error bara.
-
Representation learning: encoder ke chhote codes dusre models ko input diye ja sakte hain; fayda data aur masle par nirbhar hai, raw baseline hamesha saath rakho.
-
Conv autoencoder (Conv2D + UpSampling2D) tasveeron ke liye behtar.
-
VAE: code ek distribution hai, reparameterization trick se sampling aur generation mumkin.