Chapter 28: GANs aur Deep Learning Capstone Mini Project
MODULE 5 | WEEK 28
Chapter 28: GANs aur Deep Learning Capstone Mini Project
Ab tak ke tamam models pehchante ya andaza lagate the (classification, regression). Generative models ek qadam aage jate hain: wo bilkul naya data banate hain jo asli jaisa lagta hai (nayi tasveerein, awaaz, text). Is chapter me hum GAN (Generative Adversarial Network) seekhenge: do networks ka muqabla jo ek doosre ko behtar banata hai. Phir Module 5 ka Capstone Mini Project karenge, jis me tum ne jo kuch seekha (ANN, CNN, regularization, evaluation) wo ek mukammal project me jode jayenge.
28.1 Generative models kya hote hain?
| Qism | Sawal jo hal karta hai | Misaal |
|---|---|---|
| Discriminative | Ye input kis class ka hai? (y ko x se jodta hai) | Ye tasveer billi hai ya kutta? |
| Generative | Is class jaisanayadata kaise banaun? | Naye chehre, nayi tasveerein, nayi dhun |
Autoencoder (VAE) ek generative model ban sakta hai (Chapter 27). GAN isi maqsad ka ek alag aur bohat mashhoor tareeqa hai, jis ne 2014 me Ian Goodfellow ke paper se shuruat ki.
28.2 GAN ka idea: Jaali note aur Police
Loss aur training ke qadam
Har iteration me do kaam baari baari :
-
D ko train karo: asli data ke liye target 1 , G ke banaye fake ke liye target 0 (Binary Cross-Entropy).
-
G ko train karo: fake data D ko dikhao aur target 1 rakho (G chahta hai D use asli samjhe). Is waqt D ke weights nahi badalte , sirf G ke.
D ka loss:  -[ log D(asli)  +  log(1 - D(G(z))) ]       <- D ise kam karna chahta hai
G ka loss:  -log D(G(z))                                  <- G ise kam karna chahta hai
(non-saturating)
28.3 NumPy me asli chhota GAN (1D)
GAN ki jaan samajhne ke liye hum sab se saada GAN banate hain, jis ka data sirf ek number hai. Asli data: Normal distribution (mean = 4, std = 1.25). Generator:
x = a*z + b
(do parameters), jahan z standard normal noise hai. Discriminator: ek chhota logistic model jo x aur x^2 dekhta hai. G ko seekhna hai ke a = 1.25 aur b = 4 hone chahiye, magar usay ye kabhi bataya nahi jata , wo sirf D ke ishare se seekhta hai.
import numpy as np
import matplotlib.pyplot as plt
def sigmoid(s):
    return 1 / (1 + np.exp(-s))
def feats(x):
    return np.stack([x, x ** 2], axis=1)      # D ke features
rng = np.random.RandomState(0)
REAL_MEAN, REAL_STD = 4.0, 1.25
a, b = 1.0, 0.0                    # Generator:
x = a*z + b   (shuru me bura)
w, c = np.zeros(2), 0.0            # Discriminator:
D(x) = sigmoid(w . [x, x^2] + c)
lr_d, lr_g, batch = 0.05, 0.02, 64
history = []
for step in range(6000):
    # ---------- 1) Discriminator ko train karo ----------
    real = rng.normal(REAL_MEAN, REAL_STD, batch)
    fake = a * rng.randn(batch) + b
    D_real, D_fake = sigmoid(feats(real) @ w + c), sigmoid(feats(fake) @ w + c)
    grad_w = ((D_real - 1)[:, None] * feats(real)).mean(axis=0) + (D_fake[:, None] *
    feats(fake)).mean(axis=0)
    grad_c = (D_real - 1).mean() + D_fake.mean()
    w -= lr_d * grad_w
    c -= lr_d * grad_c
    # ---------- 2) Generator ko train karo (D ke weights band) ----------
    z = rng.randn(batch)
    fake = a * z + b
    D_fake = sigmoid(feats(fake) @ w + c)
    dL_dx = -(1 - D_fake) * (w[0] + 2 * w[1] * fake)       # -log D(G(z)) ka gradient
    a -= lr_g * (dL_dx * z).mean()
    b -= lr_g * dL_dx.mean()
    history.append((a, b))
    history = np.array(history)
    last = history[-1000:]
    print("Asli data      : mean =", REAL_MEAN, " std =", REAL_STD)
    print("Aakhri 1000 qadam me G ka (a, b) ka average:", last.mean(axis=0).round(2))
    gen = history[-1, 0] * rng.randn(10000) + history[-1, 1]
    print("Generator ke 10000 samples: mean =", gen.mean().round(2), " std =",
    gen.std().round(2))
OUTPUT
Asli data      : mean = 4.0  std = 1.25
Aakhri 1000 qadam me G ka (a, b) ka average: [1.28 3.38]
Generator ke 10000 samples: mean = 3.86  std = 1.03
G ne bina asli parameters dekhe sirf D ke ishare se data banana seekh liya: generated data ka mean taqreeban 3.9 (asal 4) aur std taqreeban 1.0 (asal 1.25) aaya. Mukammal nahi, magar asli ke qareeb. Dekhte hain ke training ke dauran a aur b ne kaise safar kiya, aur aakhir me generated aur asli data ki shakal:
fig, axes = plt.subplots(1, 2, figsize=(10, 3.6))
axes[0].plot(history[:, 1], color="#6B5B95", lw=1, label="b (mean)")
axes[0].plot(history[:, 0], color="#A4457A", lw=1, label="a (std)")
axes[0].axhline(REAL_MEAN, color="#6B5B95", ls=":")
axes[0].axhline(REAL_STD,
color="#A4457A", ls=":")
axes[0].set_xlabel("training step")
axes[0].set_title("G ke parameters (dotted = asli
qeemat)")
axes[0].legend()
real = rng.normal(REAL_MEAN, REAL_STD, 10000)
axes[1].hist(real, bins=50, density=True, alpha=0.6, color="gray", label="Asli data")
axes[1].hist(gen, bins=50, density=True, alpha=0.6, color="#A4457A", label="Generator ka
data")
axes[1].set_title("Training ke baad")
axes[1].legend()
plt.tight_layout()
plt.show()
OUTPUT (chart)
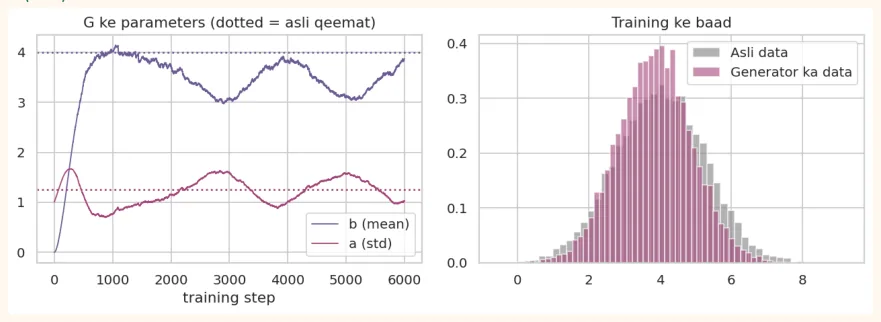
Ek ahem baat nazar aati hai: G ke parameters seedhe asli qeemat par ja kar rukte nahi , balki uske ird gird ghoomte (oscillate) rehte hain. Ye GAN training ki asli fitrat hai: do networks ek minimax khel khel rahe hain, jahan ek ka fayda doosre ka nuqsan hai, isi liye GAN ki training mushkil aur beqarar hoti hai.
28.4 GAN ke masail
| Masla | Matlab | Aam hal |
|---|---|---|
| Mode collapse | G sirfek ya chand qismka data banata hai (maslan sirf digit 1) kyun ke D ko wohi bewaqoof bana raha hai | Minibatch features, WGAN loss, zyada diverse data |
| Unstable training | Loss uchhalte hain, kabhi D bohat tez, kabhi G | Dono ka learning rate chhota (2e-4), Adam beta1 = 0.5, label smoothing |
| Vanishing gradient for G | D bohat tez ho jaye to G ko seekhne ka signal nahi milta | Non-saturating loss, D ko G se bohat zyada na seekhne do |
| Parakhna mushkil | Accuracy jaisa koi saaf number nahi | Samples dekho, FID score |
SUNEHRA USOOL
-
Adam(2e-4, beta_1=0.5) dono ke liye.
-
LeakyReLU hidden layers me (ReLU nahi), Generator ke aakhir me sigmoid ya tanh .
-
Label smoothing: asli ke target 1.0 ke bajaye 0.9.
-
Har kuch epochs par samples ki tasveer save karo aur khud dekho.
28.5 Keras me GAN ka dhancha
Hum Digits (8x8 = 64 pixels, 0 se 1) ke liye ek chhota GAN banate hain. Generator 32 numbers ke noise se 64 pixels banata hai, Discriminator 64 pixels dekh kar asli/nakli ka faisla deta hai.
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers
latent_dim = 32
generator = keras.Sequential([
keras.Input(shape=(latent_dim,)),
layers.Dense(128), layers.LeakyReLU(0.2),
layers.Dense(64, activation="sigmoid"),          # 64 pixels, 0 se 1
], name="generator")
discriminator = keras.Sequential([
keras.Input(shape=(64,)),
layers.Dense(128), layers.LeakyReLU(0.2),
layers.Dropout(0.3),
layers.Dense(1, activation="sigmoid"),           # asli (1) ya nakli (0)
], name="discriminator")
generator.summary()
discriminator.summary()
OUTPUT (namoona)
Model: "generator"
| Layer (type) | Output shape | Param # |
|---|---|---|
| dense (Dense) | (None, 128) | 4,224 |
| leaky_re_lu (LeakyReLU) | (None, 128) | 0 |
| dense_1 (Dense) | (None, 64) | 8,256 |
| Total params | 12,480 (48.75 KB) | |
| Trainable params | 12,480 (48.75 KB) | |
| Non-trainable params | 0 (0.00 B) |
Model: "discriminator"
| Layer (type) | Output shape | Param # |
|---|---|---|
| dense_2 (Dense) | (None, 128) | 8,320 |
| leaky_re_lu_1 (LeakyReLU) | (None, 128) | 0 |
| dropout (Dropout) | (None, 128) | 0 |
| dense_3 (Dense) | (None, 1) | 129 |
| Total params | 8,449 (33.00 KB) | |
| Trainable params | 8,449 (33.00 KB) | |
| Non-trainable params | 0 (0.00 B) |
28.6 Doosre generative models
| Model | Idea | Fayda | Nuqsan |
|---|---|---|---|
| VAE | Encoder-decoder, code ek distribution | Training stable, latent space saaf | Samples aksar dhundle |
| GAN | G aur D ka muqabla | Tez, tez-o-saaf samples | Training mushkil, mode collapse |
| Diffusion | Noise se shuru kar ke qadam ba qadam saaf karna | Behtareen quality aur variety (aaj ke tasveer-banane wale AI) | Sample banana dheema |
| LLM (Transformer) | Agla lafz predict karna (Module 6) | Text, code, aur bohat kuch | Bohat bara compute |
Aaj ke tasveer banane wale tools aksar diffusion models par bane hain, aur text ke liye Transformers/LLMs (hamara agla module). GANs ka idea magar hamesha ahem raha: do networks ka muqabla aur adversarial training, jo security, robustness aur data banane me ab bhi kaam aata hai.
28.7 Capstone Mini Project: Haath se likhe number pehchanne wala system
Ye Module 5 ka mini project hai, jo ek mukammal data science project ka poora dhancha dikhata hai. Maqsad: tasveer se digit pehchanna aur poora kaam ek professional tareeqe se karna: problem, data, baseline, model, tuning, evaluation, error analysis, save, aur report.
| Marhala | Kya karna hai | Chapter |
|---|---|---|
| 1. Problem statement | Maqsad aur success metric tay karo (maslan accuracy >= 97%) | Module 1 |
| 2. Data samajhna (EDA) | Shape, classes ki ginti, tasveerein dekho | Chapter 23 |
| 3. Tayyari | Train/validation/test, scaling | Chapter 22 |
| 4. Baselines | Saade models (Logistic, Random Forest, SVM) | Module 4 |
| 5. Neural Network / CNN | ANN, phir CNN, regularization, callbacks | Chapter 21 se 24 |
| 6. Evaluation | Test accuracy, confusion matrix, error analysis | Chapter 24 |
| 7. Save aur predict function | Model save, naye data par prediction | Chapter 24 |
| 8. Report | Nateeje, ghaltiyan, aage ka kaam | Neeche |
Marhala 1 se 3: Problem, data aur tayyari
Problem statement:
"8x8 greyscale tasveer se digit (0 se 9) pehchanne wala model banana.
 Success metric: test accuracy >= 97%, aur har class ka recall >= 90%."
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
digits = load_digits()
X, y = digits.data / 16.0, digits.target
print("Tasveerein:", X.shape[0], "| Pixels:", X.shape[1], "| Classes:", len(np.unique(y)))
print("Har class ki ginti:", np.bincount(y))
# Train 60% / Validation 20% / Test 20%
X_tr, X_tmp, y_tr, y_tmp = train_test_split(X, y, test_size=0.4, random_state=42,
stratify=y)
X_val, X_te, y_val, y_te = train_test_split(X_tmp, y_tmp, test_size=0.5, random_state=42,
stratify=y_tmp)
print("Train:", X_tr.shape, " Validation:", X_val.shape, " Test:", X_te.shape)
fig, axes = plt.subplots(2, 10, figsize=(10, 2.4))
for d in range(10):
    for r in range(2):
        axes[r, d].imshow(digits.images[np.where(y == d)[0][r]], cmap="gray_r",
interpolation="nearest")
        axes[r, d].axis("off")
    axes[0, d].set_title(str(d), fontsize=9)
plt.tight_layout()
plt.show()
OUTPUT
Tasveerein: 1797 | Pixels: 64 | Classes: 10
Har class ki ginti: [178 182 177 183 181 182 181 179 174 180]
Train: (1078, 64)  Validation: (359, 64)  Test: (360, 64)
OUTPUT (chart)
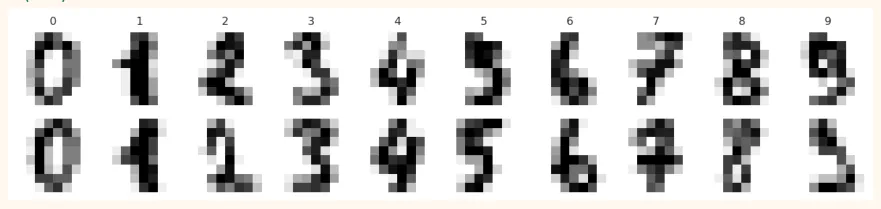
Test set ko abhi se alag kar liya. Isay sirf aakhir me ek baar istemal karenge. Model chunne ke liye validation set hai.
Marhala 4 aur 5: Baseline se neural network tak
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.neural_network import MLPClassifier
candidates = {
"Logistic Regression": LogisticRegression(max_iter=3000),
"Random Forest": RandomForestClassifier(n_estimators=200, random_state=0),
"SVM (RBF)": SVC(),
"Neural Net (64,)": MLPClassifier(hidden_layer_sizes=(64,), max_iter=500,
random_state=0),
"Neural Net (128,64) + early stop": MLPClassifier(hidden_layer_sizes=(128, 64),
early_stopping=True,
n_iter_no_change=10, max_iter=500,
random_state=0),
}
print("Model".ljust(34), "Train acc   Validation acc")
results = {}
for name, m in candidates.items():
    m.fit(X_tr, y_tr)
    results[name] = m
    print(name.ljust(34), str(round(m.score(X_tr, y_tr), 3)).ljust(11), round(m.score(X_val,
    y_val), 3))
OUTPUT
Model                              Train acc   Validation acc
Logistic Regression                0.985       0.958
Random Forest                      1.0         0.972
SVM (RBF)                          0.998       0.986
Neural Net (64,)                   1.0         0.972
Neural Net (128,64) + early stop   0.987       0.961
Is table se validation accuracy dekh kar model chuno (test se nahi!). Train aur validation accuracy ka bara farq overfitting ki nishani hai (Chapter 22).
best_name = max(results, key=lambda n: results[n].score(X_val, y_val))
best = results[best_name]
print("Validation par behtareen model:", best_name)
from sklearn.metrics import classification_report, confusion_matrix
import seaborn as sns
pred = best.predict(X_te)                       # test set ka PEHLA aur AAKHRI istemal
print("Test accuracy:", round((pred == y_te).mean(), 3))
print()
print(classification_report(y_te, pred, digits=3))
cm = confusion_matrix(y_te, pred)
fig, ax = plt.subplots(figsize=(5.6, 4.6))
sns.heatmap(cm, annot=True, fmt="d", cmap="Purples", cbar=False, ax=ax)
ax.set_xlabel("Predicted")
ax.set_ylabel("Asli")
ax.set_title("Test set: confusion
matrix")
plt.show()
OUTPUT
Validation par behtareen model: SVM (RBF)
Test accuracy: 0.986
precision recall f1-score support |
|---|
0 1.000 0.971 0.986 35 |
1 0.974 1.000 0.987 37 |
2 1.000 1.000 1.000 35 |
3 1.000 1.000 1.000 37 |
4 0.973 1.000 0.986 36 |
5 1.000 1.000 1.000 37 |
6 1.000 1.000 1.000 36 |
7 0.923 1.000 0.960 36 |
8 1.000 0.971 0.986 35 |
9 1.000 0.917 0.957 36 |
accuracy 0.986 360 |
macro avg 0.987 0.986 0.986 360 |
weighted avg 0.987 0.986 0.986 360 |
OUTPUT (chart)
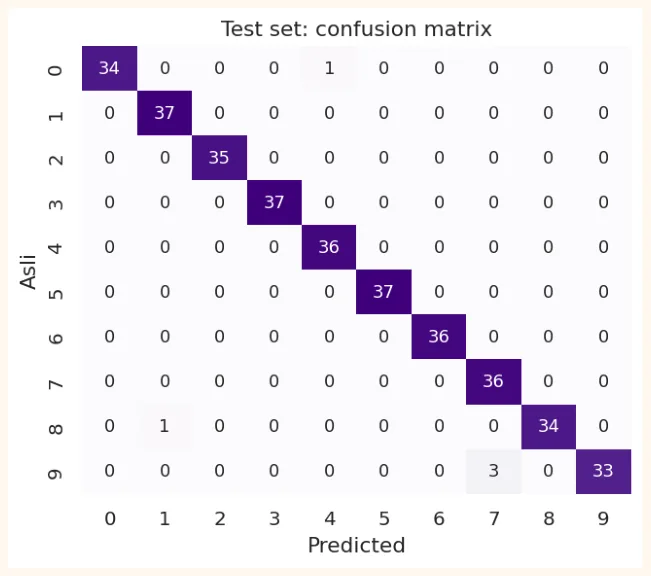
Ye nateeja humare success metric (accuracy 97% aur har class ka recall 90%) se milaya jata hai. Is run me test accuracy 98.6% aur sab se kam recall (digit 9) 91.7% hai, yani dono shartein poori hain. Agar pura na ho to error analysis karo (Chapter 24: ghalat tasveerein dekho) aur model/data behtar banao.
Marhala 5 (jari): Final CNN ka Keras code (Colab)
Neeche ka CNN wohi hai jo Chapter 23 me seekha, bas Dropout, callbacks aur augmentation ke saath mukammal project ki shakal me:
import numpy as np
from tensorflow import keras
from tensorflow.keras import layers, callbacks
X_tr_img = X_tr.reshape(-1, 8, 8, 1)
X_val_img = X_val.reshape(-1, 8, 8, 1)
X_te_img = X_te.reshape(-1, 8, 8, 1)
cnn = keras.Sequential([
keras.Input(shape=(8, 8, 1)),
layers.RandomTranslation(0.1, 0.1),                  # augmentation (sirf training me)
layers.Conv2D(16, 3, padding="same", activation="relu"),
layers.BatchNormalization(),
layers.MaxPooling2D(),
layers.Conv2D(32, 3, padding="same", activation="relu"),
layers.MaxPooling2D(),
layers.Flatten(),
layers.Dropout(0.3),
layers.Dense(64, activation="relu"),
layers.Dense(10, activation="softmax"),
])
cnn.compile(optimizer=keras.optimizers.Adam(1e-3),
loss="sparse_categorical_crossentropy", metrics=["accuracy"])
cb = [callbacks.EarlyStopping(patience=12, restore_best_weights=True),
callbacks.ReduceLROnPlateau(factor=0.5, patience=5),
callbacks.ModelCheckpoint("best_digits_cnn.keras", save_best_only=True)]
history = cnn.fit(X_tr_img, y_tr, validation_data=(X_val_img, y_val),
epochs=200, batch_size=32, callbacks=cb, verbose=0)
test_loss, test_acc = cnn.evaluate(X_te_img, y_te, verbose=0)    # test sirf ab, ek baar
print("CNN test accuracy:", round(test_acc, 3))
Is cell ko Colab me chalao, apni test accuracy likho aur upar ke sklearn model se muqabla karo. Dono nateeje apne report me likhna (jo behtar ho wo final model, magar dono ka zikr zaroori hai).
Marhala 7: Save aur predict function
model = keras.models.load_model("best_digits_cnn.keras")
def predict_digit(image_8x8):
    """image_8x8: 8x8 numpy array, pixels 0 se 16"""
    x = (np.asarray(image_8x8, dtype="float32") / 16.0).reshape(1, 8, 8, 1)   # training wala preprocessing
    probs = model.predict(x, verbose=0)[0]
    return {"digit": int(probs.argmax()), "confidence": round(float(probs.max()), 3)}
print(predict_digit(digits.images[0]))
28.8 Project Report aur Marking Rubric
Project ki report me ye hissay hone chahiyen:
-
Title aur maqsad: masla kya hai, kyun ahem hai.
-
Data ka tarruf: ginti, shape, classes, kuch tasveerein.
-
Tareeqa: preprocessing, split (60/20/20), models jo aazmaye.
-
Nateeje: validation aur test accuracy ka table, confusion matrix, chart.
-
Error analysis: model kahan ghalti karta hai aur kyun.
-
Natija aur aage ka kaam: kya seekha, kya behtar ho sakta hai (zyada data, augmentation, Transfer Learning).
-
Ethics aur hadd: model kahan kaam nahi karega (maslan alag likhai, bari tasveeren).
| Hissa | Number |
|---|---|
| Problem aur data ki samajh | 10 |
| Preprocessing aur sahi split (leakage nahi) | 15 |
| Baseline aur model muqabla | 20 |
| Neural network / CNN ki kaarkardagi | 20 |
| Evaluation aur error analysis | 20 |
| Code ki safai aur report ki wazahat | 15 |
| Kul | 100 |
28.9 Module 5 ka Mukhtasar
| Chapter | Seekha |
|---|---|
| 21 | Neuron, activation, loss, backpropagation, Keras ke 5 steps |
| Chapter | Seekha |
|---|---|
| 22 | Overfitting ka ilaaj (Dropout, L2, Early Stopping, BatchNorm), initialization, optimizers |
| 23 | CNN: convolution, pooling, parameters ki ginti |
| 24 | ResNet, MobileNet ke idea, Transfer Learning, image project |
| 25 | RNN, LSTM, GRU, text ko numbers me badalna |
| 26 | Time series: baselines, windowing, differencing, walk-forward validation |
| 27 | Autoencoder, PCA se muqabla, denoising, anomaly detection |
| 28 | GAN, generative models, capstone mini project |
Module 6 me tum Transformers aur Attention seekhogi, jin par ChatGPT jaise LLMs bane hain, aur phir OpenAI API se khud AI applications banaogi.
28.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
GAN me sirf loss dekhna. Samples ko khud dekho.
-
Discriminator ko Generator se bohat taqatwar bana dena (G ko seekhne ka signal nahi milta).
-
Test set par model chunna (validation istemal karo).
-
Preprocessing ka training aur prediction me farq.
-
Project me sirf accuracy likhna, error analysis aur hadood ka zikr na karna.
-
Generated/nakli content ko asli bata kar share karna.
Hands-on
-
NumPy GAN: asli data ka mean 4 se 8 aur std 1.25 se 2 karo; G ke (a, b) ko dobara dekho.
-
Learning rate:
lr_gko 0.002 aur 0.2 karo aur training ka farq likho. -
Generated samples: Colab me Keras GAN train kar ke har 50 epoch par 16 samples ki tasveer banao.
-
Capstone: upar ke project me ek aur model (maslan KNN ya Gradient Boosting) jodo aur validation table update karo.
-
Report: is project ki 2 safhe ki report rubric ke hisaab se likho.
KEY TAKEAWAYS
-
Generative models naya data banate hain; discriminative models pehchante ya andaza lagate hain.
-
GAN: Generator (nakli banata hai) aur Discriminator (asli/nakli pehchanta hai) ek doosre se muqabla kar ke behtar hote hain.
-
G ko non-saturating loss (-log D(G(z))) se train karte hain; training me dono ko baari baari update karte hain.
-
GAN training beqarar hoti hai (oscillation, mode collapse); loss se nahi, samples dekh kar parakho.
-
Adam(2e-4, beta1=0.5), LeakyReLU, label smoothing GAN ke aam nuskhe hain.
-
Diffusion aur LLM aaj ke bade generative models hain; VAE aur GAN ne rasta banaya.
-
Capstone ka dhancha: problem, EDA, split, baselines, model, evaluation, error analysis, save, report.
-
Test set sirf aakhir me ek baar; model validation set se chuno.
-
Deepfake jaisi cheezon me ethics aur ijazat ka khayal rakho.