Chapter 26: Time Series Forecasting
MODULE 5 | WEEK 26
Chapter 26: Time Series Forecasting
Time series woh data hai jo waqt ke saath record hota hai: rozana ki sales, mahine ki bijli ki khapat, ghante ka mausam, share ki qeemat. Business me sab se zyada poocha jane wala sawal hai: "Aane wale waqt me kya hoga?" Is chapter me hum forecasting ke asli usool seekhenge: waqt ki tarteeb ko kabhi na todna, baseline banana, windowing se time series ko supervised learning me badalna, aur phir ML aur LSTM/GRU se forecast karna.
26.1 Time Series kya hai?
Time series me har observation ke saath waqt juda hota hai aur qareeb ke observations aapas me jude hote hain (aaj ki sales kal ki sales se milti hai). Isi liye aam ML ke qaidey (random shuffle) yahan nahi chalte.
Hum ek banawati (synthetic) magar haqeeqat se milti hui series banate hain: 10 saal (120 mahine) ki dukan ki sales, jis me barhta hua rujhan (trend) , saalana mausam ka asar (seasonality) aur thora shor (noise) hai. Banawati data ka fayda ye hai ke hume pata hai andar kya chhupa hai.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
rng = np.random.RandomState(42)
months = pd.date_range("2015-01-01", periods=120, freq="MS")    # har mahine ki pehli tareekh
t = np.arange(120)
trend = 100 + 0.8 * t                          # har mahine thori barhti hui
season = 15 * np.sin(2 * np.pi * t / 12)       # 12 mahine me ek chakkar
noise = rng.normal(0, 3, 120)
sales = trend + season + noise
ts = pd.Series(sales, index=months, name="sales")
print(ts.head(4).round(1))
print("Kul mahine:", len(ts), "| Min:", ts.min().round(1), "| Max:", ts.max().round(1))
fig, ax = plt.subplots(figsize=(10, 3.6))
ax.plot(ts, color="#6B5B95", lw=1.8)
ax.set_title("Mahana sales (banawati data): trend + seasonality + noise")
ax.set_ylabel("sales")
plt.show()
OUTPUT 2015-01-01 101.5
2015-02-01    107.9
2015-03-01    116.5
2015-04-01    122.0
Freq: MS, Name: sales, dtype: float64
Kul mahine: 120 | Min: 92.0 | Max: 205.3
OUTPUT (chart)
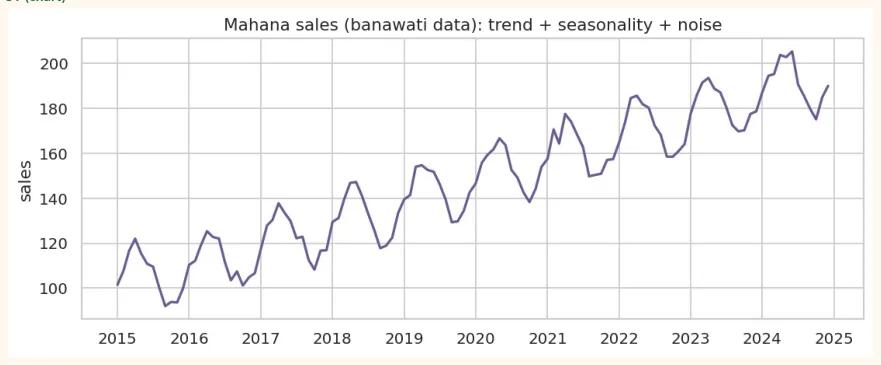
| Hissa | Matlab | Is series me |
|---|---|---|
| Trend | Lambay arse me upar ya neeche ka rujhan | Har mahine +0.8 ka izafa |
| Seasonality | Dohrane wala mausami nizam | Har 12 mahine baad wohi shakal |
| Noise | Be-tarteeb chhote utaar chadhao | Random shor (std = 3) |
Asli series se in hisson ko alag karna ( decomposition ) sab se pehla qadam hai:
trend_est = ts.rolling(window=12, center=True).mean()          # 12 mahine ka
average =
trend
detrended = ts - trend_est
season_est = detrended.groupby(detrended.index.month).mean()     # har mahine ka aam asar
print("Har mahine ka seasonal asar (pehle 6 mahine):")
print(season_est.round(1).head(6))
print("Sab se zyada asar wala mahina:", int(season_est.idxmax()), " | sab se kam:",
int(season_est.idxmin()))
fig, axes = plt.subplots(1, 3, figsize=(10, 2.8))
axes[0].plot(ts.index, trend_est, color="#6B5B95")
axes[0].set_title("Trend")
axes[1].bar(season_est.index, season_est.values, color="#A4457A")
axes[1].set_title("Seasonality (mahine ke hisaab se)")
axes[2].plot(ts.index, (detrended - detrended.index.month.map(season_est)), color="#2F7D4F",
lw=1)
axes[2].set_title("Bacha hua (noise)")
plt.tight_layout()
plt.show()
OUTPUT
Har mahine ka seasonal asar (pehle 6 mahine):
1     0.6
2     6.8
3    10.9
4    15.6
5    13.0
6     9.8
Name: sales, dtype: float64
Sab se zyada asar wala mahina: 4  | sab se kam: 10
OUTPUT (chart)
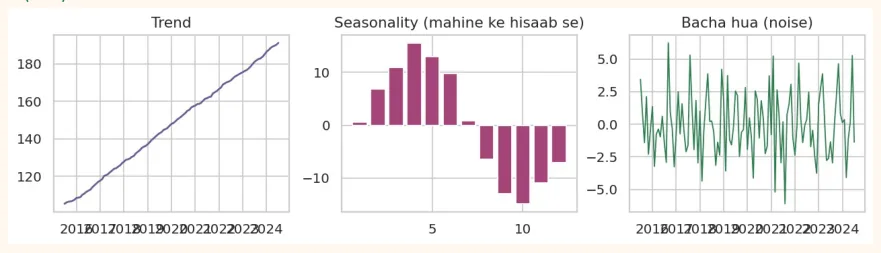
26.2 Forecasting ke sunehre usool
SUNEHRA USOOL
-
Kabhi shuffle nahi. Train/test split hamesha waqt ke hisaab se : purana data train, naya data test.
-
Mustaqbil ka data kabhi training me nahi. Scaler ko bhi sirf train par fit karo.
-
Pehle baseline. Agar tumhara model "kal jitni sales aaj bhi hongi" se behtar nahi, to wo bekar hai.
-
Har feature ke baare me poocho: kya ye prediction ke waqt maloom hoga?
test_size = 24                                  # aakhri 2 saal test
train, test = ts[:-test_size], ts[-test_size:]
print("Train:", train.index[0].strftime("%Y-%m"), "se", train.index[-1].strftime("%Y-%m"),
"(", len(train), "mahine )")
print("Test :", test.index[0].strftime("%Y-%m"), "se", test.index[-1].strftime("%Y-%m"),
"(", len(test), "mahine )")
OUTPUT
Train: 2015-01 se 2022-12 ( 96 mahine )
Test : 2023-01 se 2024-12 ( 24 mahine )
26.3 Baseline models aur Metrics
| Baseline | Idea |
|---|---|
| Naive | Agle mahine ki sales = pichle mahine ki sales |
| Seasonal Naive | Agle mahine ki sales =pichle saal usi mahineki sales |
| Moving Average | Pichle 12 mahine ka average |
| Metric | Formula (mukhtasar) | Matlab |
|---|---|---|
| MAE | Aam (|asli - andaza|) | Average galti, wohi unit jo data ka |
| RMSE | sqrt(aam((asli - andaza)^2)) | Bari ghaltiyon ko zyada saza |
| MAPE | Aam(|asli - andaza| / |asli|) x 100 | Percent me galti (asli 0 ke qareeb ho to ghalat) |
def metrics(y_true, y_pred):
    y_true, y_pred = np.asarray(y_true), np.asarray(y_pred)
    mae = np.mean(np.abs(y_true - y_pred))
    rmse = np.sqrt(np.mean((y_true - y_pred) ** 2))
    mape = np.mean(np.abs((y_true - y_pred) / y_true)) * 100
    return round(mae, 2), round(rmse, 2), round(mape, 2)
full = ts.values
n_tr = len(train)
y_test = test.values
# One-step baselines:
har test mahine ke liye pichli ASLI values istemal hoti hain
naive = full[n_tr - 1:-1]                                  # pichla mahina
seasonal_naive = full[n_tr - 12:-12]                       # 12 mahine pehle
moving_avg = np.array([full[i - 12:i].mean() for i in range(n_tr, len(full))])
print("Baseline".ljust(16), "MAE    RMSE   MAPE%")
for name, pred in [("Naive", naive), ("Seasonal naive", seasonal_naive), ("Moving avg (12)",
moving_avg)]:
print(name.ljust(16), *metrics(y_test, pred))
OUTPUT
Baseline         MAE    RMSE   MAPE%
Naive            5.65 6.78 3.05
Seasonal naive   10.03 10.67 5.39
Moving avg (12)  9.8 11.77 5.16
Ye numbers hamari muqabla ki line hain. Koi bhi model jo in se behtar na ho, uski zaroorat nahi.
26.4 Windowing: time series ko supervised learning me badalna
ML model ko (X, y) chahiye. Time series me hum pichle window qadam ko X aur agle qadam ko y bana lete hain. Is tareeqe ko sliding window kehte hain.
Series:  10, 12, 11, 14, 15, 17, 16
window = 3
X (pichle 3)      y (agla)
[10, 12, 11]  ->  14
[12, 11, 14]  ->  15
[11, 14, 15]  ->  17
[14, 15, 17]  ->  16
def make_windows(values, window):
    X, y = [], []
    for i in range(window, len(values)):
        X.append(values[i - window:i])
        y.append(values[i])
    return np.array(X), np.array(y)
demo = np.array([10, 12, 11, 14, 15, 17, 16], dtype=float)
Xd, yd = make_windows(demo, 3)
print(Xd)
print("y:", yd)
print("X shape:", Xd.shape, " y shape:", yd.shape)
OUTPUT
[[10. 12. 11.]
 [12. 11. 14.]
 [11. 14. 15.]
 [14. 15. 17.]]
y: [14. 15. 17. 16.]
X shape: (4, 3)  y shape: (4,)
RNN/LSTM/GRU ko input 3D chahiye: (samples, timesteps, features) . Humari series me sirf 1 feature (sales) hai:
Xd3 = Xd.reshape(Xd.shape[0], Xd.shape[1], 1)
print("RNN ke liye shape:", Xd3.shape, "-> (samples, timesteps, features)")
OUTPUT
RNN ke liye shape: (4, 3, 1) -> (samples, timesteps, features)
26.5 Scaling aur poori tayyari
Neural networks ko scaled data chahiye. Scaler sirf train par fit hoga (warna mustaqbil ki maloomat leak hogi):
from sklearn.preprocessing import MinMaxScaler
window = 12
scaler = MinMaxScaler().fit(train.values.reshape(-1, 1))            # sirf train par
scaled = scaler.transform(ts.values.reshape(-1, 1)).ravel()
X_all, y_all = make_windows(scaled, window)
# window ka target wohi mahina hai jo index (window + i) par hai
target_idx = np.arange(window, len(scaled))
is_test = target_idx >= n_tr                       # jin ka target test period me ho
X_tr, y_tr = X_all[~is_test], y_all[~is_test]
X_te, y_te = X_all[is_test], y_all[is_test]
print("Train windows:", X_tr.shape, " Test windows:", X_te.shape)
print("Scaled train range:", scaled[:n_tr].min().round(2), "se",
scaled[:n_tr].max().round(2))
print("Scaled test range :", scaled[n_tr:].min().round(2), "se",
scaled[n_tr:].max().round(2))
OUTPUT
Train windows: (84, 12)  Test windows: (24, 12)
Scaled train range: 0.0 se 1.0
Scaled test range : 0.83 se 1.21
26.6 ML aur Neural Network se forecast
Teen models: Ridge Regression (linear), Random Forest , aur ek chhota neural network (MLPRegressor, asli neural net). Teeno ko wohi 12 pichle mahine dete hain:
from sklearn.linear_model import Ridge
from sklearn.ensemble import RandomForestRegressor
from sklearn.neural_network import MLPRegressor
import warnings
warnings.filterwarnings("ignore")
models = {
"Ridge": Ridge(alpha=0.1),
"Random Forest": RandomForestRegressor(n_estimators=200, random_state=0),
"Neural Net (MLP)": MLPRegressor(hidden_layer_sizes=(32, 16), max_iter=3000,
random_state=0),
}
preds = {}
print("Model".ljust(18), "MAE    RMSE   MAPE%")
for name, m in models.items():
    m.fit(X_tr, y_tr)
    p_scaled = m.predict(X_te)
    p = scaler.inverse_transform(p_scaled.reshape(-1, 1)).ravel()   # wapas asli unit me
    preds[name] = p
    print(name.ljust(18), *metrics(y_test, p))
OUTPUT
Model              MAE    RMSE   MAPE%
Ridge              2.62 3.42 1.4
Random Forest      7.76 9.95 4.04
Neural Net (MLP)   8.59 10.08 4.67
fig, ax = plt.subplots(figsize=(10, 3.8))
ax.plot(train.index[-36:], train.values[-36:], color="gray", lw=1.5, label="Train (aakhri 3
saal)")
ax.plot(test.index, y_test, color="black", lw=2, label="Asli (test)")
cols = {"Ridge": "#6B5B95", "Random Forest": "#B7791F", "Neural Net (MLP)": "#A4457A"}
for name, p in preds.items():
    ax.plot(test.index, p, color=cols[name], lw=1.6, ls="--", label=name)
ax.set_title("One-step forecast: test period")
ax.legend(ncol=2, fontsize=8)
plt.show()
OUTPUT (chart)
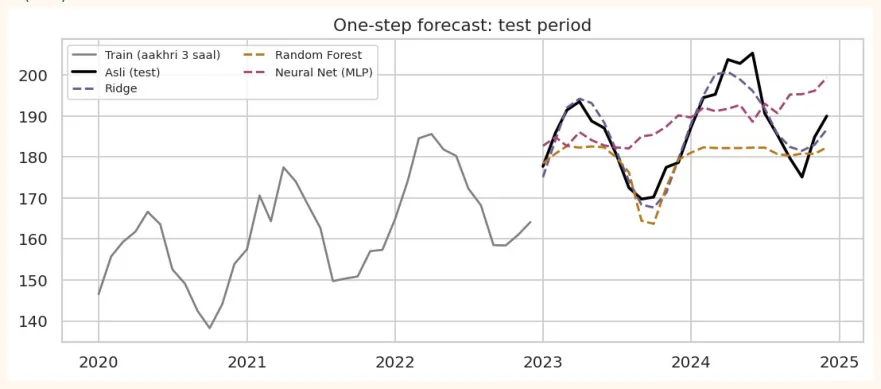
Dekho ke Ridge (linear) sab se behtar aaya, aur Random Forest aur Neural Net dono naive baseline se bhi peeche reh gaye. Wajah: Random Forest trees ke andar train me dekhi hui values ka average deta hai, is liye wo train ki sab se bari value se aage extrapolate nahi kar sakta ; neural net bhi train range ke bahar kamzor hota hai. Linear model trend ko seedha pakadta hai.
SUNEHRA USOOL
-
Trend wali series me tree-based models ko seedhi qeemat dene ke bajaye farq (difference) ya trend hata kar do.
-
Sab se saada aur taqatwar tareeqa: y(t) - y(t-1) (farq) predict karo, phir wapas jama karo.
Differencing: trend hata kar dobara aazmao
diff = np.diff(ts.values)                              # har mahine ka farq
d_tr_end = n_tr - 1                                    # diff me train ke itne elements
sc2 = MinMaxScaler().fit(diff[:d_tr_end].reshape(-1, 1))
d_scaled = sc2.transform(diff.reshape(-1, 1)).ravel()
Xd_all, yd_all = make_windows(d_scaled, window)
d_target_idx = np.arange(window, len(d_scaled))        # diff ke index
is_test_d = d_target_idx >= d_tr_end
Xd_tr, yd_tr = Xd_all[~is_test_d], yd_all[~is_test_d]
Xd_te, yd_te = Xd_all[is_test_d], yd_all[is_test_d]
print("Differenced train windows:", Xd_tr.shape, " test windows:", Xd_te.shape)
prev_values = full[n_tr - 1:-1]                         # pichli ASLI value (wapas jama
karne ke liye)
for name, m in [("Random Forest (diff)", RandomForestRegressor(n_estimators=200,
random_state=0)),
("Neural Net (diff)", MLPRegressor(hidden_layer_sizes=(32, 16),
max_iter=3000, random_state=0)),
("Ridge (diff)", Ridge(alpha=0.1))]:
m.fit(Xd_tr, yd_tr)
d_pred = sc2.inverse_transform(m.predict(Xd_te).reshape(-1, 1)).ravel()
p = prev_values + d_pred                            # pichli value + predicted farq
preds[name] = p
print(name.ljust(22), *metrics(y_test, p))
OUTPUT
Differenced train windows: (83, 12)  test windows: (24, 12)
Random Forest (diff)   3.42 4.14 1.83
Neural Net (diff)      3.36 4.71 1.8
Ridge (diff)           2.89 3.54 1.54
Differencing ke baad Random Forest aur Neural Net dono ka RMSE 10 ke aas paas se 4 ke aas paas aa gaya, kyun ke ab model ko trend nahi, sirf farq aur seasonality seekhni hai jo train range me dikh chuki hai. (Is series me Ridge phir bhi saada aur mazboot rehta hai.)
26.7 Multi-step forecast: kai mahine aage
Ab tak hum ne ek qadam aage (one-step) predict kiya aur har baar asli pichli values di. Asli zindagi me hume aksar kai mahine aage chahiye, jab ke asli values maloom nahi hoti. Recursive tareeqa: pehla forecast bana kar usay window me jod do aur agla banao.
rm = Ridge(alpha=0.1).fit(X_tr, y_tr)               # train windows par seekha hua model
history = list(scaled[:n_tr])                         # sirf train tak ka data maloom hai
forecast = []
for step in range(test_size):
    x = np.array(history[-window:]).reshape(1, -1)
    p = rm.predict(x)[0]
    forecast.append(p)
    history.append(p)                                 # khud ki prediction agle qadam ka input
    forecast = scaler.inverse_transform(np.array(forecast).reshape(-1, 1)).ravel()
    print("24 mahine ka recursive forecast (Ridge):", *metrics(y_test, forecast))
    print("Naive (aakhri value dohrao, muqabla)   :", *metrics(y_test, [full[n_tr - 1]] *
    test_size))
    fig, ax = plt.subplots(figsize=(10, 3.6))
    ax.plot(train.index[-36:], train.values[-36:], color="gray", lw=1.5, label="Train")
    ax.plot(test.index, y_test, color="black", lw=2, label="Asli")
    ax.plot(test.index, forecast, color="#A4457A", lw=2, ls="--", label="24 mahine ka forecast")
    ax.set_title("Multi-step (recursive) forecast")
    ax.legend()
    plt.show()
OUTPUT
24 mahine ka recursive forecast (Ridge): 2.48 3.17 1.33
Naive (aakhri value dohrao, muqabla)   : 22.04 24.15 11.59
OUTPUT (chart)
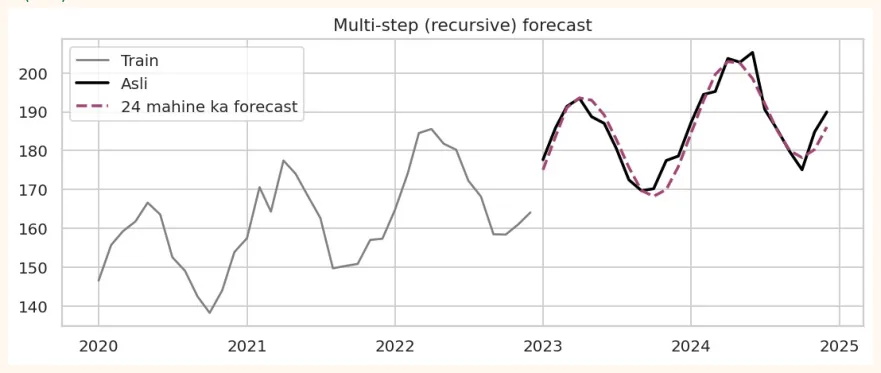
AAM GALTIYAN
-
Recursive me galti jama hoti hai: pehli prediction ki chhoti ghalti agle step ka input ban kar barhti jati hai. Jitna lamba forecast, utna kam bharosa.
-
Doosra tareeqa Direct : har ufuq (1 mahina, 2 mahine, ...) ke liye alag model. Ya ek model jo ek sath 24 outputs de.
26.8 Walk-forward Validation (TimeSeriesSplit)
Time series me K-Fold (shuffle) galat hai. Sahi tareeqa: purana data train, uske baad ka data validate , aur har baar train ko thora lamba karte jao.
from sklearn.model_selection import TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=4, test_size=12)
for k, (tr_idx, va_idx) in enumerate(tscv.split(X_tr), 1):
    m = Ridge(alpha=0.1).fit(X_tr[tr_idx], y_tr[tr_idx])
    p = m.predict(X_tr[va_idx])
    rmse = np.sqrt(np.mean((y_tr[va_idx] - p) ** 2))
    print("Fold", k, "| train:", tr_idx[0], "se", tr_idx[-1], "| validate:", va_idx[0],
    "se", va_idx[-1],
    "| RMSE (scaled):", round(rmse, 4))
OUTPUT
Fold 1 | train: 0 se 35 | validate: 36 se 47 | RMSE (scaled): 0.0302
Fold 2 | train: 0 se 47 | validate: 48 se 59 | RMSE (scaled): 0.0298
Fold 3 | train: 0 se 59 | validate: 60 se 71 | RMSE (scaled): 0.0437
Fold 4 | train: 0 se 71 | validate: 72 se 83 | RMSE (scaled): 0.0305
26.9 Keras me LSTM, GRU aur Conv1D forecasting
Ab wohi masla Keras me. Input shape (window, 1) . Data pichle section ka X_tr hi hai, bas ek feature ka axis jodna hai.
import numpy as np
from tensorflow import keras
from tensorflow.keras import layers
X_tr3 = X_tr.reshape(-1, 12, 1)          # (samples, 12 timesteps, 1 feature)
X_te3 = X_te.reshape(-1, 12, 1)
lstm_model = keras.Sequential([
keras.Input(shape=(12, 1)),
layers.LSTM(32),
layers.Dense(1),                     # regression: koi activation nahi
])
lstm_model.compile(optimizer="adam", loss="mse")
lstm_model.summary()
OUTPUT (namoona)
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃ Layer (type)                       Output Shape                      Param # ┃┃┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ lstm (LSTM)                       │ (None, 32)               │           4,352 │
│ dense (Dense)                     │ (None, 1)                │              33 │
└───────────────────────────────────┴──────────────────────────┴─────────────────┘
 Total params: 4,385 (17.13 KB)
 Trainable params: 4,385 (17.13 KB)
 Non-trainable params: 0 (0.00 B)
OUTPUT (namoona)
3393 161
26.10 Aam Galtiyan aur Hands-on
AAM GALTIYAN
-
Random train_test_split istemal karna. Hamesha waqt ke hisaab se split.
-
Scaler poore data par fit karna (mustaqbil ki maloomat leak).
-
Baseline ke baghair model ko "achha" kehna. Saada naive aksar tumhari soch se behtar nikalta hai (yahan Naive ne Seasonal naive ko haraya, kyun ke trend hai).
-
Scaled predictions par metric nikalna (inverse_transform bhoolna).
-
Trend wali series par Random Forest se seedha forecast.
-
Lamba recursive forecast par bharosa karna.
-
MAPE jab asli values 0 ke qareeb hon.
Hands-on
-
Series badlo: noise ka std 3 se 10 karo aur dekho kaun sa model sab se behtar rehta hai.
-
Window badlo: 6, 12, 24 aazmao aur RMSE ka muqabla likho.
-
Seasonality hatao: series me season wala hissa nikal do aur dekho baseline kaise badalti hai.
-
Apna data: apne ghar ki mahine ki bijli ka bill (ya koi bhi apna data) 24 mahine ka likh kar seasonal naive baseline banao.
-
Keras: Colab me LSTM, GRU aur Conv1D ke parameters, waqt aur RMSE ka table banao.
KEY TAKEAWAYS
-
Time series = trend + seasonality + noise. Tarteeb kabhi na todo; shuffle nahi.
-
Hamesha pehle baseline: naive, seasonal naive, moving average.
-
Metrics: MAE, RMSE, MAPE. Scaled values ko wapas asli unit me laa kar naapo.
-
Windowing se series ko (X, y) banao; RNN ke liye shape (samples, timesteps, features).
-
Scaler sirf train par fit. Test ka range train se bahar ho sakta hai.
-
Trend wali series me differencing se tree-based models bhi theek chalte hain.
-
Multi-step: recursive (galti jama hoti hai) ya direct.
-
Validation: TimeSeriesSplit / walk-forward, kabhi shuffled K-Fold nahi.