Chapter 12: Machine Learning ka Taruf
MODULE 4 | WEEK 12
Chapter 12: Machine Learning ka Taruf
Ab hum us jagah pohanch gaye jis ke liye ye poora safar tha: Machine Learning (ML) . Pichle modules me jo Python, Pandas, statistics aur regression seekha, wo sab yahan kaam aayega. Is chapter me ML ki bunyadi soch , iski qismein, scikit-learn ka tareeqa-e-kaar, aur model ko parakhne ke bunyadi usool seekhenge.
12.1 Machine Learning kya hai?
Machine Learning me hum computer ko rules likh kar nahi dete , balke examples (data) dete hain aur wo khud un examples me chhupe patterns seekh leta hai, jinhein wo naye data par istemal karta hai.
Bunyadi alfaz
| Lafz | Matlab | Misaal (ghar ki qeemat) |
|---|---|---|
| Sample / Row | Ek example | Ek ghar |
| Features (X) | Input columns jin se andaza lagana hai | Size, kamray, umar, shehar |
| Target / Label (y) | Jis ka andaza lagana hai | Ghar ki qeemat |
| Training | Model ka data se seekhna | model.fit(X_train, y_train) |
| Parameters | Jo modelkhud seekhta hai | Regression ke coefficients |
| Hyperparameters | Johum pehle se taykarte hain | Tree ki depth, KNN me k, regularization alpha |
| Prediction | Naye data par andaza | model.predict(X_new) |
12.2 ML ki qismein
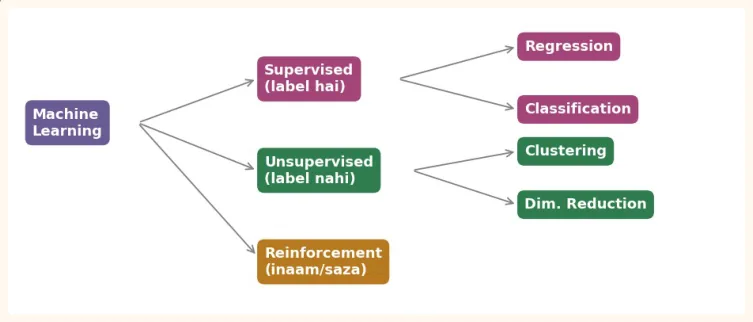
1) Supervised Learning (nigrani wali seekh)
Data ke saath jawab (label) bhi maujood hota hai. Model input se jawab tak ka rishta seekhta hai. Do kisam ke masail hain:
| Masla | Target kya hota hai | Misaal | Algorithms |
|---|---|---|---|
| Regression | Eknumber(continuous) | Ghar ki qeemat, kal ka temperature, sales | Linear Regression, Random Forest... |
| Classification | Ekcategory(class) | Spam ya not spam, bimari hai ya nahi, | Logistic Regression, Decision Tree, |
| Iris ka phool | SVM, KNN... |
2) Unsupervised Learning (baghair nigrani ke seekh)
Data me koi label nahi hota. Model khud data me chhupi sakht (structure) dhoondta hai.
-
Clustering: milti julti cheezon ke groups banana (customers ke groups). Chapter 16.
-
Dimensionality Reduction: columns kam karna magar maloomat bachana (PCA). Chapter 17.
-
Anomaly detection: ajeeb/anokhi cheezein dhoondna (fraud).
3) Reinforcement Learning (inaam aur saza se seekh)
Ek agent mahaul me action leta hai, aur uski kaarkardagi par reward (inaam) ya penalty (saza) milti hai. Agent waqt ke saath zyada reward wale actions seekhta hai. Misaal: game khelne wala AI, robot ka chalna seekhna. Is course me iski sirf pehchan hai.
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(9, 3.6))
ax.axis("off")
boxes = [
    (0.0, 0.55, "Machine\nLearning", "#6B5B95"),
    (0.33, 0.78, "Supervised\n(label hai)", "#A4457A"),
    (0.33, 0.30, "Unsupervised\n(label nahi)", "#2F7D4F"),
    (0.33, -0.18, "Reinforcement\n(inaam/saza)", "#B7791F"),
    (0.70, 0.95, "Regression", "#A4457A"),
    (0.70, 0.62, "Classification", "#A4457A"),
    (0.70, 0.40, "Clustering", "#2F7D4F"),
    (0.70, 0.12, "Dim. Reduction", "#2F7D4F"),
]
for x, y, t, c in boxes:
    ax.text(x, y, t, ha="left", va="center", fontsize=10, color="white", fontweight="bold",
            bbox=dict(boxstyle="round,pad=0.5", fc=c, ec="none"))
for src, dst in [((0.15, 0.55), (0.32, 0.78)), ((0.15, 0.55), (0.32, 0.30)), ((0.15, 0.55),
(0.32, -0.15)),
                 ((0.52, 0.78), (0.69, 0.95)), ((0.52, 0.78), (0.69, 0.62)),
                 ((0.54, 0.30), (0.69, 0.40)), ((0.54, 0.30), (0.69, 0.12))]:
    ax.annotate("", xy=dst, xytext=src, arrowprops=dict(arrowstyle="->", color="gray"))
ax.set_xlim(-0.02, 1.0)
ax.set_ylim(-0.4, 1.1)
plt.show()
OUTPUT (chart)
12.3 ML ka poora Workflow
Ye wohi Data Science Pipeline hai jo Chapter 1 me dekhi thi, ab ML ke nazariye se:
-
Problem tay karo: regression hai ya classification? Success ka paimana kya hoga?
-
Data jama karo aur samjho (EDA) .
-
Data saaf karo: missing values, duplicates, outliers.
-
Train/Test split karo (is se pehle koi "seekhne wala" step nahi!).
-
Preprocessing / Feature engineering: scaling, encoding, naye features.
-
Model chuno aur train karo.
-
Evaluate karo (test set par) aur behtar banao (hyperparameter tuning).
-
Deploy karo aur monitor karo.
12.4 scikit-learn ka tareeqa
scikit-learn (sklearn) Python ki sab se mashhoor ML library hai. Iski sab se khoobsurat baat: har algorithm ka interface ek jaisa hai . Ek bar seekh liya to koi bhi algorithm istemal kar sakti ho.
| Method | Kaam | Kab |
|---|---|---|
| model.fit(X, y) | Data se seekhna (training) | Har model par |
| model.predict(X) | Andaza lagana | Supervised models par |
| model.score(X, y) | Default metric (classification me accuracy, regression me R<sup>2</sup>) | Supervised models par |
| transformer.fit(X) | Data se kuch seekhna (jaise mean, std) | Scaler, Encoder, PCA |
| transformer.transform(X) | Seekhi hui cheez se data badalna | Scaler, Encoder, PCA |
| transformer.fit_transform(X) | Dono ek sath (sirf train data par) | Scaler, Encoder, PCA |
Sab se pehle ek classic dataset: Iris . 150 phoolon ki 4 napayi (petal/sepal ki lambai aur chorai) aur 3 species (setosa, versicolor, virginica). Sawal: napayi dekh kar species batao (classification).
import numpy as np
import pandas as pd
from sklearn.datasets import load_iris
iris = load_iris(as_frame=True)
X = iris.data                    # features (DataFrame)
y = iris.target                  # target (0, 1, 2)
print(X.shape, y.shape)
print(X.head(3))
print(iris.target_names)
print(y.value_counts())
OUTPUT
(150, 4) (150,)
   sepal length (cm)  sepal width (cm)  petal length (cm)  \
0                5.1               3.5                1.4
1                4.9               3.0                1.4
2                4.7               3.2                1.3
   petal width (cm)
0               0.2
1               0.2
2               0.2
['setosa' 'versicolor' 'virginica']
target
0    50
1    50
2    50
Name: count, dtype: int64
Pehla ML model: 5 lines me
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y)
model = KNeighborsClassifier()           # 1) model banao
model.fit(X_train, y_train)              # 2) seekhao
pred = model.predict(X_test)             # 3) andaza lagao
print("Pehle 5 andaze:", pred[:5])
print("Asli jawab    :", y_test.values[:5])
print("Accuracy:", round(model.score(X_test, y_test), 3))     # 4) parakho
OUTPUT
Pehle 5 andaze: [0 2 1 1 0]
Asli jawab    : [0 2 1 1 0]
Accuracy: 1.0
Model badal kar dekho: interface wohi
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
models = {
    "Logistic Regression": LogisticRegression(max_iter=1000),
    "Decision Tree": DecisionTreeClassifier(random_state=0),
    "Random Forest": RandomForestClassifier(random_state=0),
    "KNN": KNeighborsClassifier(),
}
for name, m in models.items():
    m.fit(X_train, y_train)
    print(f"{name:20s} accuracy: {m.score(X_test, y_test):.3f}")
OUTPUT
Logistic Regression  accuracy: 0.967
Decision Tree        accuracy: 0.967
Random Forest        accuracy: 0.933
KNN                  accuracy: 1.000
Dekho kaise sirf model ka naam badla aur baqi code wohi raha. Isi wajah se scikit-learn itni mashhoor hai.
12.5 Train/Test Split aur Data Leakage
Pichle module me dekha ke model ko usi data par parakhna dhoka hai. Test set wo "exam" hai jo model ne pehle kabhi nahi dekha. Ek bohat bari ghalti hai Data Leakage : test data ki maloomat chupke se training me aa jana .
Sab se aam leakage: scaling poore data par karna
from sklearn.preprocessing import StandardScaler
# GHALAT (leakage): poore data ka mean/std test se bhi leta hai
# scaler = StandardScaler().fit(X)           # <- test ki maloomat shamil
# SAHI: sirf train se seekho, test par sirf lagao
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)     # fit + transform (train)
X_test_s = scaler.transform(X_test)           # sirf transform (test)
print("Train mean (taqreeban 0):", X_train_s.mean(axis=0).round(2))
print("Test  mean (0 nahi hoga): ", X_test_s.mean(axis=0).round(2))
OUTPUT
Train mean (taqreeban 0): [-0. -0.  0.  0.]
Test  mean (0 nahi hoga):  [ 0.01  0.1  -0.03 -0.04]
SUNEHRA USOOL
Usool: fit sirf train par , transform train aur test dono par. Is ghalti se bachne ka sab se behtareen tareeqa Pipeline hai (Chapter 19 me).
12.6 Preprocessing: data ko model ke liye tayyar karna
ML models ko sirf numbers samajh aate hain, aur kai models numbers ke scale se mutasir hote hain. Is liye data ko tayyar karna parta hai.
1) Feature Scaling
Agar ek feature 0 se 1 ke beech hai (jaise percentage) aur doosra 0 se 1,000,000 (jaise tankhwah), to aise models (KNN, SVM, Gradient Descent, PCA) jo doori par chalte hain, bari values ko zyada ahmiyat de dete hain.
| Scaler | Kya karta hai | Kab |
|---|---|---|
| StandardScaler | Mean 0, std 1 (z-score) | Aam tor par pehli pasand, Normal jaisa data |
| MinMaxScaler | 0 se 1 ke beech | Jab limits maloom hon, neural networks |
| RobustScaler | Median aur IQR use karta hai | Jab outliers hon |
Trees aur Random Forest ko scaling ki zaroorat nahi hoti. Linear models, KNN, SVM, PCA aur neural networks ko hoti hai.
2) Categorical data ko numbers me badalna (Encoding)
cars = pd.DataFrame({
    "fuel": ["Petrol", "Diesel", "Petrol", "CNG"],
    "size": ["Small", "Large", "Medium", "Small"],
})
# One-Hot: har category ka alag 0/1 column (nominal ke liye)
print(pd.get_dummies(cars["fuel"]).astype(int))
# Ordinal: tarteeb wali categories ke liye (Small < Medium < Large)
cars["size_num"] = cars["size"].map({"Small": 1, "Medium": 2, "Large": 3})
print(cars)
OUTPUT
   CNG  Diesel  Petrol
0    0       0       1
1    0       1       0
2    0       0       1
3    1       0       0
     fuel    size  size_num
0  Petrol   Small         1
1  Diesel   Large         3
2  Petrol  Medium         2
3     CNG   Small         1
from sklearn.preprocessing import OneHotEncoder
enc = OneHotEncoder(sparse_output=False, handle_unknown="ignore")
print(enc.fit_transform(cars[["fuel"]]))
print(enc.get_feature_names_out())
OUTPUT
[[0. 0. 1.]
 [0. 1. 0.]
 [0. 0. 1.]
 [1. 0. 0.]]
['fuel_CNG' 'fuel_Diesel' 'fuel_Petrol']
3) Missing values
from sklearn.impute import SimpleImputer
data = np.array([[1.0, 10], [2.0, np.nan], [np.nan, 30], [4.0, 40]])
imp = SimpleImputer(strategy="median")      # "mean", "median", "most_frequent", "constant"
print(imp.fit_transform(data))
OUTPUT
[[ 1. 10.]
 [ 2. 30.]
 [ 2. 30.]
 [ 4. 40.]]
Sab kuch ek sath: Pipeline aur ColumnTransformer (jhalak)
Alag alag columns par alag alag preprocessing lagana aur phir model chalana, ek hi object me samet sakte hain. Iska faida: leakage nahi hota aur code saaf rehta hai. Is par pura chapter 19 aur 20 me kaam hoga, abhi sirf jhalak:
from sklearn.pipeline import Pipeline from sklearn.compose import ColumnTransformer from sklearn.linear_model import LogisticRegression df = pd.DataFrame({ "age": [25, 32, np.nan, 41, 29, 52, 36, 47], "city": ["K", "L", "K", "I", "L", "K", "I", "L"], "bought": [0, 1, 0, 1, 0, 1, 1, 0], }) X_df, y_s = df[["age", "city"]], df["bought"] prep = ColumnTransformer([ ("num", Pipeline([("imp", SimpleImputer(strategy="median")), ("sc", StandardScaler())]), ["age"]), ("cat", OneHotEncoder(handle_unknown="ignore"), ["city"]), ]) pipe = Pipeline([("prep", prep), ("model", LogisticRegression())]) pipe.fit(X_df, y_s) # sab kuch ek sath print(pipe.predict(X_df)[:4]) OUTPUT [0 0 0 1]
12.7 Overfitting aur Underfitting
Ye ML ka sab se bunyadi masla hai, aur har algorithm yahin phanstaa hai.
OUTPUT (chart)
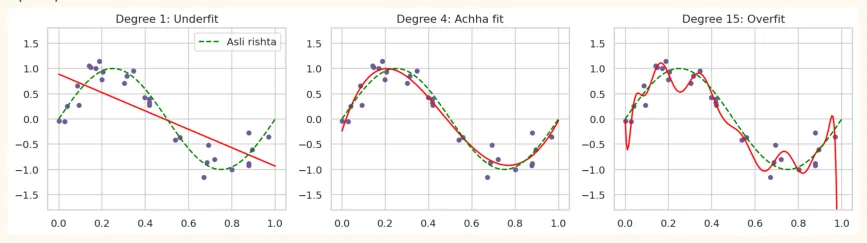
Degree 15 wali lakeer har nuqtay ko chhoone ke liye bal khati hai, yani data ke shor (noise) ko bhi ratta maar liya . Naye nuqtay par ye bohat ghalat andaza degi. Hum is ko numbers se bhi dekh sakte hain:
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
np.random.seed(2)
xq = np.random.uniform(0, 1, 60)
yq = np.sin(2 * np.pi * xq) + np.random.normal(0, 0.25, 60)
xtr, xte, ytr_p, yte_p = train_test_split(xq.reshape(-1, 1), yq, test_size=0.4,
random_state=0)
for deg in [1, 3, 5, 10, 15]:
    m = make_pipeline(PolynomialFeatures(deg), LinearRegression()).fit(xtr, ytr_p)
    tr = mean_squared_error(ytr_p, m.predict(xtr))
    te = mean_squared_error(yte_p, m.predict(xte))
    print(f"degree {deg:>2}: train MSE = {tr:.3f} | test MSE = {te:.3f}")
OUTPUT
degree  1: train MSE = 0.163 | test MSE = 0.257
degree  3: train MSE = 0.074 | test MSE = 0.080
degree  5: train MSE = 0.069 | test MSE = 0.289
degree 10: train MSE = 0.063 | test MSE = 4.521
degree 15: train MSE = 0.061 | test MSE = 244592.285
Train error hamesha kam hota jata hai, magar test error pehle kam hota hai phir barhne lagta hai (degree 15 par to bohat bara ho jata hai, model bilkul bekar). Jahan test error sab se kam ho wohi sweet spot hai (yahan degree 3).
12.8 Model Evaluation ke bunyadi usool
1) Baseline (sab se saada model)
Koi bhi model banane se pehle poochho: bina ML ke sab se saada andaza kya hoga? Classification me "hamesha sab se aam class bata do", regression me "hamesha average bata do". Aap ka model iska muqabla karke hi achha ya bura nikalta hai.
from sklearn.dummy import DummyClassifier
base = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
print("Baseline accuracy :", round(base.score(X_test, y_test), 3))      # ~ 1/3 (teen
barabar classes)
rf = RandomForestClassifier(random_state=0).fit(X_train, y_train)
print("Random Forest     :", round(rf.score(X_test, y_test), 3))
OUTPUT
Baseline accuracy : 0.333
Random Forest     : 0.933
2) Accuracy aur uski had
Accuracy = sahi andaze / kul andaze . Magar jab classes barabar na hon (imbalanced) to accuracy dhoka de sakti hai. Agar 99% log healthy hain aur 1% bimar, to model jo hamesha "healthy" kahe uski accuracy 99% hogi, magar wo bekar hai kyunke ek bhi bimar nahi pakadta. Isliye Chapter 14 me precision, recall, F1, ROC-AUC aayenge.
3) Cross-Validation (ek hi split par bharosa na karo)
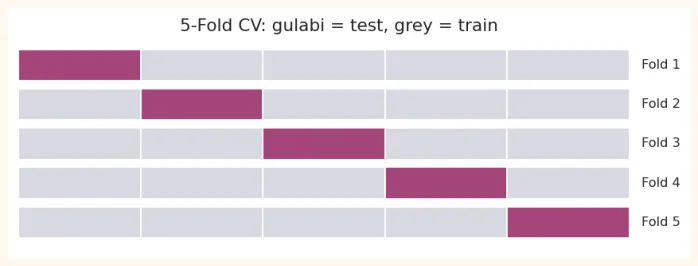
Sirf ek bar train/test split karne se nateeja ittefaq par depend kar sakta hai (shayad test me aasan examples agaye). K-Fold Cross-Validation data ko K hisson (folds) me batti hai, har bar ek hissa test aur baqi train. Aakhir me K scores ka average aur phailao milta hai, jo zyada bharosay ka hota hai.
OUTPUT (chart)
from sklearn.model_selection import cross_val_score, StratifiedKFold
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(RandomForestClassifier(random_state=0), X, y, cv=cv)
print("Har fold ka score:", scores.round(3))
print("Average:", scores.mean().round(3), "| Std:", scores.std().round(3))
OUTPUT
Har fold ka score: [1.    0.967 0.933 1.    0.9  ]
Average: 0.96 | Std: 0.039
AAM GALTIYAN
-
Test set ko bar bar dekhna aur us ke hisaab se model badalna. Tab test set bhi "training" ka hissa ban jata hai. Tuning ke liye cross-validation ya alag validation set use karo.
-
Scaler ko poore data par fit karna (leakage).
-
Baseline ke baghair model ko "achha" kehna.
-
Imbalanced data par sirf accuracy dekhna.
-
Target (y) ko galti se features (X) me rakh dena (ye bhi leakage hai).
-
Train score par khush ho jana. Asli kaarkardagi test/cross-validation score hai.
12.9 Hands-on
Breast cancer dataset (569 mareez, 30 napayiyan, target: malignant ya benign) par ek mukammal chhota workflow:
from sklearn.datasets import load_breast_cancer
bc = load_breast_cancer(as_frame=True)
Xb, yb = bc.data, bc.target
print(Xb.shape, "| malignant:", int((yb == 0).sum()), "| benign:", int((yb == 1).sum()))
OUTPUT
(569, 30) | malignant: 212 | benign: 357
-
Split: 80/20, stratify=yb , random_state=42.
-
Baseline: DummyClassifier ki accuracy nikalo.
-
Scaling: StandardScaler (sirf train par fit) lagao.
-
Models: KNN aur LogisticRegression dono ko scaled aur unscaled data par chalao. Scaling ka farq dekho.
-
Cross-validation: sab se behtar model ka 5-fold CV score nikalo.
-
Sochne wala sawal: cancer detection me accuracy kafi kyun nahi? (Hint: bimar ko na pakadne ki qeemat kya hai?)
Xtr, Xte, ytr, yte = train_test_split(Xb, yb, test_size=0.2, random_state=42, stratify=yb)
print("Baseline:", round(DummyClassifier(strategy="most_frequent").fit(Xtr, ytr).score(Xte,
yte), 3))
for name, model in [("KNN", KNeighborsClassifier()), ("LogReg",
LogisticRegression(max_iter=5000))]:
    raw = model.fit(Xtr, ytr).score(Xte, yte)
    sc = StandardScaler().fit(Xtr)
    scaled = model.fit(sc.transform(Xtr), ytr).score(sc.transform(Xte), yte)
    print(f"{name:7s} unscaled = {raw:.3f} | scaled = {scaled:.3f}")
OUTPUT
Baseline: 0.632
KNN     unscaled = 0.912 | scaled = 0.956
LogReg  unscaled = 0.965 | scaled = 0.982
KEY TAKEAWAYS
-
ML me hum examples se pattern seekhte hain taake naye data par sahi andaza lagayein (generalization).
-
• Supervised (label hai: regression ya classification), Unsupervised (label nahi: clustering, dimensionality reduction), Reinforcement (inaam/saza).
-
Features (X) se target (y) ka andaza. Parameters model seekhta hai, hyperparameters hum tay karte hain.
-
scikit-learn: fit, predict, score, transform. Har model ka interface ek jaisa hai.
-
Hamesha train/test split karo. fit sirf train par, transform dono par (leakage se bacho).
-
Scaling (StandardScaler), encoding (OneHot), imputation (SimpleImputer). Trees ko scaling nahi chahiye.
-
Underfitting = bohat saada, overfitting = ratta. Test score hi asli score hai. Baseline aur cross-validation zaroor use karo.