Chapter 18: Support Vector Machines (SVM)
MODULE 4 | WEEK 18
Chapter 18: Support Vector Machines (SVM)
Support Vector Machine (SVM) classification ka ek taqatwar aur khoobsurat algorithm hai. Logistic regression aur trees se iska tareeqa alag hai: ye do classes ke darmiyan sab se chora raasta (margin) dhoondta hai. Aur kernel trick ki wajah se ye ghumavdar, pecheeda sarhadein bhi bana sakta hai.
18.1 SVM ka idea: sab se chora raasta
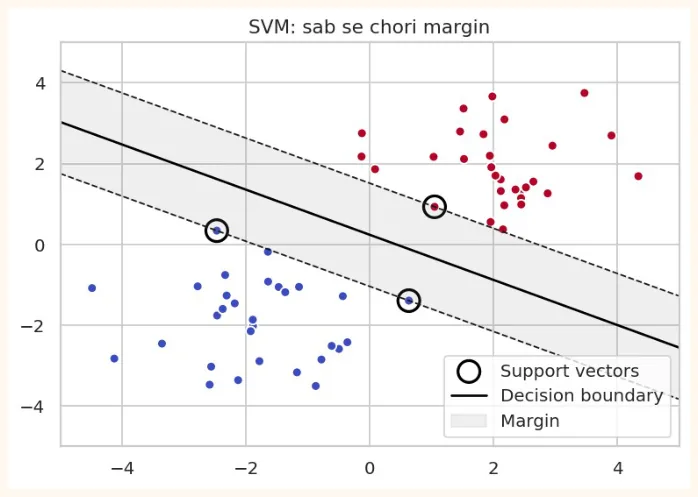
Do classes ke beech me kai lakeerein kheechi ja sakti hain jo unhein alag karein. Sawal ye hai: sab se behtareen kaun si? SVM kehta hai: wo lakeer jo dono classes se sab se zyada door ho, yani jis ke dono taraf sab se chora khali raasta (margin) ho.
OUTPUT (chart)
-
Decision boundary (kali lakeer): dono classes ko alag karne wali lakeer.
-
Margin (dhundla hissa): boundary ke dono taraf ka khali raasta. SVM isay sab se bara banata hai.
-
Support Vectors (gol dairay wale nuqtay): wo chand nuqtay jo margin ki kinaron par hain. Sirf yehi boundary tay karte hain. Baqi nuqtay hata bhi do to boundary nahi badalti.
18.2 Hard margin aur Soft margin: C
Asli data me classes aksar mili hui hoti hain aur perfect alag nahi hoti. Agar hum zid karein ke ek bhi nuqta margin ke andar ya ghalat taraf na ho ( hard margin ), to ya to masla hal hi nahi hota ya boundary bohat tang aur noise par nirbhar ho jati hai.
Soft margin me hum kuch ghaltiyan bardasht kar lete hain, aur parameter C batata hai kitni:
| C | Matlab | Margin | Risk |
|---|---|---|---|
| Chhota C(jaise 0.01) | Ghaltiyan bardasht, margin ko tarjeeh | Chora, saada | Underfitting |
| Bara C(jaise 1000) | Ghalti ki sakht saza, har nuqta sahi karna chahta hai | Tang | Overfitting |
OUTPUT (chart)
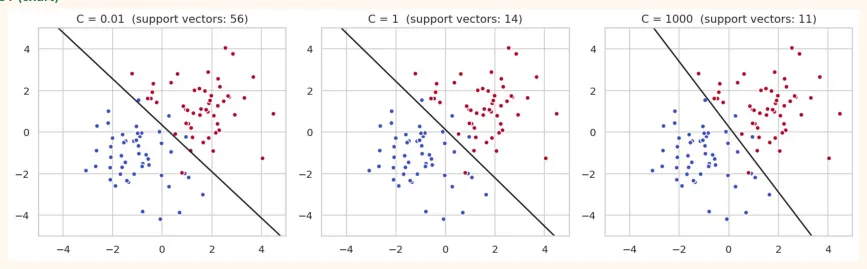
Chhote C par bohat saray nuqtay support vector ban jate hain (margin chora), aur bare C par kam (margin tang). Alag alag C par boundary ka zaviya bhi badalta hai.
18.3 Kernel Trick: ghumavdar boundaries
Kabhi data ko seedhi lakeer se alag karna mumkin hi nahi hota. Neeche ek ke andar ek (gol dairay) wali classes dekho:
from sklearn.datasets import make_circles
Xc, yc = make_circles(n_samples=200, factor=0.3, noise=0.08, random_state=0)
lin = SVC(kernel="linear").fit(Xc, yc)
plt.figure(figsize=(5.4, 4.6))
plt.scatter(Xc[:, 0], Xc[:, 1], c=yc, cmap="coolwarm", edgecolor="white")
plt.title(f"Seedhi lakeer yahan kaam nahi karti (accuracy {lin.score(Xc, yc):.2f})")
plt.show()
OUTPUT (chart)
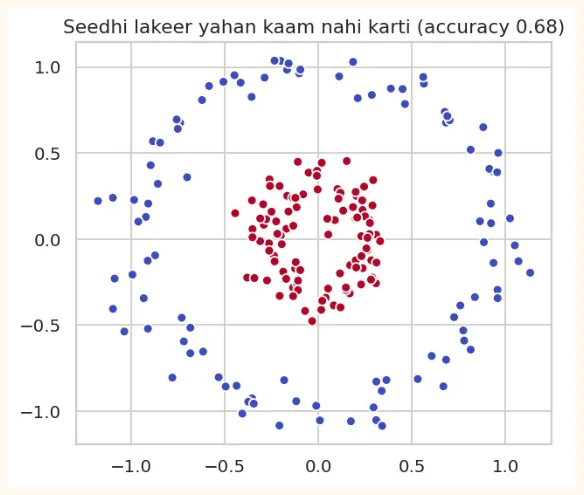
Seedhi lakeer is ko alag nahi kar sakti. Kernel trick ka kamal: data ko zyada dimensions me le jao jahan wo seedhi lakeer (ya plane) se alag ho sakta hai, aur wapas aao to boundary ghumavdar nazar aati hai.
OUTPUT (chart)
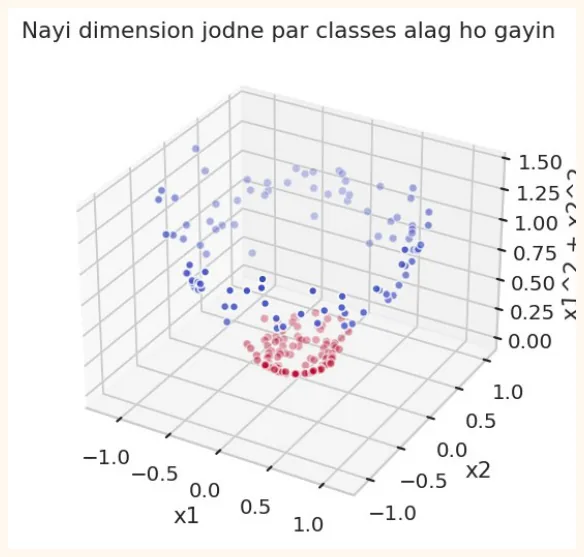
Nayi (teesri) dimension x1<sup>2</sup> + x2<sup>2</sup> jodne par laal nuqtay neeche aur neele upar aa gaye, aur ek seedha plane unhein alag kar sakta hai. Kernel ye sab haqiqat me naye columns banaye baghair hisaab me kar leta hai.
Aam kernels
| Kernel | Boundary ki shakal | Kab |
|---|---|---|
| linear | Seedhi lakeer / plane | Data lagbhag linearly alag ho, bohat zyada features |
| poly(degree = d) | Polynomial curve | Jab polynomial rishta ho (kam istemal) |
| rbf(default) | Ghumavdar, har shakal | Aam taur par pehli pasand, jab pata na ho data kaisa hai |
| sigmoid | Neural network jaisa | Kam istemal |
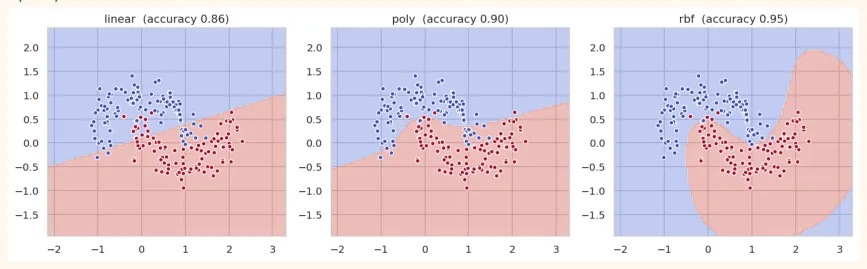
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.datasets import make_moons
Xm, ym = make_moons(n_samples=200, noise=0.2, random_state=1)
fig, axes = plt.subplots(1, 3, figsize=(13, 4))
for ax, (kernel, kw) in zip(axes, [("linear", {}), ("poly", {"degree": 3}), ("rbf", {})]):
    m = SVC(kernel=kernel, C=1, **kw).fit(Xm, ym)
    DecisionBoundaryDisplay.from_estimator(m, Xm, ax=ax, alpha=0.35, cmap="coolwarm",
response_method="predict")
    ax.scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolor="white", s=22)
    ax.set_title(f"{kernel}  (accuracy {m.score(Xm, ym):.2f})")
plt.tight_layout()
plt.show()
OUTPUT (chart)
RBF kernel ka gamma
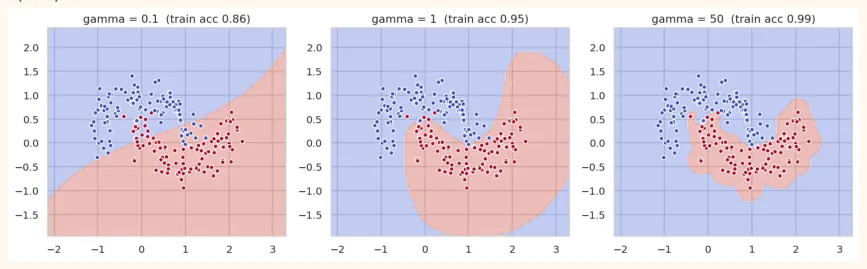
RBF kernel me ek aur ahem hyperparameter gamma hai: ye batata hai ke ek nuqta ka asar kitni door tak jata hai.
-
Chhota gamma: har nuqta ka asar door tak (boundary nazuk, saada, smooth) → underfitting ka khatra.
-
Bara gamma: har nuqta ka asar sirf aas paas (boundary har nuqtay ke gird ghoomti hai, bohat pecheeda) → overfitting ka khatra.
fig, axes = plt.subplots(1, 3, figsize=(13, 4))
for ax, g in zip(axes, [0.1, 1, 50]):
    m = SVC(kernel="rbf", gamma=g, C=1).fit(Xm, ym)
    DecisionBoundaryDisplay.from_estimator(m, Xm, ax=ax, alpha=0.35, cmap="coolwarm",
response_method="predict")
    ax.scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolor="white", s=22)
    ax.set_title(f"gamma = {g}  (train acc {m.score(Xm, ym):.2f})")
plt.tight_layout()
plt.show()
OUTPUT (chart)
18.4 SVC scikit-learn me
Breast cancer dataset par. Yaad rakho: SVM me scaling zaroori hai , kyunke ye doori par chalta hai.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
bc = load_breast_cancer(as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(bc.data, bc.target, test_size=0.25,
random_state=0, stratify=bc.target)
no_scale = SVC().fit(X_train, y_train)
scaled = make_pipeline(StandardScaler(), SVC()).fit(X_train, y_train)
print("Bina scaling :", round(no_scale.score(X_test, y_test), 3))
print("Scaling ke saath:", round(scaled.score(X_test, y_test), 3))
OUTPUT
Bina scaling : 0.916
Scaling ke saath: 0.958
Scaling ne nateeja kaafi behtar kar diya. Ab alag alag kernels:
for kernel in ["linear", "poly", "rbf", "sigmoid"]:
    m = make_pipeline(StandardScaler(), SVC(kernel=kernel)).fit(X_train, y_train)
    print(f"{kernel:8s} test accuracy = {m.score(X_test, y_test):.3f}")
OUTPUT
linear   test accuracy = 0.965
poly     test accuracy = 0.909
rbf      test accuracy = 0.958
sigmoid  test accuracy = 0.930
Probability aur multiclass
-
SVM aam taur par sirf class batata hai. probability=True dene par ye probability bhi deta hai (magar training slow ho jati hai).
-
SVM asal me do classes ke liye hai. Zyada classes ke liye scikit-learn khud one-vs-one tareeqa lagata hai (har do classes ka alag SVM).
from sklearn.datasets import load_iris
iris = load_iris()
Xi_tr, Xi_te, yi_tr, yi_te = train_test_split(iris.data, iris.target, test_size=0.25,
random_state=0, stratify=iris.target)
m = make_pipeline(StandardScaler(), SVC(probability=True, random_state=0)).fit(Xi_tr, yi_tr)
print("Iris accuracy:", round(m.score(Xi_te, yi_te), 3))
print("Ek phool ki probabilities:", m.predict_proba(Xi_te[:1]).round(3))
OUTPUT
Iris accuracy: 0.974
Ek phool ki probabilities: [[0.97 0.017 0.013]]
18.5 SVR: SVM regression ke liye
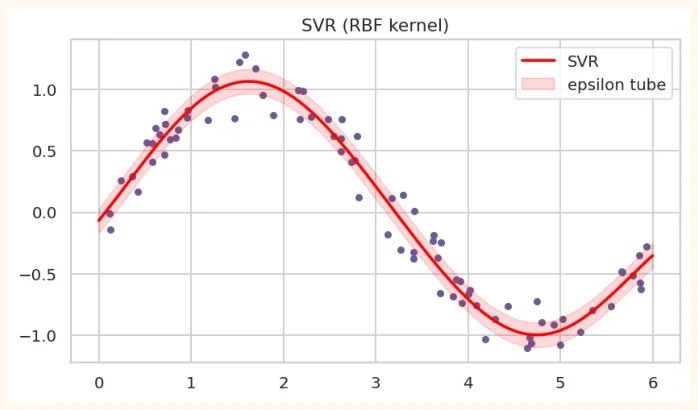
SVM numbers ka andaza bhi laga sakta hai ( SVR ). Idea: ek tube (epsilon) banao jis ke andar ki ghaltiyon ko maaf kar do, aur sirf tube se bahar wale nuqton ko saza do.
from sklearn.svm import SVR
rng = np.random.RandomState(0)
xr = np.sort(rng.uniform(0, 6, 80)).reshape(-1, 1)
yr = np.sin(xr).ravel() + rng.normal(0, 0.15, 80)
xs = np.linspace(0, 6, 300).reshape(-1, 1)
svr = SVR(kernel="rbf", C=10, epsilon=0.1).fit(xr, yr)
plt.figure(figsize=(7.5, 4))
plt.scatter(xr, yr, color="#6B5B95", s=16)
plt.plot(xs, svr.predict(xs), color="red", linewidth=2, label="SVR")
plt.fill_between(xs.ravel(), svr.predict(xs) - 0.1, svr.predict(xs) + 0.1, color="red",
alpha=0.15, label="epsilon tube")
plt.legend()
plt.title("SVR (RBF kernel)")
plt.show()
OUTPUT (chart)
18.6 Hyperparameter Tuning ki jhalak: GridSearchCV
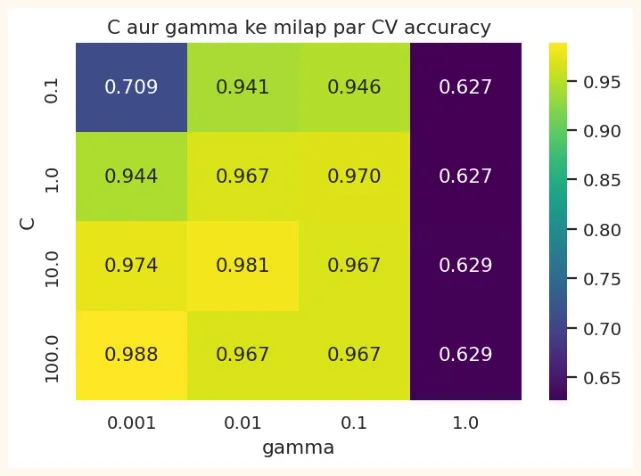
SVM me C aur gamma ka sahi milap dhoondna zaroori hai. GridSearchCV alag alag combinations ko crossvalidation se aazmata hai aur behtareen chun leta hai. (Is ki poori tafseel agle chapter me hai.)
from sklearn.model_selection import GridSearchCV
pipe = make_pipeline(StandardScaler(), SVC())
grid = {"svc__C": [0.1, 1, 10, 100], "svc__gamma": [0.001, 0.01, 0.1, 1]}
search = GridSearchCV(pipe, grid, cv=5, n_jobs=-1).fit(X_train, y_train)
print("Behtareen parameters:", search.best_params_)
print("CV score:", round(search.best_score_, 3))
print("Test score:", round(search.score(X_test, y_test), 3))
OUTPUT
Behtareen parameters: {'svc__C': 100, 'svc__gamma': 0.001}
CV score: 0.988
Test score: 0.958
scores = pd.DataFrame(search.cv_results_)
heat = scores.pivot_table(index="param_svc__C", columns="param_svc__gamma",
values="mean_test_score")
import seaborn as sns
plt.figure(figsize=(6.2, 4))
sns.heatmap(heat, annot=True, fmt=".3f", cmap="viridis")
plt.title("C aur gamma ke milap par CV accuracy")
plt.ylabel("C")
plt.xlabel("gamma")
plt.show()
OUTPUT (chart)
18.7 SVM ke fayde aur nuqsan
| Fayde | Nuqsan |
|---|---|
| Zyada features wale data par achha kaam | Bare data(lakhon rows) par bohat slow |
| Kernel se ghumavdar boundaries | Scalingzaroori |
| Margin ki wajah se overfitting kam | C, gamma aur kernel ka intikhab mushkil |
| Memory efficient (sirf support vectors) | Seedhi probability nahi deta (extra computation) |
| Chhote aur darmiyane data par aksar behtareen | Samajhna mushkil (kernel SVM black box jaisa) |
| Kam samples, zyada features (jaise gene data) me mashhoor | Noise wale data aur overlapping classes me kamzor |
| Kab SVM chunein | Kab nahi |
|---|---|
| Chhota ya darmiyana data, saaf alag hone wali classes | Lakhon rows (Random Forest ya Gradient Boosting behtar) |
| Text classification (linear SVM) | Jab model ko samjhana zaroori ho (Logistic Regression ya Tree) |
| Zyada features aur kam samples | Jab probabilities zaroori hon |
AAM GALTIYAN
-
Scaling bhool jana. SVM ke liye ye sab se bari ghalti hai.
-
Bare data par kernel SVM lagana (hazaron rows par bhi slow). Linear SVM ( LinearSVC ) tez hai.
-
C aur gamma default par chhor dena, tuning na karna.
-
Bohat bara gamma aur bara C se train accuracy 100% dekh kar khush ho jana (overfit).
-
predict_proba ko seedha bharosay ka samajhna aur probability=True ke baghair istemal karne ki koshish.
-
Categorical features ko encode kiye baghair SVM me dena.
18.8 Hands-on
from sklearn.datasets import load_wine
wine = load_wine(as_frame=True)
Xw_tr, Xw_te, yw_tr, yw_te = train_test_split(wine.data, wine.target, test_size=0.25,
random_state=0, stratify=wine.target)
print(wine.data.shape, "| classes:", np.bincount(wine.target))
for name, m in [("SVM scale ke baghair", SVC()), ("SVM scaled",
make_pipeline(StandardScaler(), SVC()))]:
    print(f"{name:22s} test accuracy = {m.fit(Xw_tr, yw_tr).score(Xw_te, yw_te):.3f}")
OUTPUT
(178, 13) | classes: [59 71 48]
SVM scale ke baghair   test accuracy = 0.600
SVM scaled             test accuracy = 1.000
-
Wine dataset (3 classes): upar dekho scaling se accuracy kitni badli. Is ki wajah apne alfaz me likho (features ka scale dekho: wine.data.describe()).
-
Kernels: wine par linear, poly aur rbf compare karo (scaled).
-
C ka asar: breast cancer par C = 0.001, 0.01, 0.1, 1, 10, 100 par train aur test accuracy plot karo.
-
GridSearch: wine par C aur gamma ka grid chala kar heatmap banao.
-
Muqabla: wine par SVM, Logistic Regression aur Random Forest ka 5-fold CV score nikal kar table banao.
-
Sochne wala sawal: moons wale chart me gamma = 50 par train accuracy bohat zyada thi. Kya ye model naye data par bhi achha chalega? Kaise check karoge?
from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
for name, m in [("SVM", make_pipeline(StandardScaler(), SVC())),
                ("Logistic Regression", make_pipeline(StandardScaler(),
LogisticRegression(max_iter=2000))),
                ("Random Forest", RandomForestClassifier(random_state=0))]:
    s = cross_val_score(m, wine.data, wine.target, cv=5)
    print(f"{name:20s} CV accuracy = {s.mean():.3f} (+/- {s.std():.3f})")
OUTPUT
SVM                  CV accuracy = 0.983 (+/- 0.022)
Logistic Regression  CV accuracy = 0.983 (+/- 0.014)
Random Forest        CV accuracy = 0.983 (+/- 0.022)
KEY TAKEAWAYS
-
SVM do classes ke darmiyan sab se chora margin dhoondta hai. Sirf support vectors (margin ke kinaray ke nuqtay) boundary tay karte hain.
-
C: soft margin ki sakhti. Chhota C = chora margin, saada (underfit). Bara C = tang margin, ratta (overfit).
-
Kernel trick data ko zyada dimensions me le jaa kar ghumavdar boundaries banata hai. rbf aam taur par pehli pasand; linear, poly bhi hain.
-
RBF me gamma: ek nuqta ka asar kitni door. Chhota = smooth, bara = har nuqtay ke gird (overfit). C aur gamma ek sath tune karo.
-
Scaling SVM ke liye zaroori hai. Zyada classes ke liye one-vs-one khud lagta hai, probability ke liye probability=True.
-
SVR regression ke liye (epsilon tube). Kernel SVM bare data par slow; chhote/darmiyane aur zyada features wale data par behtareen.
-
GridSearchCV C aur gamma ke behtareen milap cross-validation se dhoondta hai.