Chapter 19: KNN, Model Optimization aur Hyperparameter Tuning
MODULE 4 | WEEK 19
Chapter 19: KNN, Model Optimization aur Hyperparameter Tuning
Is chapter ke do hisse hain. Pehle ek saada magar bohat samajhne wala algorithm: K-Nearest Neighbors (KNN) . Phir ML ka sab se amali hunar: model ko behtar banana : cross-validation, learning curves, GridSearchCV , RandomizedSearchCV aur Pipeline (taake leakage na ho).
19.1 K-Nearest Neighbors (KNN)
KNN ka idea insan ke sochne jaisa hai: "main kaun hoon, ye mere sab se qareebi padosi dekh kar batao."
Algorithm
-
K tay karo (maslan 5).
-
Naye nuqtay ki sab nuqton se doori nikalo.
-
K sab se qareebi nuqtay chuno.
-
Classification: un K me se sab se zyada wali class (vote). Regression: un K ke average .
OUTPUT (chart)
-> class1 Naya point -1 -2](/ur/img/source/converted/module-04/ur/module-04-ur-page-220-figure-01.webp)
Doori kaise napein?
| Paimana | Formula | Matlab |
|---|---|---|
| Euclidean(default) | sqrt(sum((a - b)<sup>2</sup>)) | Seedhi (parindey ki udaan) doori |
| Manhattan | sum( | a - b |
| Minkowski | Dono ka umoomi roop (p = 1 Manhattan, p = 2 Euclidean) | KNN ka asli default |
a = np.array([1, 2])
b = np.array([4, 6])
print("Euclidean:", np.sqrt(((a - b) ** 2).sum()))     # 5.0
print("Manhattan:", np.abs(a - b).sum())               # 7
OUTPUT
Euclidean: 5.0
Manhattan: 7
sklearn me KNN
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
bc = load_breast_cancer(as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(bc.data, bc.target, test_size=0.25,
random_state=0, stratify=bc.target)
raw = KNeighborsClassifier(n_neighbors=5).fit(X_train, y_train)
scaled = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5)).fit(X_train,
y_train)
print("Bina scaling   :", round(raw.score(X_test, y_test), 3))
print("Scaling ke saath:", round(scaled.score(X_test, y_test), 3))
OUTPUT
Bina scaling   : 0.916
Scaling ke saath: 0.951
K chunna: bias-variance
-
K = 1: sirf sab se qareebi padosi ko dekho. Boundary bohat ghumavdar, noise ko bhi pakadta hai → overfitting (high variance).
-
K bohat bara: bohat saray padosi, boundary saada ho jati hai → underfitting (high bias). K = poora data ho to hamesha sab se zyada wali class.
-
Aam shuruaat: K = 3 se 15 (taaq number) , taake vote barabar na ho. Behtareen K cross-validation se chuna jata hai.
from sklearn.model_selection import cross_val_score
ks = range(1, 31)
cv_scores, train_scores = [], []
for k in ks:
    m = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k))
    cv_scores.append(cross_val_score(m, X_train, y_train, cv=5).mean())
    train_scores.append(m.fit(X_train, y_train).score(X_train, y_train))
best_k = list(ks)[int(np.argmax(cv_scores))]
plt.figure(figsize=(7.8, 4))
plt.plot(ks, train_scores, marker="o", markersize=3, color="#6B5B95", label="Train
accuracy")
plt.plot(ks, cv_scores, marker="s", markersize=3, color="#A4457A", label="Cross-validation
accuracy")
plt.axvline(best_k, color="gray", linestyle="--", label=f"Behtareen K = {best_k}")
plt.xlabel("K (padosiyon ki tadaad)")
plt.ylabel("Accuracy")
plt.title("K barhne par model saada hota jata hai")
plt.legend()
plt.grid(alpha=0.3)
plt.show()
print("Behtareen K:", best_k, "| CV accuracy:", round(max(cv_scores), 3))
OUTPUT (chart)
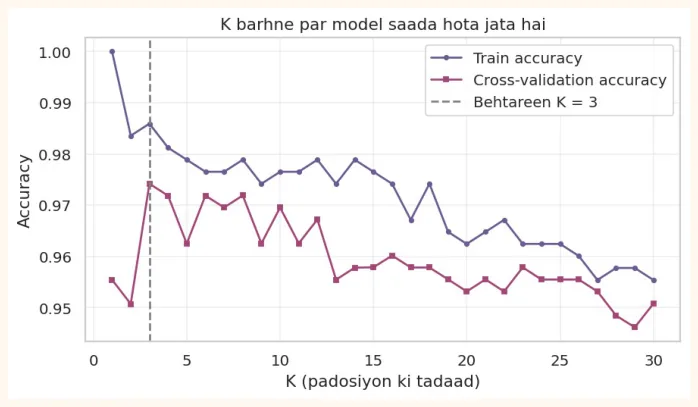
K = 1 par train accuracy 100% hoti hai (har nuqta apna hi padosi hai, ratta). K barhne par train accuracy ghatti hai, jab ke CV accuracy pehle barhti phir ghatne lagti hai.
KNN Regression aur weights
from sklearn.neighbors import KNeighborsRegressor
from sklearn.datasets import load_diabetes
dX, dy = load_diabetes(return_X_y=True)
dXtr, dXte, dytr, dyte = train_test_split(dX, dy, test_size=0.2, random_state=42)
for w in ["uniform", "distance"]:        # distance: qareeb walon ka zyada wazan
    m = KNeighborsRegressor(n_neighbors=10, weights=w).fit(dXtr, dytr)
    print(f"weights = {w:8s} test R2 = {m.score(dXte, dyte):.3f}")
OUTPUT
weights = uniform  test R2 = 0.412
weights = distance test R2 = 0.425
weights="distance" ka matlab qareeb wale padosi ka vote zyada wazni (door wale ka kam). Kabhi kabhi nateeja behtar hota hai.
| KNN ke fayde | KNN ke nuqsan |
|---|---|
| Bohat saada aur samajhne me aasan | Predictionslow(har bar saray data se doori) |
| Training koi nahi, naya data asani se jur jata hai | Scalingzaroori |
| Ghumavdar boundaries khud ban jati hain | Zyada features me kharab (curse of dimensionality, Chapter 17) |
| Classification aur regression dono | Irrelevant features aur outliers se mutasir; imbalance par kamzor |
19.2 Model Optimization: model ko behtar kaise banayein
Ek model bana kar chhor dena kafi nahi. Usay behtar banane ke tareeqay aur sahi parakh ka tareeqa seekhna zaroori hai.
1) Cross-Validation (dobara, gehrai se)
Pichle chapters me dekha ke ek akele train/test split par bharosa nahi karte. K-Fold CV data ko K hisson me bant kar K bar train/test karta hai. Stratified K-Fold har fold me classes ka hissa barabar rakhta hai (classification me hamesha yehi use karo).
from sklearn.model_selection import KFold, StratifiedKFold, cross_val_score, cross_validate
from sklearn.linear_model import LogisticRegression
model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(model, bc.data, bc.target, cv=skf)
print("Accuracy:", scores.round(3), "-> average", scores.mean().round(3), "+/-",
scores.std().round(3))
multi = cross_validate(model, bc.data, bc.target, cv=skf, scoring=["accuracy", "recall",
"precision", "f1", "roc_auc"])
for m_name in ["accuracy", "recall", "precision", "f1", "roc_auc"]:
    print(f"{m_name:10s}: {multi['test_' + m_name].mean():.3f}")
OUTPUT
Accuracy: [0.974 0.947 0.965 0.991 0.991] -> average 0.974 +/- 0.017
accuracy  : 0.974
recall    : 0.992
precision : 0.968
f1        : 0.979
roc_auc   : 0.995
2) Learning Curve: kya mazeed data madad karega?
Learning curve training data barhane par train aur validation score ka graph hai. Ye batati hai ke model ko mazeed data chahiye ya zyada pecheeda model .
from sklearn.model_selection import learning_curve
from sklearn.ensemble import RandomForestClassifier
fig, axes = plt.subplots(1, 2, figsize=(11, 3.9), sharey=True)
for ax, (name, est) in zip(axes, [("Logistic Regression (saada)", model),
                                  ("Random Forest (pecheeda)",
RandomForestClassifier(n_estimators=100, random_state=0))]):
    sizes, tr, va = learning_curve(est, bc.data, bc.target, cv=5,
train_sizes=np.linspace(0.1, 1.0, 6), random_state=0)
    ax.plot(sizes, tr.mean(axis=1), marker="o", color="#6B5B95", label="Train")
    ax.plot(sizes, va.mean(axis=1), marker="s", color="#A4457A", label="Validation")
    ax.set_title(name)
    ax.set_xlabel("Training samples")
    ax.grid(alpha=0.3)
axes[0].set_ylabel("Accuracy")
axes[0].legend()
plt.tight_layout()
plt.show()
OUTPUT (chart)
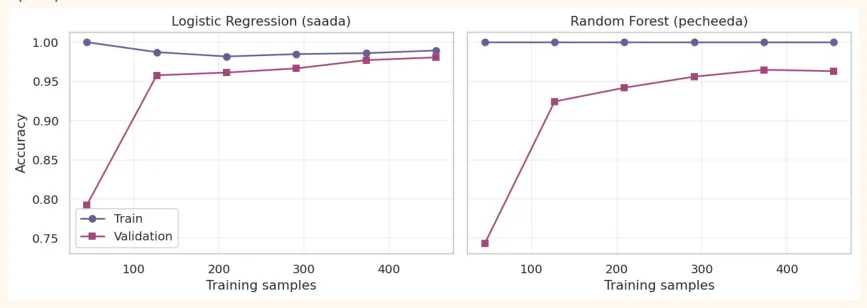
| Graph kaisa dikhe | Matlab | Kya karein |
|---|---|---|
| Train aur validation donokamaur | Underfitting(high bias) | Zyada pecheeda model, behtar features, i |
| qareeb | regularization kam | |
| Trainbohat zyada, validation kam, | Overfitting(high variance) | Zyada data, saada model, regularization, kam |
| baragap | features | |
| Dono qareeb aurachhe, validation abhi barh rahi | Mazeed data madad karega | Aur data jama karo |
3) Validation Curve: ek hyperparameter ka asar
from sklearn.model_selection import validation_curve
depths = [1, 2, 3, 5, 8, 12, 20]
tr, va = validation_curve(RandomForestClassifier(n_estimators=50, random_state=0), bc.data,
bc.target,
                          param_name="max_depth", param_range=depths, cv=5)
for d, t, v in zip(depths, tr.mean(axis=1), va.mean(axis=1)):
    print(f"max_depth = {d:>2}: train = {t:.3f} | validation = {v:.3f}")
OUTPUT
max_depth =  1: train = 0.938 | validation = 0.919
max_depth =  2: train = 0.963 | validation = 0.951
max_depth =  3: train = 0.978 | validation = 0.954
max_depth =  5: train = 0.994 | validation = 0.956
max_depth =  8: train = 0.999 | validation = 0.963
max_depth = 12: train = 1.000 | validation = 0.963
max_depth = 20: train = 1.000 | validation = 0.963
19.3 Hyperparameter Tuning
Hyperparameters wo settings hain jo hum training se pehle tay karte hain (K, C, gamma, max_depth, learning rate). Behtareen milap dhoondne ka amali tareeqa search hai:
GridSearchCV: har mumkin milap aazmao
Nateejon ko dekhna
results = pd.DataFrame(grid.cv_results_)
cols = ["param_svc__C", "param_svc__kernel", "param_svc__gamma", "mean_test_score",
"rank_test_score"]
print(results[cols].sort_values("rank_test_score").head(5).round(3).to_string(index=False))
OUTPUT
 param_svc__C param_svc__kernel param_svc__gamma  mean_test_score  rank_test_score
          0.1            linear            scale            0.991                1
          0.1            linear             0.01            0.991                1
          1.0               rbf            scale            0.989                3
         10.0               rbf             0.01            0.985                4
          1.0            linear             0.01            0.983                5
RandomizedSearchCV: random milap aazmao (tez)
Agar hyperparameters bohat hon to grid search bohat slow hai (10 values x 5 hyperparameters = 100,000 milap!). RandomizedSearchCV random n_iter milap aazmata hai, aur tajurbe se zyada tar behtareen nateeja kam waqt me deta hai.
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint, uniform
param_dist = {
    "n_estimators": randint(50, 300),
    "max_depth": randint(2, 20),
    "min_samples_leaf": randint(1, 10),
    "max_features": uniform(0.2, 0.7),          # 0.2 se 0.9 ke beech
}
rs = RandomizedSearchCV(RandomForestClassifier(random_state=0, n_jobs=-1), param_dist,
n_iter=15, cv=5,
                        scoring="f1", random_state=0, n_jobs=-1)
rs.fit(X_train, y_train)
print("Behtareen milap:", {k: (float(round(v, 2)) if isinstance(v, float) else int(v)) for
k, v in rs.best_params_.items()})
print("CV f1:", round(rs.best_score_, 3), "| Test f1:", round(rs.score(X_test, y_test), 3))
OUTPUT
Behtareen milap: {'max_depth': 16, 'max_features': 0.6, 'min_samples_leaf': 6, 'n_e...
CV f1: 0.968 | Test f1: 0.944
| GridSearchCV | RandomizedSearchCV | |
|---|---|---|
| Tareeqa | Har milap aazmata hai | Random n_iter milap aazmata hai |
| Kab | Hyperparameters kam aur values chhoti | Hyperparameters zyada, ya continuous ranges |
| Waqt | Zyada | Tay karo (n_iter) |
| Nateeja | Grid ke andar sab se behtareen | Aksar grid ke qareeb, kam waqt me |
SUNEHRA USOOL
Test set ko tuning me kabhi mat istemal karo. Tuning ke dauran CV score dekho; test set sirf aakhri, ek bar ki parakh ke liye. Agar bar bar test score dekh kar parameters badlogi to test set bhi training ka hissa ban jata hai (leakage).
Tuning ki tarteeb: pehle baseline , phir behtar model/features , phir tuning . Aksar data aur features ki behtari tuning se zyada faida deti hai.
19.4 Pipeline: leakage se bachne ka mukammal tareeqa
Chapter 12 me dekha ke scaler ko poore data par fit karna leakage hai. Cross-validation ke dauran bhi har fold me scaler sirf us fold ke train hisse par fit hona chahiye. Pipeline ye khud sambhal leti hai.
# GHALAT: pehle poore data ko scale karo, phir CV (test fold ki maloomat scaler me chali
gayi)
X_leaky = StandardScaler().fit_transform(bc.data)
leaky = cross_val_score(KNeighborsClassifier(), X_leaky, bc.target, cv=5).mean()
# SAHI: Pipeline ke andar scaler, har fold me alag fit hota hai
clean = cross_val_score(make_pipeline(StandardScaler(), KNeighborsClassifier()), bc.data,
bc.target, cv=5).mean()
print("Leakage ke saath:", round(leaky, 4))
print("Pipeline (sahi)  :", round(clean, 4))
OUTPUT
Leakage ke saath: 0.9649
Pipeline (sahi)  : 0.9649
Is dataset par dono ka score ek jaisa aaya (0.9649), kyunke data bara aur saaf hai aur KNN par asar halka hai. Magar ye har dataset ke liye sach nahi : kam data, zyada features, ya PCA/feature selection jaise steps me leakage nateeje ko jhoota achha dikha sakti hai, aur ye khatarnak hai kyunke pata hi nahi chalta. Isliye aadat daalo: hamesha Pipeline.
Mukammal Pipeline: numeric + categorical columns
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder
from sklearn.ensemble import RandomForestClassifier
df = pd.DataFrame({
    "age": [25, 32, np.nan, 41, 29, 52, 36, 47, 33, 28, 60, 45],
    "income": [30, 45, 50, np.nan, 38, 90, 60, 75, 42, 35, 95, 80],
    "city": ["K", "L", "K", "I", "L", "K", "I", "L", "K", "I", "L", "K"],
    "bought": [0, 0, 0, 1, 0, 1, 1, 1, 0, 0, 1, 1],
})
Xf, yf = df.drop(columns="bought"), df["bought"]
prep = ColumnTransformer([
    ("num", make_pipeline(SimpleImputer(strategy="median"), StandardScaler()), ["age",
"income"]),
    ("cat", OneHotEncoder(handle_unknown="ignore"), ["city"]),
])
full = make_pipeline(prep, RandomForestClassifier(n_estimators=100, random_state=0))
print("CV accuracy:", cross_val_score(full, Xf, yf, cv=3).mean().round(3))
full.fit(Xf, yf)
print("Naye customer ka andaza:", full.predict(pd.DataFrame({"age": [38], "income": [70],
"city": ["L"]})))
OUTPUT
CV accuracy: 0.833
Naye customer ka andaza: [1]
Pipeline ke saath GridSearch
Pipeline ke hyperparameters ko step_ka_naam__parameter (do underscore) likh kar tune karte hain. Is se preprocessing bhi tuning me shamil ho sakti hai.
pipe = make_pipeline(StandardScaler(), KNeighborsClassifier())
gs = GridSearchCV(pipe, {"kneighborsclassifier__n_neighbors": [3, 5, 7, 11, 15],
                         "kneighborsclassifier__weights": ["uniform", "distance"]}, cv=5)
gs.fit(X_train, y_train)
print(gs.best_params_, "| CV:", round(gs.best_score_, 3), "| Test:", round(gs.score(X_test,
y_test), 3))
OUTPUT
{'kneighborsclassifier__n_neighbors': 3, 'kneighborsclassifier__weights': 'uniform'...
19.5 Models ka muqabla
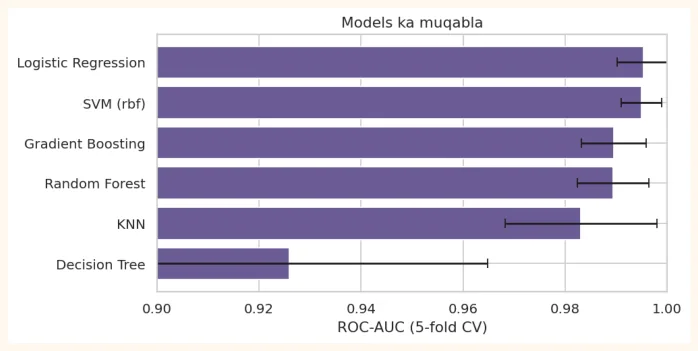
Ek se zyada models ko ek jaisi cross-validation par aazma kar table banate hain:
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import GradientBoostingClassifier
models = {
    "Logistic Regression": make_pipeline(StandardScaler(),
LogisticRegression(max_iter=2000)),
    "KNN": make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=9)),
    "SVM (rbf)": make_pipeline(StandardScaler(), SVC()),
    "Decision Tree": DecisionTreeClassifier(max_depth=4, random_state=0),
    "Random Forest": RandomForestClassifier(n_estimators=200, random_state=0, n_jobs=-1),
    "Gradient Boosting": GradientBoostingClassifier(random_state=0),
}
rows = []
for name, m in models.items():
    s = cross_val_score(m, bc.data, bc.target, cv=StratifiedKFold(5, shuffle=True,
random_state=1), scoring="roc_auc")
    rows.append((name, s.mean(), s.std()))
table = pd.DataFrame(rows, columns=["Model", "ROC-AUC mean", "std"]).sort_values("ROC-AUC
mean", ascending=False)
print(table.round(3).to_string(index=False))
OUTPUT
              Model  ROC-AUC mean   std
Logistic Regression         0.995 0.005
          SVM (rbf)         0.995 0.004
  Gradient Boosting         0.990 0.006
      Random Forest         0.989 0.007
                KNN         0.983 0.015
      Decision Tree         0.926 0.039
plt.figure(figsize=(7.5, 3.8))
plt.barh(table["Model"], table["ROC-AUC mean"], xerr=table["std"], color="#6B5B95",
capsize=4)
plt.xlim(0.9, 1.0)
plt.gca().invert_yaxis()
plt.xlabel("ROC-AUC (5-fold CV)")
plt.title("Models ka muqabla")
plt.show()
OUTPUT (chart)
19.6 Class Imbalance ka tareeqa
Jab ek class bohat kam ho (fraud, bimari), to accuracy dhoka deti hai (Chapter 14). Madadgar tareeqay: class_weight="balanced" , metrics jaise F1/recall/ROC-AUC/PR-AUC , aur threshold tuning .
from sklearn.datasets import make_classification
from sklearn.metrics import recall_score, precision_score
Xi, yi = make_classification(n_samples=3000, n_features=10, weights=[0.95, 0.05],
random_state=0)
print("Class hissa:", np.bincount(yi) / len(yi))
Xi_tr, Xi_te, yi_tr, yi_te = train_test_split(Xi, yi, test_size=0.3, random_state=0,
stratify=yi)
for cw in [None, "balanced"]:
    m = LogisticRegression(class_weight=cw, max_iter=1000).fit(Xi_tr, yi_tr)
    p = m.predict(Xi_te)
    print(f"class_weight = {str(cw):9s} | accuracy = {m.score(Xi_te, yi_te):.3f} | recall =
{recall_score(yi_te, p):.3f} | precision = {precision_score(yi_te, p):.3f}")
OUTPUT
Class hissa: [0.946 0.054]
class_weight = None      | accuracy = 0.966 | recall = 0.449 | precision = 0.846
class_weight = balanced  | accuracy = 0.884 | recall = 0.837 | precision = 0.299
class_weight="balanced" lagane par recall (chhoti class ke kitne pakde) 0.45 se barh kar 0.84 ho gaya, magar accuracy 0.966 se 0.884 aur precision 0.85 se 0.30 tak gir gayi (bohat saray jhoote alarm). Ye wohi precision aur recall ka sauda hai (Chapter 14). Fraud jaisi surat me jahan chhoot jana mehnga ho wahan recall zyada ahem hai,
magar jhoote alarm ki bhi qeemat hoti hai, isliye dono ka tawazun business ke hisaab se chuna jata hai. Aur tareeqay: oversampling (SMOTE, imbalanced-learn library) aur undersampling .
19.7 Model ko save aur load karna
Training ke baad model ko file me save karte hain taake dobara train na karna paray aur app (FastAPI, Streamlit) me istemal ho sake.
import joblib, os
best_model = gs.best_estimator_            # poori Pipeline (scaler + KNN)
joblib.dump(best_model, "best_model.joblib")
print("File ban gayi:", os.path.exists("best_model.joblib"), "| size (KB):",
round(os.path.getsize("best_model.joblib") / 1024, 1))
loaded = joblib.load("best_model.joblib")
print("Load shuda model ki accuracy:", round(loaded.score(X_test, y_test), 3))
OUTPUT
File ban gayi: True | size (KB): 105.9
Load shuda model ki accuracy: 0.951
AAM GALTIYAN
-
KNN me scaling bhool jana , ya K ko zid se 1 ya bohat bara rakhna.
-
Test set par tuning karna aur phir usi test score ko aakhri nateeja samajhna.
-
Scaler/PCA ko Pipeline ke bahar poore data par fit karna (leakage).
-
Sirf ek split ke nateeje par bharosa karna. Cross-validation use karo.
-
Bohat bara grid chala dena. Pehle RandomizedSearchCV se ranges chhoti karo.
-
Time series me shuffle karna.
-
Tuning par bohat waqt lagana jabke data ya features kharab hon. Data ki behtari tuning se zyada kaam aati hai.
19.8 Hands-on
-
KNN: wine dataset (load_wine) par K = 1 se 25 tak CV accuracy ka graph banao aur behtareen K batao. Scaling ke baghair bhi try karo.
-
Distance: KNN me metric="manhattan" aur "euclidean" compare karo.
-
Learning curve: wine par Logistic Regression aur Random Forest ki learning curve banao. Kisko mazeed data chahiye?
-
GridSearch: wine par Random Forest (n_estimators, max_depth) ka GridSearchCV chalao. best_params_ aur test score likho.
-
Pipeline + save: wine ke liye Pipeline (StandardScaler + SVC) banao, GridSearch karo, aur best model ko joblib se save aur load karke check karo.
-
Sochne wala sawal: agar kisi customer ka data bohat kam (500 rows) ho to kaunsi tuning strategy chunogi aur kyun?
from sklearn.datasets import load_wine
wine = load_wine()
w_tr, w_te, wy_tr, wy_te = train_test_split(wine.data, wine.target, test_size=0.25,
random_state=0, stratify=wine.target)
for name, m in [("KNN (raw)", KNeighborsClassifier()), ("KNN (scaled)",
make_pipeline(StandardScaler(), KNeighborsClassifier()))]:
    print(f"{name:14s} CV accuracy = {cross_val_score(m, w_tr, wy_tr, cv=5).mean():.3f}")
OUTPUT
KNN (raw)      CV accuracy = 0.721
KNN (scaled)   CV accuracy = 0.940
KEY TAKEAWAYS
-
KNN: naye nuqtay ke K sab se qareebi padosiyon ka vote (classification) ya average (regression). Lazy learner, scaling zaroori.
-
K = 1 overfit (ghumavdar), K bohat bara underfit. K cross-validation se chuno (aam taur par taaq number).
-
Cross-validation (Stratified K-Fold) ek split se zyada bharosay ki parakh. Time series me TimeSeriesSplit.
-
Learning curve batati hai underfit hai, overfit hai ya mazeed data madad karega. Validation curve ek hyperparameter ka asar dikhata hai.
-
GridSearchCV har milap aazmata hai, RandomizedSearchCV random n_iter milap. Test set sirf aakhri ek parakh ke liye.
-
Pipeline (preprocessing + model) leakage rokti hai aur save/load ko asaan banati hai. step__parameter se tuning.
-
Imbalanced data: class_weight, F1/recall/ROC-AUC. Model ko joblib se save karo (poori Pipeline).