Chapter 17: Dimensionality Reduction aur PCA
MODULE 4 | WEEK 17
Chapter 17: Dimensionality Reduction aur PCA
Asli data me aksar bohat saray columns (features) hote hain: ek tasveer me hazaron pixels, ek patient ke saikron tests, ek text me hazaron alfaz. Zyada features ka matlab hamesha zyada behtar nahi hota. Dimensionality Reduction columns ki tadaad kam karti hai aur zaroori maloomat bachati hai. Sab se mashhoor tareeqa PCA (Principal Component Analysis) hai.
17.1 Zyada features ka masla
Zyada features ke nuqsan
-
Overfitting ka khatra: kam samples aur zyada features me model data ko ratta maar leta hai.
-
Slow training aur zyada memory.
-
Doori par mabni algorithms (KNN, K-Means, SVM) kharab ho jate hain, kyunke zyada dimensions me sab nuqtay lagbhag ek jitni door lagte hain.
-
Visualize nahi kar sakte: hum sirf 2D ya 3D dekh sakte hain.
-
Kai features aapas me judte (correlated) hote hain, yani ek jaisi maloomat bar bar.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
# Dimensions barhane par random nuqton ke darmiyan doori ka farq mit jata hai
rng = np.random.RandomState(0)
for d in [2, 10, 100, 1000]:
    pts = rng.uniform(0, 1, size=(200, d))
    dists = np.sqrt(((pts[:1] - pts[1:]) ** 2).sum(axis=1))
    print(f"{d:>4} dimensions: sab se qareeb / sab se door = {dists.min() /
dists.max():.2f}")
OUTPUT
   2 dimensions: sab se qareeb / sab se door = 0.04
  10 dimensions: sab se qareeb / sab se door = 0.34
 100 dimensions: sab se qareeb / sab se door = 0.77
1000 dimensions: sab se qareeb / sab se door = 0.91
Jab ratio 1 ke qareeb ho jaye to "qareeb" aur "door" ka farq hi khatam ho gaya. Isi liye KNN jaise models zyada dimensions me kharab chalte hain.
17.2 PCA ka idea
PCA data ko nayi axes (principal components) par ghumata hai, aisi ke:
-
Pehli axis (PC1) wo simt hai jis me data sab se zyada phailta (variance) hai.
-
Doosri axis (PC2) pehli ke perpendicular (90 degree) hai aur baqi bache hue phailao me se sab se zyada pakadti hai, aur isi tarah aage.
-
Phir hum sirf pehli kuch axes rakh lete hain aur baqi chhor dete hain: columns kam, maloomat zyada tar mehfooz.
OUTPUT (chart)
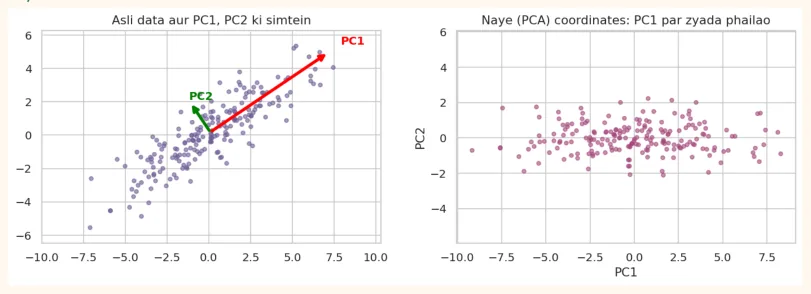
PC1 (surkh) data ke sab se lambay phailao ki simt me hai. Agar hum PC2 chhor dein aur sirf PC1 rakhein to 2 columns se 1 column reh jata hai, aur zyada tar maloomat bach jati hain.
17.3 PCA ke steps (andar kya hota hai)
-
Standardize: har feature ko scale karo (mean 0, std 1). PCA phailao (variance) par chalta hai, isliye scaling zaroori hai.
-
Covariance matrix nikalo (features ek doosre ke saath kaise badalte hain).
-
Us ke eigenvectors (simtein) aur eigenvalues (har simt me kitna phailao) nikalo.
-
Eigenvalues ko bare se chhote ki tarteeb me lagao. Sab se bari wali simt PC1 hai.
-
Pehle k eigenvectors chuno aur data ko un par project karo. Ab data k columns ka reh gaya.
from sklearn.preprocessing import StandardScaler
# Hath se PCA (2 features par) aur sklearn se muqabla
Z = StandardScaler().fit_transform(pts)
cov = np.cov(Z.T)
eigvals, eigvecs = np.linalg.eigh(cov)
order = np.argsort(eigvals)[::-1]
eigvals, eigvecs = eigvals[order], eigvecs[:, order]
print("Eigenvalues:", eigvals.round(3))
print("Phailao ka hissa:", (eigvals / eigvals.sum()).round(3))
p = PCA(n_components=2).fit(Z)
print("sklearn explained_variance_ratio_:", p.explained_variance_ratio_.round(3))
OUTPUT
Eigenvalues: [1.876 0.134]
Phailao ka hissa: [0.933 0.067]
sklearn explained_variance_ratio_: [0.933 0.067]
Dono tareeqon ke jawab ek hi hain. Yani sklearn ka PCA andar se yehi hisaab karta hai.
17.4 scikit-learn me PCA: Iris ka misaal
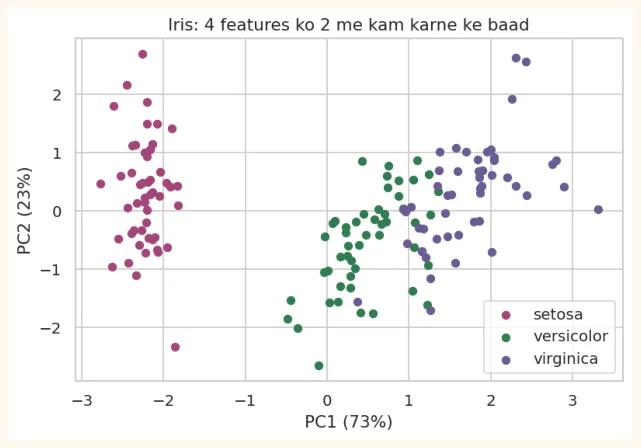
Iris ke 4 features ko 2 me kam kar ke 2D chart me dekhte hain:
from sklearn.datasets import load_iris
from sklearn.pipeline import make_pipeline
iris = load_iris(as_frame=True)
X, y = iris.data, iris.target
print("Asli shape:", X.shape)
pipe = make_pipeline(StandardScaler(), PCA(n_components=2))
X2 = pipe.fit_transform(X)
print("PCA ke baad shape:", X2.shape)
pca_iris = pipe[-1]
print("Har component ka phailao:", pca_iris.explained_variance_ratio_.round(3))
print("Dono ka jama:", pca_iris.explained_variance_ratio_.sum().round(3))
OUTPUT
Asli shape: (150, 4)
PCA ke baad shape: (150, 2)
Har component ka phailao: [0.73  0.229]
Dono ka jama: 0.958
Sirf 2 components ne phailao ka lagbhag 96% pakad liya, yani 4 columns ko 2 me badal kar sirf 4% maloomat khoyi. Ab hum is ko plot kar sakte hain:
plt.figure(figsize=(7, 4.4))
for cls, color in zip([0, 1, 2], ["#A4457A", "#2F7D4F", "#6B5B95"]):
    mask = (y == cls).values
    plt.scatter(X2[mask, 0], X2[mask, 1], color=color, label=iris.target_names[cls], s=28)
plt.xlabel(f"PC1 ({pca_iris.explained_variance_ratio_[0] * 100:.0f}%)")
plt.ylabel(f"PC2 ({pca_iris.explained_variance_ratio_[1] * 100:.0f}%)")
plt.title("Iris: 4 features ko 2 me kam karne ke baad")
plt.legend()
plt.show()
OUTPUT (chart)
Components kya hain? (loadings)
Har principal component asal features ka ek milap (combination) hai. components_ batata hai kis feature ka us me kitna wazan hai:
loadings = pd.DataFrame(pca_iris.components_, columns=X.columns, index=["PC1", "PC2"])
print(loadings.round(2))
OUTPUT
     sepal length (cm)  sepal width (cm)  petal length (cm)  \
PC1               0.52             -0.27               0.58
PC2               0.38              0.92               0.02
     petal width (cm)
PC1              0.56
PC2              0.07
PC1 me petal length, petal width aur sepal length ka wazan musbat aur bara hai, yani PC1 ek tarah ka "phool ka size" hai. Isi liye chart me PC1 par species saaf alag nazar aati hain.
17.5 Kitne components chunein?
Explained variance ratio batati hai ke har component ne kitna phailao (maloomat) pakda. Do tareeqay:
-
Cumulative variance: itne components rakho ke jama phailao 95% (ya 90%) ho jaye.
-
Scree plot: variance ka graph, jahan kohni (elbow) aaye wahan ruk jao.
full = make_pipeline(StandardScaler(), PCA()).fit(X)       # sab components
ratios = full[-1].explained_variance_ratio_
print("Har component:", ratios.round(3))
print("Cumulative   :", ratios.cumsum().round(3))
OUTPUT
Har component: [0.73  0.229 0.037 0.005]
Cumulative   : [0.73  0.958 0.995 1.   ]
Aap PCA ko seedha bata bhi sakte ho ke 95% variance chahiye aur wo khud components ki tadaad chun leta hai:
auto = make_pipeline(StandardScaler(), PCA(n_components=0.95)).fit(X)
print("95% ke liye components:", auto[-1].n_components_)
OUTPUT
95% ke liye components: 2
17.6 PCA bade data par: Digits (64 features)
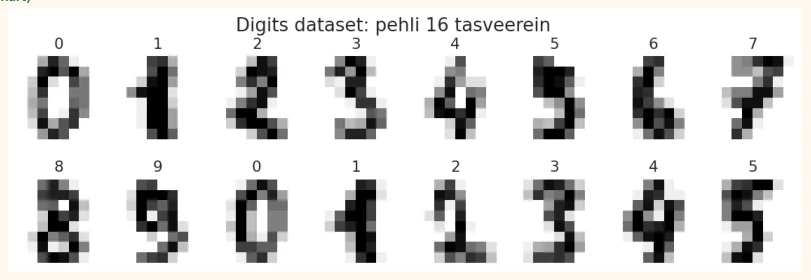
Digits dataset: haath se likhe hue 0 se 9 ke 1,797 images, har image 8 x 8 = 64 pixels (yani 64 features).
from sklearn.datasets import load_digits
digits = load_digits()
Xd, yd = digits.data, digits.target
print(Xd.shape, "| pixel range:", Xd.min(), "se", Xd.max())
OUTPUT
(1797, 64) | pixel range: 0.0 se 16.0
fig, axes = plt.subplots(2, 8, figsize=(11, 3.2))
for i, ax in enumerate(axes.ravel()):
    ax.imshow(digits.images[i], cmap="gray_r")
    ax.set_title(digits.target[i])
    ax.axis("off")
plt.suptitle("Digits dataset: pehli 16 tasveerein")
plt.show()
OUTPUT (chart)
64 columns ko 2 me kam kar ke dekhna
from sklearn.decomposition import PCA
Xd2 = PCA(n_components=2).fit_transform(Xd)
plt.figure(figsize=(7.5, 5.2))
sc = plt.scatter(Xd2[:, 0], Xd2[:, 1], c=yd, cmap="tab10", s=10)
plt.colorbar(sc, label="Digit")
plt.xlabel("PC1")
plt.ylabel("PC2")
plt.title("Digits: 64 dimensions ko 2D me")
plt.show()
OUTPUT (chart)
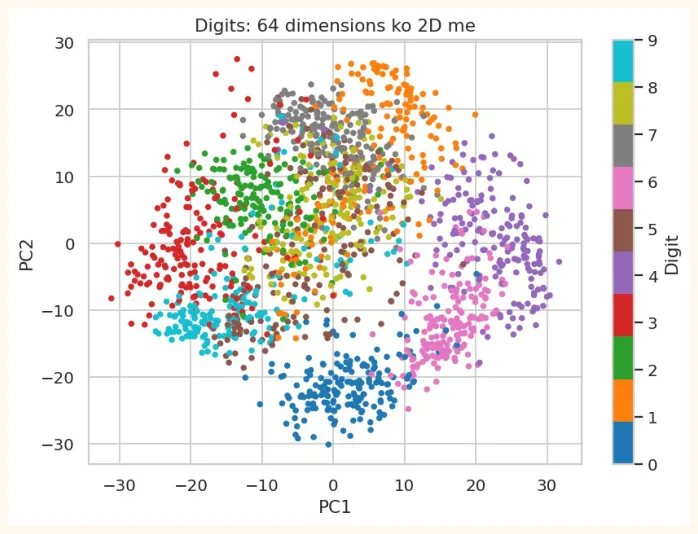
Sirf 2 axes me bhi zyada tar digits alag guroohon me nazar aate hain (kuch overlap hai). Ye 64 dimensions ka data ek tasveer me dikhane ka kamal ka tareeqa hai.
pca_full = PCA().fit(Xd)
cum = pca_full.explained_variance_ratio_.cumsum()
for target in [0.80, 0.90, 0.95, 0.99]:
    print(f"{int(target * 100)}% variance ke liye components: {int(np.argmax(cum >= target))
+ 1}")
OUTPUT
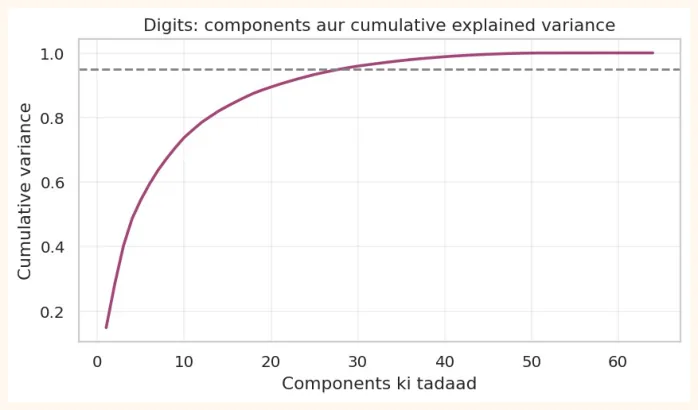
80% variance ke liye components: 13
90% variance ke liye components: 21
95% variance ke liye components: 29
99% variance ke liye components: 41
plt.figure(figsize=(7.5, 3.8))
plt.plot(range(1, 65), cum, color="#A4457A", linewidth=2)
plt.axhline(0.95, color="gray", linestyle="--")
plt.title("Digits: components aur cumulative explained variance")
plt.xlabel("Components ki tadaad")
plt.ylabel("Cumulative variance")
plt.grid(alpha=0.3)
plt.show()
OUTPUT (chart)
17.7 PCA se Compression aur Reconstruction
PCA se data chhota kiya ja sakta hai, aur phir wapas (inverse_transform) bara bhi, magar thori maloomat khoyi hui hogi. Dekho kitne components par digit pehchana jata hai:
sample = Xd[:6]
fig, axes = plt.subplots(5, 6, figsize=(8.5, 7.5))
rows = [("Asli (64)", None), ("30 comp.", 30), ("15 comp.", 15), ("8 comp.", 8), ("3 comp.",
3)]
for r, (name, n) in enumerate(rows):
    if n is None:
        recon = sample
    else:
        p = PCA(n_components=n).fit(Xd)
        recon = p.inverse_transform(p.transform(sample))
    for c in range(6):
        axes[r, c].imshow(recon[c].reshape(8, 8), cmap="gray_r")
        axes[r, c].axis("off")
    axes[r, 0].set_title(name, loc="left", fontsize=9)
plt.tight_layout()
plt.show()
OUTPUT (chart)
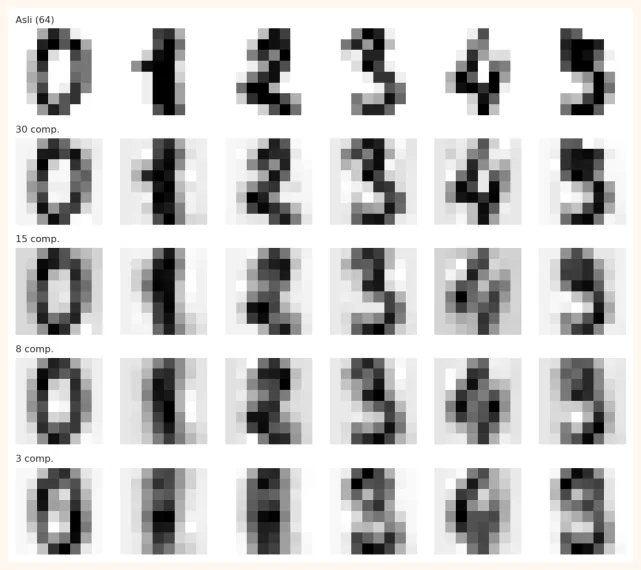
30 components par tasveer lagbhag asli jaisi hai (aadhe se bhi kam columns), 15 par bhi parhne ke qabil, 3 par bohat dhundli. Is se andaza hota hai ke data me maloomat zyada tar kuch hi simton me hain.
17.8 PCA ko model se pehle lagana
PCA ko ek preprocessing step ke tor par model se pehle Pipeline me laga sakte hain. Is se training tez aur kabhi kabhi model behtar (kam overfit) hota hai.
from sklearn.model_selection import cross_val_score, train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
import time
Xtr, Xte, ytr, yte = train_test_split(Xd, yd, test_size=0.25, random_state=0, stratify=yd)
for name, pipe in [
    ("KNN, 64 features    ", make_pipeline(StandardScaler(), KNeighborsClassifier())),
    ("PCA(95%) + KNN      ", make_pipeline(StandardScaler(), PCA(n_components=0.95),
KNeighborsClassifier())),
    ("PCA(10) + KNN       ", make_pipeline(StandardScaler(), PCA(n_components=10),
KNeighborsClassifier())),
]:
    t = time.time()
    pipe.fit(Xtr, ytr)
    acc = pipe.score(Xte, yte)
    print(f"{name} accuracy = {acc:.3f} | waqt = {time.time() - t:.3f}s")
OUTPUT
KNN, 64 features     accuracy = 0.973 | waqt = 0.010s
PCA(95%) + KNN       accuracy = 0.969 | waqt = 0.013s
PCA(10) + KNN        accuracy = 0.916 | waqt = 0.016s
17.9 PCA ki hadood aur t-SNE ki jhalak
| PCA ke fayde | PCA ki hadood |
|---|---|
| Tez, saada, mazboot | Sirf**seedhi (linear)**rishton ko pakadta hai |
| Correlated features hata deta hai | Components ka matlab samajhna mushkil (original features ka milap) |
| Visualization aur compression | Scaling par bohat depend karta hai |
| Noise kam karne me madadgar | Zyada phailao hamesha zyadakaam kimaloomat nahi hota |
| Overfitting kam | Outliers phailao ko bigaad dete hain |
Jab data me ghumavdar (non-linear) structure ho, to PCA kamzor hai. Wahan t-SNE aur UMAP jaise algorithms zyada achhe visualization dete hain. t-SNE sirf dekhne ke liye hai (naye data par transform nahi karta), aur uski chhoti chhoti doori par bharosa kar sakte hain, bari doori par nahi.
from sklearn.manifold import TSNE
tsne = TSNE(n_components=2, random_state=0, init="pca",
perplexity=30).fit_transform(Xd[:1000])
plt.figure(figsize=(7.5, 5.2))
sc = plt.scatter(tsne[:, 0], tsne[:, 1], c=yd[:1000], cmap="tab10", s=10)
plt.colorbar(sc, label="Digit")
plt.title("t-SNE: digits ke guroohon ki behtar tasveer (1000 samples)")
plt.show()
OUTPUT (chart)
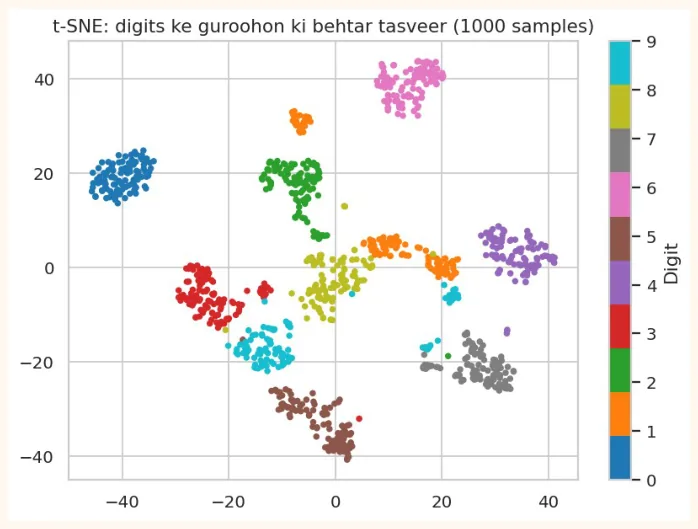
t-SNE me digits zyada saaf alag guroohon me nazar aate hain, PCA ke muqable me. Magar t-SNE slow hai, aur uske axes ka koi seedha matlab nahi.
AAM GALTIYAN
-
PCA se pehle scaling na karna . Bari scale wala feature saari phailao hadap leta hai.
-
PCA ko poore data par fit karna (train/test se pehle). Ye leakage hai.
-
Samajhna ke PCA features chun'ta hai. Wo naye features banata hai (purane ka milap).
-
Zyada components rakhna (maqsad hi kam karna tha) ya bohat kam rakhna (zaroori maloomat khona).
-
Categorical columns par seedha PCA lagana.
-
t-SNE ke clusters ko asli groups ka saboot samajhna. Ye sirf visualization ka tool hai.
17.10 Hands-on
from sklearn.datasets import load_breast_cancer
bc = load_breast_cancer(as_frame=True)
Xb, yb = bc.data, bc.target
cumb = make_pipeline(StandardScaler(), PCA()).fit(Xb)[-1].explained_variance_ratio_.cumsum()
print("Breast cancer: 30 features. 95% variance ke liye components:", int(np.argmax(cumb >=
0.95)) + 1)
OUTPUT
Breast cancer: 30 features. 95% variance ke liye components: 10
-
Breast cancer: 30 features par PCA lagao, 2 components se scatter plot banao (rang = malignant / benign). Kya dono classes alag nazar aati hain?
-
Scree plot: breast cancer ke liye explained variance ka plot banao aur kohni dhoondo.
-
Pipeline: breast cancer par LogisticRegression ko (a) saray 30 features se, (b) PCA(5), (c) PCA(2) se chalao aur test accuracy compare karo.
-
Loadings: PC1 me sab se zyada wazan kin 3 features ka hai?
-
Sochne wala sawal: agar tumhein model ke faislay kisi doctor ko samjhane hon, to PCA ke baad ke features istemal karna kyun mushkil hoga?
Xb_tr, Xb_te, yb_tr, yb_te = train_test_split(Xb, yb, test_size=0.25, random_state=0,
stratify=yb)
for name, steps in [("30 features", [StandardScaler(), LogisticRegression(max_iter=2000)]),
                    ("PCA(5)     ", [StandardScaler(), PCA(5),
LogisticRegression(max_iter=2000)]),
                    ("PCA(2)     ", [StandardScaler(), PCA(2),
LogisticRegression(max_iter=2000)])]:
    m = make_pipeline(*steps).fit(Xb_tr, yb_tr)
    print(f"{name} test accuracy = {m.score(Xb_te, yb_te):.3f}")
OUTPUT
30 features test accuracy = 0.958
PCA(5)      test accuracy = 0.965
PCA(2)      test accuracy = 0.923
KEY TAKEAWAYS
-
Zyada features ke nuqsan: overfitting, slow training, doori wale algorithms ki kharabi (curse of dimensionality), visualize na kar sakna.
-
PCA nayi axes (principal components) banata hai jo sab se zyada phailao (variance) pakadti hain. PC1 sab se ahem, PC2 us ke perpendicular.
-
Steps: standardize, covariance, eigenvectors aur eigenvalues, top k chuno aur project karo. Scaling zaroori.
-
explained_variance_ratio_ se pata chalta hai har component ne kitni maloomat pakdi. PCA(n_components=0.95) khud tadaad chun leta hai.
-
PCA se visualization (Iris 4D to 2D, Digits 64D to 2D), compression aur reconstruction (inverse_transform) mumkin hai.
-
Pipeline me PCA lagao taake fit sirf train par ho. PCA sirf linear structure pakadta hai; non-linear ke liye t- SNE/UMAP (sirf visualization).