Chapter 20: End-to-End ML Project aur Case Study
MODULE 4 | WEEK 20
Chapter 20: End-to-End ML Project aur Case Study
Pichle 8 chapters me hum ne ML ke alag alag tukde seekhe. Ab sab ko ek asli, mukammal project me jodte hain: problem se le kar saved model tak . Ye wohi tareeqa hai jo asli companies me chalta hai, aur tumhare portfolio (GitHub) ka sab se behtareen project ban sakta hai.
20.1 Project: Titanic Survival Prediction
Sawal: 1912 me Titanic ke doobne par kaun bacha? Mussafiron ki maloomat (class, jins, umar, kiraya waghera) se andaza lagao ke koi mussafir bacha ya nahi . Ye binary classification hai.
Step 1: Problem definition
| Cheez | Faisla |
|---|---|
| Masla | Binary classification (survived = 1 / 0) |
| Data | Seaborn ka titanic dataset (891 mussafir) |
| Success ka paimana | Accuracy + F1-score + ROC-AUC (classes taqreeban 62 / 38 hain, to sirf accuracy kafi nahi) |
| Baseline | Hamesha "mar gaya" kehne wala model (sab se aam class) |
| Hum kyanahikarenge | Test set ko tuning me nahi chhoo'ge (leakage) |
Step 2: Data load aur inspect
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
titanic = sns.load_dataset("titanic")
print(titanic.shape)
print(titanic.dtypes.to_string())
print()
print("Missing values:")
print(titanic.isnull().sum()[titanic.isnull().sum() > 0].to_string())
OUTPUT
(891, 15)
survived          int64
pclass            int64
sex                 str
age             float64
sibsp             int64
parch             int64
fare            float64
embarked            str
class          category
who                 str
adult_male         bool
deck           category
embark_town         str
alive               str
alone              bool
Missing values:
age            177
embarked         2
deck           688
embark_town      2
deck me 688 values khali hain (77%), age me 177, embarked aur embark_town me 2. deck ko hum hata denge (itni zyada khali jagah bharna ghalat hoga).
Step 3: Leakage aur duplicate columns ki pehchan
Is dataset me kuch columns ek doosre ki nakal hain, aur ek to jawab hi hai :
print(pd.crosstab(titanic["survived"], titanic["alive"]))
print()
print("class vs pclass jaisi cheez:")
print(pd.crosstab(titanic["pclass"], titanic["class"]))
OUTPUT
alive      no  yes
survived
0         549    0
1           0  342
class vs pclass jaisi cheez:
class   First  Second  Third
pclass
1         216       0      0
2           0     184      0
3           0       0    491
-
alive ('yes' / 'no') bilkul survived jaisa hai, yani target ki nakal. Isko feature banana leakage hai: model 100% accuracy dega magar naye data par bekar.
-
class wohi hai jo pclass hai (sirf naam alag).
-
embark_town wohi hai jo embarked hai. who , adult_male sex aur age se banay hain. alone sibsp aur parch se.
SAB SE ZAROORI SAWAL
Aisa koi bhi feature jo jawab (target) ki wajah se bana ho, ya jis ki maloomat sirf baad me milti ho , leakage hai. Har feature ke liye poochho: "kya ye maloomat prediction ke waqt maujood hogi?"
cols = ["survived", "pclass", "sex", "age", "sibsp", "parch", "fare", "embarked"]
df = titanic[cols].copy()
print(df.shape)
print(df.head())
OUTPUT (891, 8) survived pclass sex age sibsp parch fare embarked 0 0 3 male 22.0 1 0 7.2500 S 1 1 1 female 38.0 1 0 71.2833 C 2 1 3 female 26.0 0 0 7.9250 S 3 1 1 female 35.0 1 0 53.1000 S 4 0 3 male 35.0 0 0 8.0500 S
Step 4: EDA (Exploratory Data Analysis)
print("Bachne ka overall hissa:", round(df["survived"].mean(), 3))
print()
print(df.groupby("sex")["survived"].mean().round(3))
print()
print(df.groupby("pclass")["survived"].mean().round(3))
OUTPUT
Bachne ka overall hissa: 0.384
sex
female    0.742
male      0.189
Name: survived, dtype: float64
pclass
1    0.630
2    0.473
3    0.242
Name: survived, dtype: float64
sns.set_theme(style="whitegrid")
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8))
sns.barplot(data=df, x="sex", y="survived", hue="sex", legend=False, ax=axes[0])
axes[0].set_title("Jins ke hisaab se bachne ka hissa")
sns.barplot(data=df, x="pclass", y="survived", hue="sex", ax=axes[1])
axes[1].set_title("Class aur jins")
sns.histplot(data=df, x="age", hue="survived", multiple="stack", bins=25, ax=axes[2])
axes[2].set_title("Umar aur nijaat")
plt.tight_layout()
plt.show()
OUTPUT (chart)
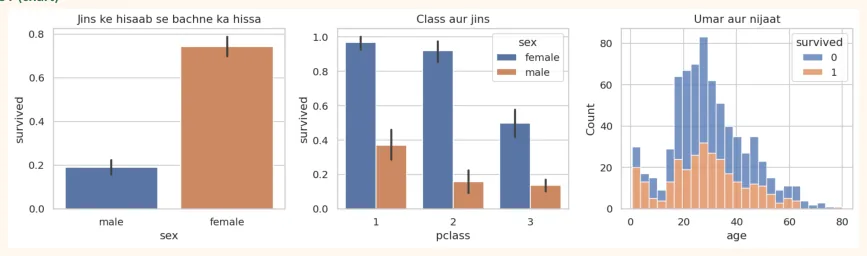
Observations: auraton ke bachne ka hissa mardon se kaafi zyada tha. Pehli class ke mussafir doosri aur teesri se zyada bache. Bachon (chhoti umar) ke bachne ka imkan zyada tha. Ye sab us waqt ke "auraton aur bachon ko pehle" usool se mel khata hai.
print("Age ka missing hissa:", round(df["age"].isnull().mean(), 3))
print("Missing age walon me bache:", round(df[df["age"].isnull()]["survived"].mean(), 3),
      "| baqi me bache:", round(df[df["age"].notnull()]["survived"].mean(), 3))
OUTPUT
Age ka missing hissa: 0.199
Missing age walon me bache: 0.294 | baqi me bache: 0.406
Jin mussafiron ki umar maloom nahi thi un me bachne ka hissa kam hai. Yani "umar missing hona" khud ek maloomat hai. Isliye imputation ke saath hum ek missing indicator bhi rakhenge (neeche).
Step 5: Feature Engineering
Maujooda columns se naye aur behtar features banana:
df["family_size"] = df["sibsp"] + df["parch"] + 1               # khud ko mila kar
df["is_alone"] = (df["family_size"] == 1).astype(int)
print(df.groupby("family_size")["survived"].agg(["mean", "count"]).round(3))
OUTPUT
              mean  count
family_size
1 0.304 537 |
|---|
2 0.553 161 |
3 0.578 102 |
4 0.724 29 |
5 0.200 15 |
6 0.136 22 |
7 0.333 12 |
8 0.000 6 |
11 0.000 7 |
Dekho: akele aur bohat bare khandan wale mussafiron ke bachne ka hissa darmiyane size (2 se 4) wale khandan se kam hai. Ye ek non-linear rishta hai, jo trees aur forests asani se pakad lete hain.
Step 6: Train/Test split aur Baseline
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyClassifier
X = df.drop(columns="survived")
y = df["survived"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42,
stratify=y)
print("Train:", X_train.shape, "| Test:", X_test.shape)
base = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
print("Baseline accuracy:", round(base.score(X_test, y_test), 3))
OUTPUT
Train: (712, 9) | Test: (179, 9)
Baseline accuracy: 0.615
Step 7: Preprocessing Pipeline
Numeric aur categorical columns ke liye alag alag steps, sab ColumnTransformer me, aur model ke saath Pipeline me:
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import make_pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
numeric = ["age", "fare", "sibsp", "parch", "family_size", "is_alone"]
categorical = ["pclass", "sex", "embarked"]
num_pipe = make_pipeline(SimpleImputer(strategy="median", add_indicator=True),
StandardScaler())
cat_pipe = make_pipeline(SimpleImputer(strategy="most_frequent"),
OneHotEncoder(handle_unknown="ignore"))
preprocess = ColumnTransformer([("num", num_pipe, numeric), ("cat", cat_pipe, categorical)])
print(preprocess.fit_transform(X_train).shape, "(rows, naye columns)")
OUTPUT
(712, 15) (rows, naye columns)
-
add_indicator=True: jin columns me values missing thin un ke liye ek 0/1 column bhi banta hai ("kya ye value missing thi?").
-
OneHotEncoder: pclass, sex, embarked ko 0/1 columns me badalta hai. handle_unknown="ignore" naye category par error se bachata hai.
-
Saray steps Pipeline ke andar hain, to leakage nahi hogi aur har CV fold me alag fit honge.
Step 8: Models ka muqabla (5-fold cross-validation)
from sklearn.model_selection import StratifiedKFold, cross_validate
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
models = {
    "Logistic Regression": LogisticRegression(max_iter=2000),
    "KNN": KNeighborsClassifier(n_neighbors=9),
    "SVM (rbf)": SVC(),
    "Random Forest": RandomForestClassifier(n_estimators=300, min_samples_leaf=3,
random_state=0, n_jobs=-1),
    "Gradient Boosting": GradientBoostingClassifier(random_state=0),
}
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
rows = []
for name, model in models.items():
    pipe = make_pipeline(preprocess, model)
    res = cross_validate(pipe, X_train, y_train, cv=cv, scoring=["accuracy", "f1",
"roc_auc"])
    rows.append((name, res["test_accuracy"].mean(), res["test_f1"].mean(),
res["test_roc_auc"].mean()))
compare = pd.DataFrame(rows, columns=["Model", "Accuracy", "F1", "ROC-
AUC"]).sort_values("ROC-AUC", ascending=False)
print(compare.round(3).to_string(index=False))
OUTPUT
              Model  Accuracy    F1  ROC-AUC
  Gradient Boosting     0.820 0.751    0.887
      Random Forest     0.815 0.741    0.878
Logistic Regression     0.803 0.733    0.856
          SVM (rbf)     0.827 0.762    0.842
                KNN     0.796 0.722    0.838
Sab models baseline (~0.62) se kaafi behtar hain. Farq kai models ke beech chhota hai, to ek saada model aur ek pecheeda model ka muqabla dekhna zaroori hai. Hum tree-based model (Random Forest ya Gradient Boosting) ko tune karenge, kyunke wo non-linear rishton ko khud seekhte hain.
Step 9: Hyperparameter Tuning
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint
pipe = make_pipeline(preprocess, RandomForestClassifier(random_state=0, n_jobs=-1))
param_dist = {
    "randomforestclassifier__n_estimators": randint(100, 400),
    "randomforestclassifier__max_depth": randint(3, 12),
    "randomforestclassifier__min_samples_leaf": randint(1, 10),
    "randomforestclassifier__max_features": ["sqrt", "log2", 0.5],
}
search = RandomizedSearchCV(pipe, param_dist, n_iter=25, cv=cv, scoring="roc_auc",
random_state=0, n_jobs=-1)
search.fit(X_train, y_train)
print("Behtareen CV ROC-AUC:", round(search.best_score_, 3))
print({k.split("__")[1]: (v if not isinstance(v, (np.integer, np.floating)) else v.item())
       for k, v in search.best_params_.items()})
OUTPUT
Behtareen CV ROC-AUC: 0.877
{'max_depth': 11, 'max_features': 'log2', 'min_samples_leaf': 4, 'n_estimators': 385}
Step 10: Aakhri Evaluation (test set par, sirf ek bar)
from sklearn.metrics import (accuracy_score, precision_score, recall_score, f1_score,
                             roc_auc_score, confusion_matrix, classification_report)
best = search.best_estimator_
pred = best.predict(X_test)
proba = best.predict_proba(X_test)[:, 1]
print("Accuracy :", round(accuracy_score(y_test, pred), 3))
print("Precision:", round(precision_score(y_test, pred), 3))
print("Recall   :", round(recall_score(y_test, pred), 3))
print("F1       :", round(f1_score(y_test, pred), 3))
print("ROC-AUC  :", round(roc_auc_score(y_test, proba), 3))
print()
print(classification_report(y_test, pred, target_names=["Mar gaya", "Bach gaya"]))
OUTPUT
Accuracy : 0.799
Precision: 0.824
Recall   : 0.609
F1       : 0.7
ROC-AUC  : 0.841
              precision    recall  f1-score   support
    Mar gaya       0.79      0.92      0.85       110
   Bach gaya       0.82      0.61      0.70        69
    accuracy                           0.80       179
   macro avg       0.81      0.76      0.77       179
weighted avg       0.80      0.80      0.79       179
from sklearn.metrics import ConfusionMatrixDisplay, roc_curve
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
ConfusionMatrixDisplay.from_predictions(y_test, pred, display_labels=["Mar gaya", "Bach
gaya"], cmap="Purples", ax=axes[0])
axes[0].set_title("Confusion Matrix (test set)")
fpr, tpr, _ = roc_curve(y_test, proba)
axes[1].plot(fpr, tpr, color="#A4457A", linewidth=2, label=f"Tuned Random Forest (AUC =
{roc_auc_score(y_test, proba):.3f})")
axes[1].plot([0, 1], [0, 1], "--", color="gray", label="Random tukka")
axes[1].set_xlabel("False Positive Rate")
axes[1].set_ylabel("True Positive Rate")
axes[1].set_title("ROC curve")
axes[1].legend(loc="lower right")
plt.tight_layout()
plt.show()
OUTPUT (chart)
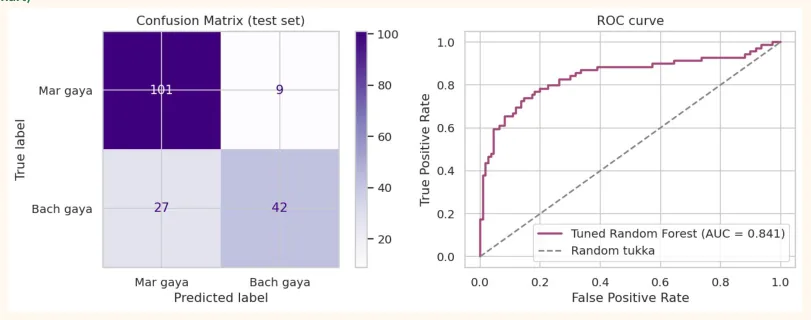
Yahan recall (Bach gaya) = 0.61 hai: jo mussafir asal me bache un me se model ne sirf 61% pakde, jab ke Mar gaya wale 92% pakde. Yani model "bachne wale" mussafiron ko chhootata zyada hai. Agar hamara maqsad bachne walon ko pehchanna hota to threshold kam karna parta (Chapter 14).
TEST VS CV
Test score aur CV score qareeb hon to ye achhi nishani hai ke model overfit nahi hua. Yahan CV ROC-AUC 0.877 aur test ROC-AUC 0.841 hai, yani thora farq hai. Sirf 179 rows ke test set me score 2 se 4 percent idhar udhar ho jata hai, isliye ye normal hai. Agar farq bohat bara hota (CV bohat achha, test bura) to leakage ya overfitting ka shak karte.
Step 11: Model ko samajhna: Permutation Importance
Kaunsa feature sab se zyada kaam aaya? Permutation importance : ek feature ke numbers ko random mix kar do aur dekho test score kitna girta hai. Jitna zyada gire, utna wo feature ahem. Ye kisi bhi model par chalta hai, aur asli (preprocess se pehle ke) columns par batata hai.
from sklearn.inspection import permutation_importance
imp = permutation_importance(best, X_test, y_test, n_repeats=15, random_state=0,
scoring="roc_auc", n_jobs=-1)
importance = pd.Series(imp.importances_mean,
index=X_test.columns).sort_values(ascending=False)
print(importance.round(3).to_string())
OUTPUT
sex            0.235
pclass         0.028
age            0.019
fare           0.009
family_size    0.007
embarked       0.003
sibsp          0.002
parch          0.002
is_alone      -0.003
importance.sort_values().plot(kind="barh", color="#6B5B95", figsize=(7, 4))
plt.title("Permutation importance (ROC-AUC me kami)")
plt.xlabel("Importance")
plt.show()
OUTPUT (chart)
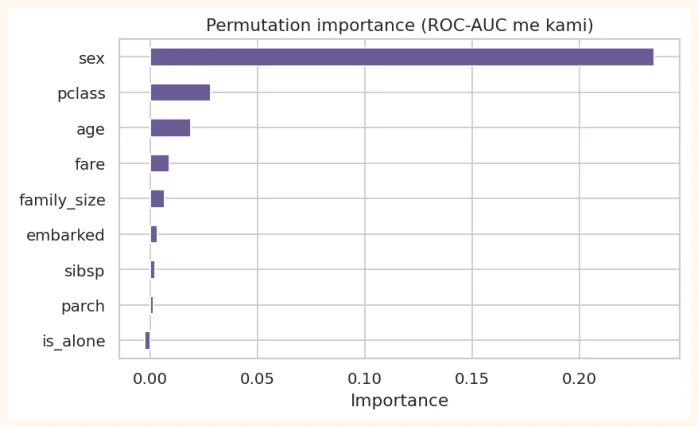
sex ka asar baqi sab features se kai guna zyada hai (0.235), uske baad pclass aur age bohat peeche. Ye wohi hai jo EDA me nazar aaya tha. Negative importance (jaise is_alone) ka matlab hai ke us feature ko mix karne se score thora behtar hua, yani wo model ke liye kaam ka nahi tha. Dhyan do: ye batata hai ke model ne kis par bharosa kiya , na ke asli wajah. (Sex ka asar us waqt ke "auraton aur bachon ko pehle" usool ki wajah se tha.)
Step 12: Error Analysis (model kahan ghalti karta hai?)
errors = X_test.copy()
errors["actual"] = y_test
errors["predicted"] = pred
errors["prob_survive"] = proba.round(2)
wrong = errors[errors["actual"] != errors["predicted"]]
print("Ghalat andaze:", len(wrong), "/", len(errors))
print("Ghalti ka hissa jins ke hisaab se:")
print(wrong["sex"].value_counts().to_string())
print()
print(wrong.sort_values("prob_survive").head(5)[["pclass", "sex", "age", "fare", "actual",
"prob_survive"]].to_string())
OUTPUT
Ghalat andaze: 36 / 179
Ghalti ka hissa jins ke hisaab se:
sex
male      24
female    12
     pclass   sex   age     fare  actual  prob_survive
444       3  male   NaN   8.1125       1          0.04
271       3  male  25.0   0.0000       1          0.06
570       2  male  62.0  10.5000       1          0.07
804       3  male  27.0   6.9750       1          0.07
17        2  male   NaN  13.0000       1          0.08
Ghaltiyon ko dekhna bohat kuch sikhata hai: kya model kisi khaas group (maslan mard jo bache, ya auratein jo nahi bachi) par zyada ghalti karta hai? Aise anokhe cases me wo hi chhupi maloomat hoti hai jo features me nahi thi, aur agle experiment ka idea wahin se milta hai.
Step 13: Model save karna aur predict function
import joblib
joblib.dump(best, "titanic_model.joblib")
model = joblib.load("titanic_model.joblib")
def predict_survival(pclass, sex, age, sibsp, parch, fare, embarked):
    sample = pd.DataFrame([{
        "pclass": pclass, "sex": sex, "age": age, "sibsp": sibsp, "parch": parch, "fare":
fare, "embarked": embarked,
        "family_size": sibsp + parch + 1, "is_alone": int(sibsp + parch == 0),
    }])
    p = model.predict_proba(sample)[0, 1]
    return round(float(p), 3), ("Bach jata" if p >= 0.5 else "Nahi bachta")
print(predict_survival(pclass=1, sex="female", age=28, sibsp=0, parch=0, fare=80,
embarked="S"))
print(predict_survival(pclass=3, sex="male", age=35, sibsp=0, parch=0, fare=8,
embarked="S"))
OUTPUT
(0.977, 'Bach jata')
(0.167, 'Nahi bachta')
Ab ye predict_survival function kisi bhi app me (FastAPI, Streamlit, ya Docusaurus book ke chatbot ke saath) istemal ho sakta hai. Deployment ka poora tareeqa Module 7 (MLOps) me aayega.
Step 14: README / Report likhna
Project GitHub par daalte waqt README.md me ye hissay likho:
-
Title aur 2 line ka khulasa: kya masla hai aur kya nateeja nikla.
-
Data: source, size, columns, aur kaunse columns kyun hataye (jaise alive, deck).
-
EDA ke 3 se 4 charts aur unse milne wali baatein.
-
Method: pipeline ka khaka (imputation, scaling, encoding), models jo aazmaye, tuning.
-
Nateeja: test set par metrics ki chhoti table, confusion matrix aur ROC ki tasveer.
-
Hadood (limitations): chhota dataset, 1912 ka data, ittefaq ka asar, kya model bias dikhata hai.
-
Chalane ka tareeqa: pip install -r requirements.txt aur notebook kaise chalayein.
-
Agla qadam: aur features, doosre models, deployment.
20.2 Mini Case Study: Regression (Diabetes progression)
Ab ek regression case dekhte hain, wohi workflow, chhota roop. Maqsad: 10 napayiyon se ek saal baad bimari ki pesh-raft ka andaza. Is dataset me features pehle se scale hain aur missing values nahi, to hamara focus models ke muqabley aur sahi paimane par hai.
from sklearn.datasets import load_diabetes
from sklearn.linear_model import Ridge, LassoCV
from sklearn.model_selection import cross_val_score, KFold
dX, dy = load_diabetes(return_X_y=True, as_frame=True)
dX_tr, dX_te, dy_tr, dy_te = train_test_split(dX, dy, test_size=0.2, random_state=42)
cv_r = KFold(n_splits=5, shuffle=True, random_state=0)
candidates = {
    "Baseline (average)": __import__("sklearn.dummy",
fromlist=["DummyRegressor"]).DummyRegressor(),
    "Linear Regression": __import__("sklearn.linear_model",
fromlist=["LinearRegression"]).LinearRegression(),
    "Ridge (alpha=0.1)": Ridge(alpha=0.1),
    "Random Forest": __import__("sklearn.ensemble",
fromlist=["RandomForestRegressor"]).RandomForestRegressor(n_estimators=300,
min_samples_leaf=5, random_state=0, n_jobs=-1),
    "Gradient Boosting": __import__("sklearn.ensemble",
fromlist=["GradientBoostingRegressor"]).GradientBoostingRegressor(n_estimators=100,
max_depth=2, learning_rate=0.05, random_state=0),
}
rows = []
for name, m in candidates.items():
    r2 = cross_val_score(m, dX_tr, dy_tr, cv=cv_r, scoring="r2").mean()
    rmse = -cross_val_score(m, dX_tr, dy_tr, cv=cv_r,
scoring="neg_root_mean_squared_error").mean()
    rows.append((name, r2, rmse))
print(pd.DataFrame(rows, columns=["Model", "CV R2", "CV
RMSE"]).round(3).to_string(index=False))
OUTPUT
             Model  CV R2  CV RMSE
Baseline (average) -0.020   78.172
 Linear Regression  0.494   54.944
 Ridge (alpha=0.1)  0.494   54.965
     Random Forest  0.411   59.146
 Gradient Boosting  0.428   58.378
Dekho: ek saada linear model pecheeda models ke barabar (ya behtar) hai. Is dataset me shor zyada hai aur samples sirf 442, is liye pecheeda models ka faida nahi. Sabaq: hamesha saade model aur baseline se shuru karo, aur tabhi pecheeda model lo jab wo wazeh behtari de.
final = Ridge(alpha=0.1).fit(dX_tr, dy_tr)
pred_d = final.predict(dX_te)
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error
print("Test R2  :", round(r2_score(dy_te, pred_d), 3))
print("Test MAE :", round(mean_absolute_error(dy_te, pred_d), 1))
print("Test RMSE:", round(np.sqrt(mean_squared_error(dy_te, pred_d)), 1))
print("Target ka std (baseline ka andaza):", round(dy_te.std(), 1))
OUTPUT
Test R2  : 0.461
Test MAE : 43.0
Test RMSE: 53.4
Target ka std (baseline ka andaza): 73.2
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].scatter(dy_te, pred_d, color="#6B5B95", alpha=0.7)
lims = [dy_te.min(), dy_te.max()]
axes[0].plot(lims, lims, "r--")
axes[0].set_xlabel("Asli")
axes[0].set_ylabel("Andaza")
axes[0].set_title("Actual vs Predicted")
axes[1].scatter(pred_d, dy_te - pred_d, color="#A4457A", alpha=0.7)
axes[1].axhline(0, color="black", linestyle="--")
axes[1].set_xlabel("Andaza")
axes[1].set_ylabel("Residual")
axes[1].set_title("Residuals")
plt.tight_layout()
plt.show()
OUTPUT (chart)
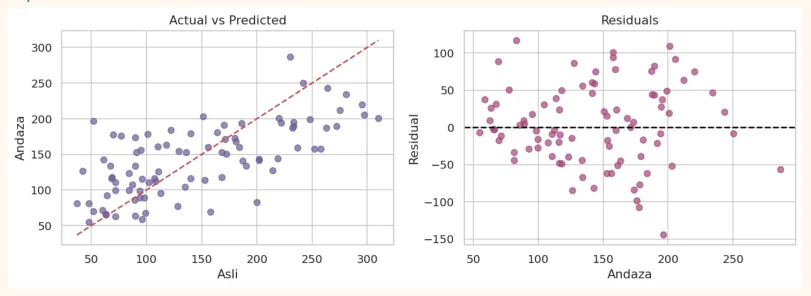
Model target ka rujhan pakadta hai magar kaafi shor bhi hai (R<sup>2</sup> darmiyana hai). Is ka matlab ye hai ke sirf in 10 napayiyon se bimari ki pesh-raft mukammal tor par predict nahi ho sakti, aur asli faisle ke liye doctor ki raye zaroori hai. Data ki hadood ko maan lena bhi ek achha data scientist hone ki nishani hai.
20.3 Poore ML Project ki Checklist
| Marhala | Poochne wale sawal |
|---|---|
| 1. Problem | Regression hai ya classification? Success ka paimana kya? Galti ki qeemat kya (FP ya FN)? Baseline kya? |
| 2. Data | Kahan se aaya? Kitna? Kya representative hai? Privacy aur bias ke masail? |
| 3. Cleaning | Missing, duplicates, outliers, ghalat types.Leakage wale columns? |
| 4. EDA | Distributions, relationships, imbalance. Kuch ajeeb? Domain knowledge se mel khata hai? |
| 5. Features | Naye features, encoding, scaling. Sirf train se fit. |
| 6. Modeling | Baseline, saade se pecheeda models, cross-validation, tuning. |
| 7. Evaluation | Sahi metrics, test set par ek bar, confusion matrix, ROC. Error analysis. |
| 8. Interpretation | Feature importance, coefficients, samajh aane wale nateeje. |
| 9. Deployment | Model + pipeline save, predict function, app/API. Monitoring. |
| 10. Documentation | README, hadood, agla qadam. Code reproducible (random_state, requirements). |
AAM GALTIYAN
-
Leakage wale columns (alive jaisa target ka duplicate) features me rakhna.
-
Test set par baar baar tuning karna.
-
Sirf accuracy dekhna aur confusion matrix / F1 / ROC-AUC chhor dena.
-
Baseline ke baghair model ko "achha" kehna.
-
Pecheeda model se shuru karna, jabke saada model kaafi hota.
-
Preprocessing ko Pipeline ke bahar karna.
-
Hadood aur bias ka zikr na karna. Ek honest README zyada qabil-e-aitbar hoti hai.
-
random_state na lagana, jis se tumhara nateeja dobara nahi aata.
20.4 Hands-on
-
Dobara banao: upar ka poora Titanic project khud type karke Colab me chalao (copy paste kam).
-
Naya feature: age ko bins me todo (bachcha, naujawan, adhed, buzurg) aur dekho test score badla ya nahi.
-
Model badlo: tuning me Gradient Boosting aazmao aur Random Forest se muqabla karo.
-
Threshold: proba par threshold 0.5 ke bajaye 0.4 aur 0.6 rakh kar precision aur recall dekho.
-
Leakage ka tajurba: 'alive' column ko feature me daal kar score dekho. Kitna "achha" aata hai aur kyun ye dhoka hai?
-
Apna project: Kaggle ya UCI ka koi chhota classification dataset chuno (jaise heart disease, customer churn) aur Step 1 se 14 tak poora kam karke GitHub par README ke saath daalo.
# Leakage ka tajurba: 'alive' ko feature banane par
leak = titanic[["pclass", "sex", "age", "fare", "alive", "survived"]].copy()
leak["alive"] = (leak["alive"] == "yes").astype(int)
leak["sex"] = (leak["sex"] == "female").astype(int)
leak["age"] = leak["age"].fillna(leak["age"].median())
Xl, yl = leak.drop(columns="survived"), leak["survived"]
Xl_tr, Xl_te, yl_tr, yl_te = train_test_split(Xl, yl, test_size=0.2, random_state=42,
stratify=yl)
print("Leakage ke saath accuracy:", round(RandomForestClassifier(random_state=0).fit(Xl_tr,
yl_tr).score(Xl_te, yl_te), 3), "(jhoota 100%)")
OUTPUT
Leakage ke saath accuracy: 1.0 (jhoota 100%)
KEY TAKEAWAYS
-
Ek mukammal ML project: problem, data, cleaning, EDA, features, split, pipeline, models, tuning, evaluation, interpretation, save, README.
-
Har feature par poochho: kya ye maloomat prediction ke waqt maujood hogi? Warna leakage (jaise 'alive' = target ki nakal).
-
Pehle baseline, phir saade se pecheeda models, cross-validation se muqabla. Saada model aksar kaafi hota hai.
-
ColumnTransformer + Pipeline numeric aur categorical preprocessing ko ek jagah samet kar leakage rokti hai.
-
Test set par sirf ek bar parakh. Metrics: accuracy, precision, recall, F1, ROC-AUC, confusion matrix.
-
Permutation importance aur error analysis model ko samajhne me madad dete hain. Hadood aur bias ko honestly likho.
-
joblib se Pipeline save karo aur predict function banao. Accha README project ko portfolio ke qabil banata hai.